云账单与 FinOps:预留、Spot、出口流量与隐形浪费
最后更新:2026-10-03
本文是产业观察的一篇。几乎所有把业务搬上云的团队,第一次认真看月度账单时都会有同一个反应:这个数字比当初 CFO 批的预算大得多,而且没人说得清钱花在了哪。上云不是省钱本身,省钱是一门需要持续投入的工程——和性能优化一样,先测量、再归因、最后优化。本文讲清云账单的钱到底怎么算、最常见的浪费藏在哪里、以及 FinOps 这套把云成本变成"可优化项"的工程方法。关于云厂商本身的格局,见 云计算简史:AWS 与阿里云;关于订阅制商业模式的另一面,见 SaaS 定价与留存经济学。
本文要回答的问题
- 云账单为什么那么难看懂?钱都流向了哪几个大类?
- 按需、预留实例、Savings Plans、Spot 四种购买方式分别打几折、代价是什么?
- 出口流量(egress)和跨可用区流量为什么常成为"账单一哥"?
- 最常见的浪费有哪些——过配、闲置、孤儿磁盘、日志爆炸各占多少?
- FinOps 的 Inform / Optimize / Operate 三阶段到底怎么落地?showback 和 chargeback 有什么区别?
一、云账单为什么难读:钱流向四个口袋
很多人以为云账单 = "EC2 实例 × 单价 × 小时数",打开真实账单才发现根本不是这么回事。以 AWS 为例,一张中等规模团队的月度账单动辄几百上千行,Cost and Usage Report(CUR,成本与用量报告)导出后能有上千万行明细。难读的根源有三个。
第一,计费维度多。 同样一台虚拟机,计算按秒/小时计费,挂的云盘按 GB-月计费,磁盘 IOPS 和吞吐再各算一笔,快照按存储量计费,IP 地址 2024 年起也开始计费。一笔"跑了一台机器"的开销会被拆成五六行。
第二,单价表本身是矩阵。 同一实例在不同 Region(地域)、不同操作系统、不同购买方式下价格不同;数据传输按方向(进/出)、按路径(同 AZ / 跨 AZ / 跨 Region / 出公网)分成完全不同的价目。
第三,折扣是"事后"应用的。 Savings Plans 的抵扣逻辑每小时重新计算,覆盖到哪台实例取决于用量形状,账单上看到的是抵扣后的净额,想还原"我到底省了多少"要自己重算。
把钱归类一下,大多数团队的云账单主要流向四个口袋:
| 口袋 | 典型占比 | 常见服务 | 特点 |
|---|---|---|---|
| 计算 | 40%-60% | EC2、ECS/EKS、Lambda | 单价透明,但购买方式决定实际折扣 |
| 存储 | 10%-25% | EBS、S3、快照 | 只增不减,冷数据热层是重灾区 |
| 网络 | 10%-30% | 出口流量、NAT 网关、跨 AZ | 最难预估、最容易失控 |
| 托管服务与其他 | 10%-30% | RDS、ElastiCache、日志监控 | 省心但单价高,日志费用常被忽视 |
网络这一项值得单独警惕:Flexera《State of the Cloud Report》连续多年调查里,"管理云支出"都是企业头号云挑战,受访者自估浪费比例常年在 27%-32% 之间。也就是说,一张 100 万的月度账单里,大约有 30 万花在了不产生任何业务价值的东西上。
二、四种购买方式:折扣换承诺,承诺换风险
计算资源是账单大头,而它的价格不是一口价,而是一个"风险-折扣"光谱。云厂商的定价逻辑很直白:你给它的承诺越确定、越长期,它给你的折扣越大;你要的灵活性越高,单价越贵。
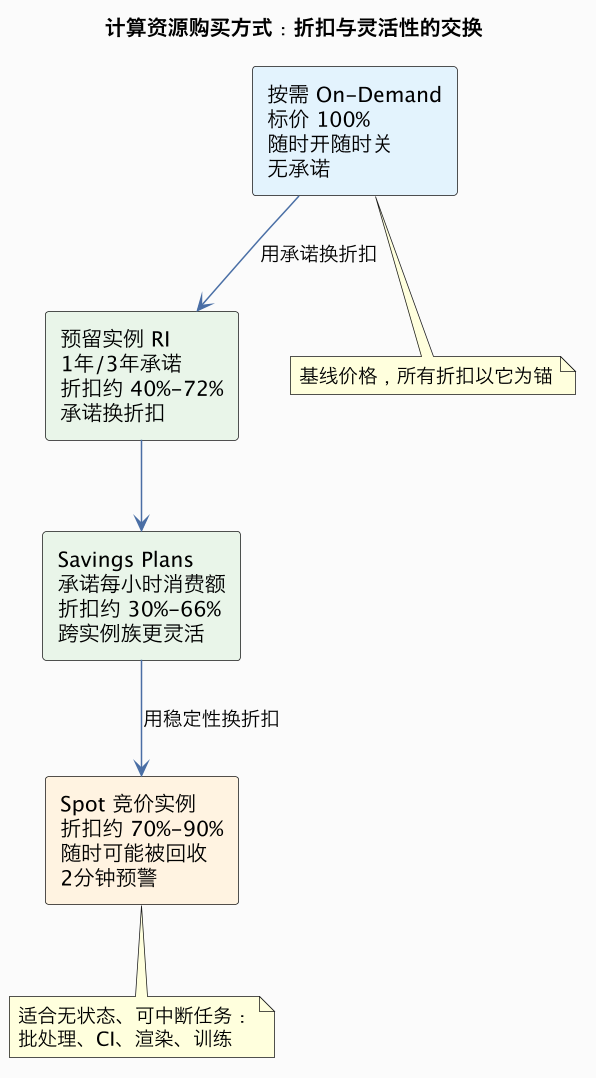
这张图要表达的核心是:四种方式不是互斥的选型,而是同一份负载的分层配方。 成熟的用法是把稳态基线用预留/Savings Plans 覆盖,波动部分走按需,可中断的批处理全部丢给 Spot。
| 购买方式 | 典型折扣 | 承诺 | 中断风险 | 适合负载 |
|---|---|---|---|---|
| 按需 On-Demand | 0%(标价) | 无 | 无 | 不可预测的尖峰、短期测试 |
| 预留实例 RI | 40%-72% | 1 年或 3 年,指定实例族/Region | 无 | 长期稳定基线(数据库、核心服务) |
| Savings Plans | 30%-66% | 承诺每小时消费额(如 $10/h),1-3 年 | 无 | 实例族会演进、想保留弹性的稳态负载 |
| Spot | 70%-90% | 无 | 有,回收前约 2 分钟预警 | 无状态批处理、CI、大数据、可重试训练 |
几个容易算错账的细节:
- RI 和 Savings Plans 是"先付款的承诺",用不满就是纯亏损。 买了 3 年全预付 RI 后业务下线,折扣越大亏得越实。FinOps 基金会建议的覆盖率通常在 70%-85%,留一部分按需应对变化,而不是追求 100% 覆盖。
- Spot 的折扣因池子而异。 热门实例族在高峰时段回收率明显上升,选型时要用 Spot 历史价格与回收率数据挑"深水池",并对任务做 checkpoint 或自动重试。
- 组合使用的数学很划算。 假设基线 60% 走 3 年 RI(约 6 折)、20% 按需、20% Spot(约 2 折),综合成本约为标价的
0.6×0.6 + 0.2×1.0 + 0.2×0.2 = 0.60,也就是整体 6 折,而纯按需是 10 折。一年 1000 万的计算账单,差的这 400 万就是 FinOps 团队的"利润"。
三、出口流量与网络费:账单里最隐蔽的一哥
如果说计算费还能靠购买方式优化,网络费就是纯靠架构设计省下来的。云厂商对网络有一个非常不对称的定价:数据进云免费,数据出云收钱。 这就是所谓的 egress(出口流量费),也被戏称为"数据重力税"——一旦数据进了云,想搬走就要付费。
量级上,AWS 公网出口流量典型单价约 $0.09/GB(前 10TB,不同 Region 有差异),阿里云、腾讯云量级相近。看起来一 GB 不到一块钱,但架不住量大:一个月向用户分发 500TB 流量的视频或下载业务,仅出口费就是 4.5 万美元级别。更隐蔽的是这些项:
- 跨可用区(AZ)流量计费。 很多人以为"同一个 Region 内部通信免费",实际上 EC2 跨 AZ 走内网也要按 GB 双向收费(典型 $0.01/GB/方向)。一个微服务调用链如果 A 服务在 az-1、B 服务在 az-2,每次 RPC 一来一回都在烧钱。部署时做拓扑亲和(同 AZ 优先路由)能直接砍掉这一笔。
- NAT 网关是双计费。 流量经过 NAT Gateway 出公网,既要按处理量付费(约 $0.045/GB),出口流量费照收。日志、镜像拉取走 NAT 的内网服务,很容易在这里堆出几千美元的月费;改用 VPC Endpoint(网关型端点对 S3/DynamoDB 免费)是标准解法。
- 托管服务之间的流量也可能计费。 跨 Region 读写、跨账号访问、从托管数据库导出数据,各有各的价目。
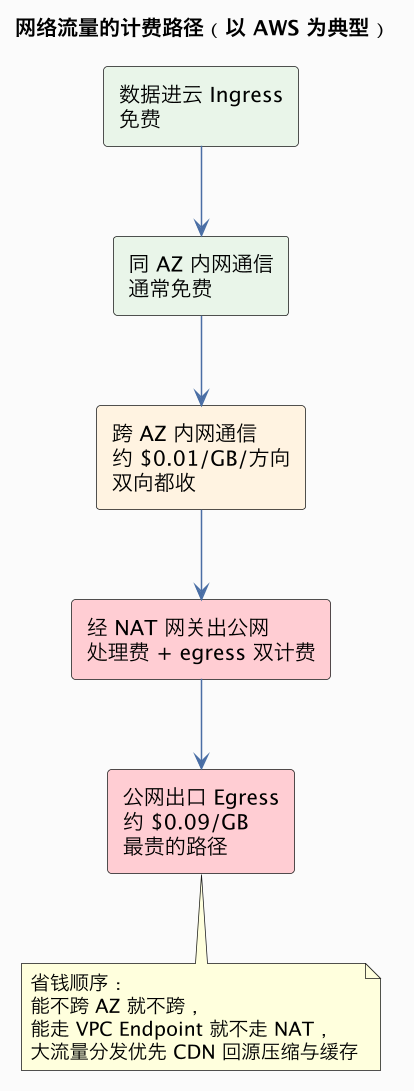
上图给出了网络费的"贵度阶梯"。工程上的启示是:网络费不是"用了多少流量"的问题,而是"流量走了哪条路径"的问题——同一个字节的成本可以相差近十倍。
四、隐形浪费清单:那 30% 是怎么烧掉的
FinOps 圈有个共识:第一轮成本优化不用任何高深技术,拿着一张"浪费清单"去对账,就能砍掉 15%-30% 的账单。这张清单上的常客是:
1. 过度配置(Over-provisioning)。 按峰值容量常驻的实例是最普遍的浪费。监控数据里 CPU 利用率常年低于 10% 的机器,在很多团队能占到实例总数的三成。Right-sizing(规格调整)就是照着真实利用率降配——8 核的机器常年只用 1 核,就换 2 核。注意内存也要看,Java 应用的堆往往配得比实际需要大一倍。
2. 闲置资源(Idle resources)。 下班时间就空跑的开发和测试环境是最典型的例子。一周 168 小时里,开发环境真正被使用的大约只有工作时间的 40-50 小时,夜间和周末自动停机可以直接省 70%。还有被遗忘的负载均衡器、没挂任何实例的弹性 IP(现在按小时计费)。
3. 孤儿磁盘与快照(Orphaned resources)。 实例删了,挂载的 EBS 卷默认保留;自动快照策略一直跑,却没人清理三年前的快照。存储费用只增不减的特性让这类浪费像滚雪球。
4. 冷数据住在热层。 S3 标准层和 Glacier 深度归档层的单价相差约 20 倍(约 $0.023 vs $0.00099/GB-月)。日志、备份、历史数据不设生命周期策略,等于用标准层的价格存"永远不会再读"的数据。
5. 日志与可观测性爆炸。 这条最容易被忽视。CloudWatch、Datadog 这类按 GB 收取日志摄入费的服务,一个 DEBUG 级别没关的服务就能把日志费打到超过计算费。有团队发现自己 Datadog 账单的一半来自一条没人看的健康检查日志。

这张对照表的要点是:每一种浪费都对应一个机械、可自动化的解法,不需要架构改造。这也是为什么"第一轮优化收益最大"——低垂的果实都挂在明面上。
五、FinOps 三阶段:Inform、Optimize、Operate
上面讲的都是单点技术,FinOps(Cloud Financial Operations,云财务运维)的价值在于把它组织成一个持续运转的闭环。FinOps 基金会定义的能力模型被概括为三个迭代阶段:Inform(知会)、Optimize(优化)、Operate(运营)。它不是一次性的"省钱项目",而是一个循环——Inform 产生可见性,可见性驱动优化,优化沉淀为日常运营,运营又产生新的数据回到 Inform。
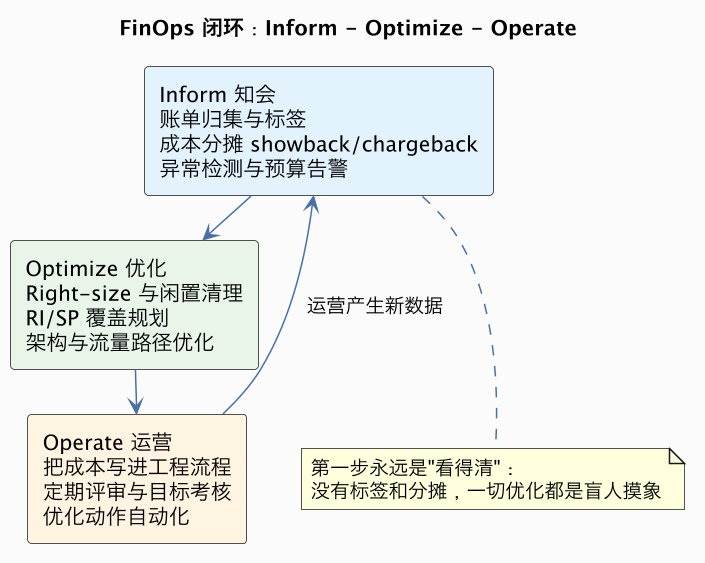
Inform 阶段的地基是标签(Tagging)和成本分摊。 云账单默认只告诉你"账号总共花了多少",但优化需要知道"哪个团队、哪个产品、哪个环境花的"。这要求所有资源带上统一的标签体系(如 team / service / env),然后用分摊规则把账单切成可归属的份额。分摊有两种力度:
| 机制 | 做法 | 效果 | 适用阶段 |
|---|---|---|---|
| Showback(成本展示) | 给每个团队出账单报告,但实际费用仍由平台/IT 统一承担 | 建立意识,团队开始关心数字 | 起步期,成本低 |
| Chargeback(成本扣回) | 费用真实计入各团队的预算或损益 | 行为改变最彻底,团队会主动优化 | 成熟期,需要财务配合 |
经验上,先做 Showback 六个月、让标签覆盖率爬到 95% 以上,再谈 Chargeback——分摊数据不准就强推 Chargeback,只会引发团队之间的扯皮。
Optimize 阶段就是第三、四节内容的工程化:Right-size、RI/SP 购买规划、闲置清理、流量路径优化、存储分层。关键动作是把"一次性大扫除"改成"按覆盖率与利用率设目标、每月滚动执行"。
Operate 阶段解决的是"怎么让优化不反弹":把成本指标放进 CI/CD(基础设施即代码变更时估算成本差)、把预算告警接到值班群、把闲置清理写成定时任务、在架构评审里加"成本影响"一栏。云成本的敌人从来不是某个大错,而是没人盯着时每天一点点漂移。
六、多云与回迁:什么时候"下云"反而更省
FinOps 的终局问题往往是:继续用云划不划算?这里要算的不是账单数字本身,而是总拥有成本(TCO)。
多云的动机通常不是省钱——恰恰相反,跨云的数据传输费会吃掉大部分账面差价。多云的真实收益是议价筹码、避免单点锁定和合规需求;把它当成省钱手段多半会失望。
**回迁自建(repatriation)**在特定条件下确实更省。最典型的参照是 37signals(Basecamp 母公司)2023 年公开的案例:把业务从 AWS 迁回自购服务器后,宣称每年节省约 700 万美元。能省钱的共同画像是:负载规模大且平稳(没有剧烈弹性需求)、团队有成熟运维能力、硬件折旧按 3-5 年摊销。反过来说,负载波动大、需要全球多 Region 快速扩张、或者运维人力紧张的公司,云的弹性溢价仍然是值的。判断方法很朴素:把云的"稳定基线部分"折算成自购硬件的三年 TCO,如果云价高出 2-3 倍以上且负载稳定,就值得认真评估回迁。
这一篇在知识体系里的位置
本文站在"产业与商业"视角看云成本,和其他篇目的分工是:
- 云计算简史:AWS 与阿里云 讲云厂商格局是怎么形成的——理解账单之前先理解你在跟谁做生意;
- SaaS 定价与留存经济学 讲订阅制怎么定价,本文讲的预留/承诺折扣本质是同一种商业逻辑的镜像:用灵活性换价格;
- 成本优化的下钻是性能工程:Right-size 要看利用率数据,而利用率从哪来、怎么分析,正是本站 观测工具 与 底层原理 各篇的主题;
- 顺着成本话题往下,推荐 AI 推理成本下降——当推理也开始按 token 计费,FinOps 的方法论正在原样搬进 AI 基础设施。
总结
云账单 FinOps 的核心不是"找便宜",而是把成本变成和性能一样的一等工程指标:先看清钱的四个口袋(计算、存储、网络、托管服务),用按需/预留/Savings Plans/Spot 的折扣光谱(约 0 折到 1-3 折)给负载分层配方,堵住出口流量、跨 AZ、NAT 网关这些网络暗渠,按清单扫掉过配、闲置、孤儿磁盘、冷数据热层、日志爆炸这五类约占三成的浪费,最后用 Inform-Optimize-Operate 的闭环和 showback/chargeback 的分摊机制让"省钱"从一次性大扫除变成持续运营——而那 30% 的行业平均浪费率,就是你做与不做的差距。