HBM 与先进封装:AI 芯片最紧的瓶颈,也是最可能先撕开的口子
最后更新:2026-09-14
本文是产业观察,回答“为什么 HBM 和先进封装突然成了 AI 时代最紧的瓶颈、国产化能不能从这里先突破”。HBM、TSV、Chiplet 的电路与工艺原理属芯片/FPGA 各工程篇,本文只讲产业结构、供应链和管制逻辑。它是另两篇的落点:设备材料国产化 讲“造芯片的机器”,国产 AI 芯片与算力管制 讲“算力需求与管制”,而先进封装正是连接二者的咽喉——AI 芯片的性能和能否出货,越来越多地不取决于那颗逻辑芯片本身,而取决于它身边的 HBM 和把它们封在一起的封装。数字来自 TrendForce/各公司财报等常见公开口径,2024 年及以前为已公布值,2025 年为量级估计,文末附口径说明。
先说结论
过去几十年,芯片产业的进步主要靠“把晶体管做小”——制程从微米一路走到纳米。但在 AI 时代,出现了两个反常识的变化:
- 瓶颈从“算”转移到了“喂”和“封”。 大芯片的逻辑单元已经足够强,真正卡住性能的是数据供给——内存带宽喂不饱算力(“内存墙”),以及能不能把计算芯片和超宽内存、把多颗小芯片高良率地封在一起。
- 价值从晶圆制造向封装转移。 在顶级 AI 芯片里,先进封装(含 HBM、2.5D 中介层、基板等)的成本占比已经超过一半,甚至直逼五六成;过去“封装是低端后道”的认知彻底过时。
这道咽喉由两种能力构成,国产化的难度却截然相反:
- HBM(高带宽内存):本质是最先进 DRAM 工艺 + TSV 三维堆叠的结合,技术、资本和良率门槛极高,主导权在 SK 海力士、三星、美光三强,且已被出口管制盯上,国产最难短期补上;
- 先进封装(CoWoS 类 2.5D/3D、Chiplet、混合键合):更多依赖成熟制程逻辑、封装 know-how 和产能,对最尖端光刻依赖低,而中国恰恰有全球规模最大、技术不弱的封测(OSAT)产业和成熟制程产能——这是整个先进半导体链条里,国产化最可能先撕开的口子。
一句话:HBM 是 AI 芯片最紧、也最难替的单一瓶颈;但“先进封装”作为一个更大的门类,是中国在先进制造受限条件下最现实的价值高地——能用成熟制程和封测优势,绕开最尖端光刻,把多颗成熟芯片封成接近先进大芯片的系统。 下面拆开。
一、先理解瓶颈:为什么“喂数据”和“封得好”突然决定了 AI 性能
1.1 内存墙:算力涨得比带宽快得多
AI 芯片的核心矛盾是:计算单元(做乘加)的速度,远快于把数据搬进搬出的速度。 大模型推理和训练要反复搬运海量参数和激活值,如果内存喂不饱,再强的计算单元也只能“饿着等数据”,利用率极低。这就是“内存墙(memory wall)”。
传统用 GDDR(显卡显存)焊在芯片四周,带宽和功耗效率都到了极限。HBM(High Bandwidth Memory,高带宽内存)换了一条路:把多层 DRAM 像盖楼一样用 TSV(硅通孔)垂直堆叠起来,再通过超宽接口(上千比特位宽、远超 GDDR 的几十位)紧贴计算芯片放置,用“离得近 + 通道极宽”换超高带宽和更低的每比特功耗。
HBM 的代际(HBM2E、HBM3、HBM3E、HBM4)主要在三件事上演进:带宽(每层翻倍级提升)、容量(堆叠层数从 8 层走向 12 层、16 层)、和与逻辑芯片的协同。一颗顶级 AI 加速器要配好几颗 HBM(H100/B200 级别通常 6~8 颗甚至更多),HBM 的供给量直接决定能装出多少张 AI 卡。
1.2 封装墙:芯片大到光刻掩膜版都放不下
另一个物理限制是光罩尺寸(reticle limit):单次光刻能曝光的最大芯片面积约 800 多平方毫米,而 AI 芯片想把更多计算单元、更大缓存塞进去,早晚会撞上这堵墙;同时,芯片面积越大,良率越低、成本指数上升(一颗大芯片上任何一处缺陷都可能废掉整片)。
出路是先进封装:与其造一颗造不出、良率低的巨型芯片,不如把多颗较小、良率更高的“芯粒(die / chiplet)”和 HBM,在封装层面重新拼成一个大系统。
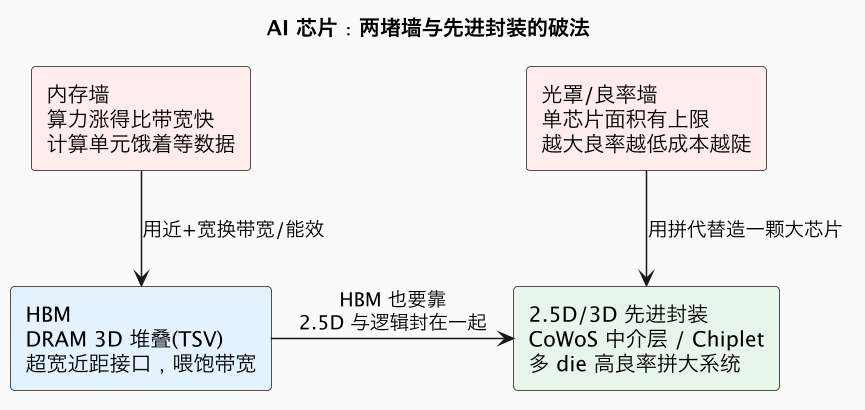
这就解释了为什么台积电的 CoWoS(Chip-on-Wafer-on-Substrate) 成了这轮周期最稀缺的产能:它是一种 2.5D 封装——把计算 die 和多颗 HBM 并排放在一块硅中介层(interposer)上,中介层里用极密的连线把它们高带宽互联,再整体落到基板上。CoWoS 产能 + HBM 供给,二者共同决定了英伟达、AMD 一年能交出多少张顶级卡。
二、HBM:最紧、最难的单一瓶颈,为什么三强垄断
HBM 看起来只是“把内存堆起来”,实际是半导体行业资本与工艺密度最高的产品之一,门槛在三个地方叠加:
- 最先进 DRAM 工艺:HBM 用的是各厂最领先的 DRAM 制程,而 DRAM 本身就是高度集中、技术迭代极快、投资极重的市场,全球长期由三家公司主导。
- TSV 与堆叠 know-how:要在晶圆上打数千个硅通孔、把 8/12/16 层 die 精确堆叠并保证良率和散热,还要在最底层放一层负责测试/控制的逻辑 die,堆叠层数每加一层,良率和散热难度都跳一档。
- 与客户的深度协同:HBM 不是标准货架件,要按英伟达、AMD、谷歌的特定需求定制并与先进封装协同验证,认证周期长。
供给格局因此极度集中:
| 厂商 | 位置 |
|---|---|
| SK 海力士(SK hynix) | AI HBM 龙头,最早大规模供 HBM3/HBM3E 给英伟达,长期占据主要份额 |
| 三星(Samsung) | 存储与代工兼具,HBM 产能巨大,但在通过最顶级客户认证上一度落后追赶 |
| 美光(Micron) | 三强中体量较小,HBM3E 放量,技术上紧追 |
HBM 市场规模随 AI 爆发快速膨胀,是存储行业里增长最快、利润最厚的部分,三强都把绝大部分新增 HBM 产能优先绑定给少数大客户。中国目前没有一家能规模量产先进 HBM 的厂商——国内 DRAM 主力(长鑫存储等)在标准 DRAM 上已站稳脚跟,但 HBM 需要的先进 DRAM 工艺、TSV 堆叠、逻辑 base die 和客户认证仍在攻关;雪上加霜的是,2024 年底起 HBM 本身及其部分关键制造设备被纳入出口管制(详见 国产 AI 芯片与算力管制),外部获取产能和设备的通道也在收紧。
HBM 是这三篇里最“硬”的单点瓶颈:它不像先进封装可以靠成熟制程和封测经验绕,本质是最先进 DRAM 能力的延伸,需要长鑫们在主流 DRAM 上继续往上爬、再叠加 TSV/封装和时间。
三、CoWoS:台积电一家独大的“第二座晶圆厂”
如果说 HBM 是芯片,那把它和 GPU 封在一起的 CoWoS 产能,是另一个被英伟达“包场”的稀缺资源。
- CoWoS 这类 2.5D 封装需要建专门的产线、占用硅中介层产能和高端 ABF 基板,扩产周期以年计、资本开支巨大,台积电的 CoWoS 产能常年被英伟达等大客户提前锁走,AMD、云厂自研芯片都要排队。
- 它模糊了“晶圆厂”和“封测厂”的边界:2.5D/3D 封装高度精密,中介层本身要走晶圆厂级别的工艺,所以晶圆厂亲自下场做先进封装(台积电 CoWoS/SoIC、三星 I-Cube、Intel EMIB/Foveros),传统封测厂反而在最顶级环节被部分绕开。
- 配套的 ABF 载板(高端封装基板)同样是寡头供给、长期紧缺,由日本揖斐电(Ibiden)、新光电气(Shinko)、中国台湾欣兴/南电等主导,是另一处隐形卡点。
这意味着,即便能造出 GPU 裸 die、买到 HBM,如果没有 CoWoS/中介层/高端载板产能,照样装不出顶级 AI 卡——封装已经从“后道配角”变成和制程同等重要的战略环节。
四、为什么先进封装反而是中国最可能先撕开的口子
讲完 HBM 和 CoWoS 的“难”,再讲一个常被忽略的结构性机会:在整个先进半导体链条里,先进封装(更广义的 2.5D/3D、Chiplet、系统级封装)是国产化相对最有条件突破的一环。 原因有三。
4.1 它对最尖端光刻依赖低,能用成熟制程
先进封装里的芯粒、中介层、I/O die,多数不需要最先进的 EUV 制程,用成熟/中端节点就能做。这正好绕开了 设备材料国产化 里最难的那堵墙。“用多颗成熟制程的 die,封装逼近一颗先进大芯片的功能”,是在先进逻辑受限条件下最现实的工程路径——单 die 不够先进,可以用更多 die、更先进的互联和封装把系统能力堆上去,代价是更大的面积、功耗和封装难度,而这些恰是可以靠封装工程优化的。
4.2 中国有全球第一梯队的封测产业
封测(OSAT,外包半导体封装测试)是中国半导体产业链里最早做强、全球份额最高、技术代差最小的环节之一:
- 长电科技(JCET)、通富微电(TFME,AMD 主要封测伙伴)、华天科技 常年位居全球 OSAT 前十,和日月光(ASE)、安靠(Amkor)同处第一梯队;
- 这些公司在 Bumping(凸块)、FC(倒装)、WLP(晶圆级封装)、2.5D/3D、Chiplet 等先进封装上持续投入,通富深度绑定 AMD 的 chiplet CPU/GPU 封装,积累了真刀真枪的大规模经验;
- 叠加中国庞大的成熟制程产能、整机和客户市场,“成熟逻辑 + 强封测 + 大市场”三者凑齐,是别的环节没有的组合优势。
4.3 Chiplet 与开放标准给了重新洗牌的窗口
Chiplet(把大芯片拆成可复用小芯粒)正在成为行业范式,而它需要标准化的 die-to-die 互联。UCIe(Universal Chiplet Interconnect Express) 等开放标准试图把“芯粒互联”做成像 USB 一样的通用规范——在标准尚未完全固化、各家刚起步时,后来者有机会参与定义,而不是像先进逻辑那样在别人定好的规则里追赶。这与 EDA 在 Chiplet/系统级新边疆的机会 是同一种逻辑:新战场并跑,比旧战场追赶容易。
4.4 但要分清“先进封装”和“HBM”两件事
需要冷静的是:中国强的是“封装”这个广义环节,不是 HBM 这个具体产品。 先进封装国产化可以走得快(2.5D、FC、chiplet 组装、系统级封装),但顶级 AI 卡需要的先进 HBM 仍高度依赖外部。现实的组合在一段时间内会是:国产/成熟逻辑 die + 国产先进封装 + 能拿到的 HBM(或用更宽的其他内存方案以带宽换代差),系统集成度和能效与最顶级方案有差距,但在推理和特定训练场景可用——这正好呼应 AI 芯片“推理先破” 的判断。
五、价值大转移:为什么一颗 AI 芯片一半以上的钱花在封装上
先进封装不只是技术路线变化,更是价值分配的重构,这对判断国产化机会极其重要。
- 在传统芯片里,晶圆制造拿走大头,封装测试只占很小比例(个位数到十几个百分点)。
- 但在顶级 AI 芯片里,BOM(物料)结构被改写:多颗昂贵的 HBM + 大尺寸硅中介层 + ABF 载板 + 复杂的 2.5D 工序,使封装相关成本占比升到 50% 以上,部分旗舰产品逼近 60%。
- 这也解释了利润流向:HBM 三强利润暴增,台积电 CoWoS 供不应求、议价权极强,高端载板厂吃紧。谁卡住“喂”和“封”,谁就在 AI 价值链里分到比单纯逻辑代工更多的钱。
对中国的含义是双重的:
- 机会:价值既然向封装迁移,而封装恰是中国相对强、且能用成熟制程做的环节,那么“把封装做到世界顶级”本身就是一条价值很高、可行性很强的路线,不必死磕最尖端光刻;
- 短板暴露:占大头的 HBM 和高端载板恰恰是最集中、最受管制的部分,价值越高,被卡时的痛感越强,这两块必须单独、长期地补。
此外,先进封装还在重塑产业边界:晶圆厂(台积电/三星/Intel)、封测厂(日月光/安靠/长电/通富)、存储厂(HBM)、基板厂,过去分工清晰,现在在 2.5D/3D 这一层正面交汇,“谁主导系统级封装”成为新的竞争焦点——这也是后来者可以借标准(UCIe)和新产能切入的洗牌期。
六、五个变量:什么能改变方程
| 变量 | 能解决什么 | 改变不了什么 | 判断 |
|---|---|---|---|
| 成熟制程 + 强封测组合 | 用 chiplet/2.5D 绕开最尖端光刻,拼出可用大系统 | HBM 仍需外部或长期攻关 | 最大、最现实的杠杆 |
| 管制倒逼 | 加速国产先进封装产能与国产 HBM 导入 | 也切断 HBM 及部分键合设备供应 | 封装净利好,HBM 短期承压 |
| OSAT 龙头 + 大客户绑定 | 长电/通富等借 AMD 等经验做大规模 chiplet 封装 | 顶级 CoWoS 式产能仍在台积电手里 | 能做出有竞争力的替代路线 |
| 国产 HBM / 3D DRAM 攻关 | 缓解最难的单点瓶颈 | 先进 DRAM + TSV + 认证以年计 | 关键但最慢,需耐心 |
| UCIe/Chiplet 标准开放 | 在未固化的新领域争取定义权 | 标准到量产生态仍需时间 | 中长期并跑机会 |
一句话收口:先进封装整体可以成为国产化的突破口和价值高地,但 HBM 这一最肥也最紧的单点,必须靠国产先进 DRAM 与 TSV 的长期攻关,无法用封装优势单独绕过。
七、差距清单与标注置信度的时间表
| 差距 | 性质 | 可压缩程度 | 主要靠谁 |
|---|---|---|---|
| FC/Bumping/WLP 等先进封装常规产能 | 制造 + 规模 | 高,已是强项 | 长电/通富/华天 |
| 2.5D/3D、Chiplet 大规模量产 | 系统封装工程 | 中高,有大客户经验 | OSAT + 芯片厂协同 |
| 高端 ABF 载板 | 材料 + 精密制程 | 中,国内在爬坡 | 基板厂 + 材料 |
| 硅中介层、混合键合(hybrid bonding) | 晶圆级精密工艺 | 中,需设备与工艺积累 | 晶圆厂 + 设备厂 |
| 先进 HBM(HBM3/3E 级量产) | 先进 DRAM + TSV | 低,三强壁垒 + 管制 | 存储厂长期攻关 |
| HBM4/3D 堆叠与客户认证 | 最前沿协同 | 最低 | 全栈 + 大客户绑定 |
带置信度的判断:
- 未来 2~3 年(高置信度):国产 2.5D、Chiplet、高密度 FC 封装在国内 AI、CPU、网络芯片上规模化应用,长电/通富等承接更多 chiplet 订单;成熟制程 + 先进封装的“国产 AI 大芯片”路线在推理市场跑通;国产 ABF 载板、混合键合设备取得份额。
- 未来 3~5 年(中高置信度):国产先进封装在能力和产能上进入世界第一梯队,成为不依赖最尖端光刻的系统集成主路径;国产 HBM 在较成熟代际(HBM2E/早期 HBM3 水平)实现规模量产并上国产卡,先进代际仍有差距。
- 未来 5~10 年(中置信度):国产 HBM 追到与主流相差一代以内,配合国产封装形成“可自给关键部分”的 AI 算力硬件闭环;在 UCIe/Chiplet 标准与生态里拥有实质话语权。
- 长期 / 低置信度:在 HBM 最前沿(HBM4+、3D 堆叠)与 CoWoS 级顶级产能上全面对等,取决于国产先进 DRAM、混合键合设备、整体设备材料 进度。和其他两篇一样,天花板最终仍由最底层的先进制造能力决定,只是封装这条线让“受限条件下仍能做出高价值系统”成为可能。
八、对不同角色,这意味着什么
- 对芯片设计公司:把先进封装当成架构设计的一等公民——从一开始就按 chiplet、die-to-die 互联、HBM/内存方案协同设计,而不是设计完再找封装;在先进逻辑受限时,用“成熟多 die + 强封装”换系统性能,是现实选择,与 12 多 FPGA 分区算法 割集/容量/图划分 是相通的工程思想。
- 对封测厂(OSAT):这是历史性的价值上移窗口。从“后道代工”升级为“系统级集成方案商”,绑定 AI/CPU 大客户、投 2.5D/3D 与混合键合产能、向上游晶圆级工艺延伸,是决定未来十年身位的关键。
- 对存储厂:HBM 是必争之地但急不得,先在标准 DRAM 做到主流、再叠加 TSV/堆叠和逻辑 base die,绑定国产 AI 客户做长期验证;避免在落后代际盲目铺产能。
- 对政策与投资:先进封装是“投入产出比最高、能绕开最尖端光刻”的战略方向,值得优先布局产能、材料(载板、键合)和标准;同时认清 HBM 是慢变量,需给国产 DRAM 长周期耐心资本,防止只封不存、关键件仍被卡。
结语:最紧的瓶颈,和最现实的口子,是同一个故事的两面
AI 时代,价值和瓶颈一起从“把晶体管做小”转向“把数据喂饱、把系统封好”。HBM 与先进封装既是这轮算力最紧的咽喉,也照出国产化的两种处境:
- HBM 一面:是最先进 DRAM、TSV 堆叠和客户认证叠出来的硬骨头,三强垄断又逢管制,是必须长期补、绕不过去的单点;
- 先进封装一面:依赖成熟制程、考验封测 know-how,而中国恰有全球第一梯队的 OSAT 和庞大成熟产能,加上 Chiplet/UCIe 标准未定,是整个先进半导体链条里最可能先撕开、且价值正在快速上升的口子。
所以现实的画像是:用成熟制程的多颗 die + 世界水平的先进封装,拼出不依赖最尖端光刻的高价值系统;HBM 先用可得供给支撑推理与特定场景,同时以十年决心补国产先进 DRAM。 它不能让中国一夜之间拥有最顶级的单芯片,但能让中国在先进逻辑受限的条件下,依然造出有竞争力的 AI 系统——这,或许比单纯追赶某一个制程节点,更具战略分量。
数据口径与延伸
- 数据口径:先进封装在顶级 AI 芯片成本占比过半(部分旗舰逼近 60%)、HBM 三强格局(SK 海力士领先、三星/美光追赶)、CoWoS 产能紧缺与大客户锁定、HBM 代际(HBM2E/HBM3/HBM3E/HBM4)与堆叠层数(8→12→16 层)、OSAT 全球份额排名等,来自 TrendForce、各公司财报与行业研究的常见公开口径;具体占比随产品(GPU/HBM 数量、基板价格)和周期波动很大,本文统一采用区间与量级表述。2024 年及以前为已公布值,2025 年为量级估计,管制细节以官方原文为准。
- 相关产业观察:半导体设备与材料国产化(地基与机器)、国产 AI 芯片与算力管制(需求与管制)、国产 EDA 的真实处境(Chiplet 新边疆的软件侧)、中国芯片设计公司三十年。
- 工程背景:12 多 FPGA 分区算法 割集/容量/图划分、13 跨 FPGA 互联与 TDM SerDes/跨片同步/降频(“用多颗拼系统”的同源工程思想)、片上存储器/Cache。
一句话总结:AI 把芯片的主战场从“做小晶体管”推向“喂饱数据、封好系统”,HBM 和先进封装因此成为最紧的咽喉——HBM 是最先进 DRAM 加 TSV 堆叠、三强垄断又被管制、最难短期补的单点,而先进封装依赖成熟制程、考验封测 know-how,恰是中国凭全球第一梯队 OSAT、庞大成熟产能和 Chiplet/UCIe 标准窗口最可能先突破、且价值已占顶级 AI 芯片一半以上的口子;现实路径是“成熟多 die + 强封装拼出不依赖最尖端光刻的高价值系统、HBM 先保推理再长期补国产先进 DRAM”——它给了中国在先进逻辑受限下仍能造出有竞争力 AI 系统的战略空间。