FPGA 原型验证专题 13:跨 FPGA 互联与 TDM 同步——SerDes/并行链路、跨片时序与降频比
更新时间:2026-09-12。本文是「ASIC FPGA 原型验证系统」专题 06~25 深体系列分册,对应阶段 2(跨 FPGA 互连生成)。分区算法见 12 多 FPGA 分区算法 割集/容量/图划分,平台视角见 02 多 FPGA 原型系统 ASIC 分区/TDM,物理层背景见 04 高速收发器 与 20 LVDS 源同步。
这一篇在链路里的位置
阶段 2 输出"跨 FPGA 互连、同步逻辑"。本篇专注这些逻辑怎么生成、怎么保证正确、怎么决定原型最终能跑多快。跨片 TDM 往往是多片原型频率的决定项,因此与阶段 4 的时序收敛强相关。
本文要回答的问题
- 板级互联有哪些物理形式(并行总线/LVDS 线缆、MGT/SerDes、Aurora/自定义协议),各自带宽/延迟/数量?
- TDM 如何把 N 条逻辑连接压到 1 条物理链路上?聚合/解聚合、帧格式、时钟域怎么设计?
- TDM 比率如何换算成系统降频?为什么跨片连接越多、原型频率越低?
- 跨片同步:发送/接收 FIFO、多周期握手、复位对齐、多片时钟同源(板载时钟树)?
- 跨片延迟(额外周期)对 SoC 性能/软件时序评估意味着什么,如何在报告中校正?
- 互联拓扑如何与分区协同:mesh/星型/全连接的取舍与拥塞热点?
- 跨片信号的可观测性与调试:跨片 probe、环回测试如何做?
一、物理互联层:两类链路
分区割出的连接要落到板子的真实通道上,物理形式两类:
| 类型 | 介质 | 单通道速率 | 特点 |
|---|---|---|---|
| 并行 LVDS/单端线缆 | 板级走线、排线、同轴 | 几百 Mbps~1 Gbps/对 | 延迟低、协议简单;占用引脚多,通道数受连接器限制 |
| 高速 SerDes(MGT/GTH) | 差分对 + FPGA 收发器,常跑 Aurora 或自定义帧协议 | 10~25+ Gbps/lane | 带宽密度高、可走远距/背板;有 64b/66b 编码、弹性缓冲带来的固有延迟,需参考时钟 |
分配原则:大批量、非极关键的割边走 SerDes 复用;少量强时序、低延迟需求的握手走近邻 LVDS 直连。引脚、SerDes lane、差分对和参考时钟在 07 面向原型的 RTL 交付规范 层次/黑盒/电源域的平台约束里就是硬预算,分区器(12 多 FPGA 分区算法 割集/容量/图划分)必须在这个预算内切。SerDes 电气层(眼图、均衡)见 04 收发器信号完整性,Aurora 接入见 05 Aurora。
二、TDM 原理:把 N 条连接压进一条线
一条物理链路上要承载几十到几百条逻辑连接,靠发端聚合器(multiplexer)按时隙轮发、收端解聚合器按同一调度还原:
发端(片 A):  N 个源寄存器 ──> 发送寄存器组 ──时隙轮转──> 物理 lane
收端(片 B): 物理 lane ──> 对齐/缓冲 ──时隙解轮转──> N 个目的寄存器- TDM 比率 R:一轮时隙数(含帧/校验开销)。若物理链路跑 f_phy、原型系统时钟 f_sys,则要求
f_phy ≥ R · f_sys(并行总线还要乘位宽折算);反过来 f_sys ≤ f_phy / R——这就是 56 篇说的「系统频率被最坏通道 TDM 决定」; - 静态 TDM:时隙表编译期固定,每条连接每轮必有一个时隙,延迟确定、无仲裁、硬件简单,是主流;
- 动态 TDM:按 valid 动态分配时隙,利用率高但引入仲裁与可变延迟,只在连接平均活跃度低且能接受不确定延迟时用;
- 多 bit 总线(如 128 位 AXI)会占用一个时隙的多个连续拍,TDM 表按「连接位宽/lane 位宽」折算占用率。
三、跨片同步单元:保证多周期传输不错位
TDM 传输跨多个系统周期,两端必须有配套同步结构(Compiler 在阶段 2 自动插入):
- tx/rx 边界寄存器:割边两端的信号在源片先打入发送寄存器(打拍点正是 56 篇要求的「割在 reg-to-reg 边界」),收端解出后打入接收寄存器;
- 字对齐与帧同步:SerDes 链路用训练序列(K 字符/逗号对齐)确定时隙边界,链路失步时能重新对齐并上报;
- 跨片弹性缓冲/FIFO:收发两端物理时钟存在 ppm 级偏差(即使同源也有抖动、跨板可能异源),接收侧用浅 FIFO 或双口 RAM 吸收漂移;这本质上是个小规模 CDC/比特滑差问题,复用 异步 FIFO 与 Gray 指针的思路;
- 复位与使能广播:所有片的 TDM 收发器、对齐状态机由统一的复位释放序列启动(复位策略),先发端出稳定训练码、收端报告 in-sync,再放行用户数据——顺序反了会把未对齐的码流当数据(bring-up 细节见 03 原型平台 bring-up 多片点亮/trace)。
四、时钟架构:多片同源是默认前提
多 FPGA 平台通常用板载高稳晶振经时钟分发芯片给每片供同源参考时钟,片内各用 MMCM/PLL 生成自己的系统时钟与 SerDes 时钟:
- 同源同频不同相:相位由板长/MMCM 决定,TDM 接收端按固定延迟或训练结果对齐,时序最好处理;
- 异源/独立 PLL:按真 CDC 处理,跨片 FIFO + Gray 指针,延迟和频率都独立,代价更高;
- 原型中一般不制造 ASIC 里没有的时钟:ASIC 两个异步域跨片时,异步性质本来就存在(走原有握手);同源同步域被迫跨片时,Compiler 插入的 TDM 同步单元负责维持「同一系统时钟拍」的抽象。
五、延迟模型与性能校正
每条跨片连接在用户逻辑看来多了固定延迟:L_hop ≈ R 个 f_phy 拍折算成的 f_sys 周期 + FIFO 深度 + SerDes 固定延迟(几十 ns)。工程上 Compiler 把跨片跳数算进时序模型,并在两个层面处理:
- 功能正确:割边只落在 reg-reg 边界,插入的延迟对 RTL 透明(两端寄存器语义不变,只是隔了几拍),单 bit 控制/握手跨片时自动展宽/req-ack 化(原理同 CDC 脉冲同步);
- 性能数据校正:原型测出的 SoC 性能(IPC、总线延迟、实时响应)包含了真实芯片不存在的跨片延迟,出报告时按「跨片连接清单 × hop 延迟」把这部分扣除或给区间,不能把原型裸数字直接当硅前结论——这条与 08 不可综合构造识别与存根替换 模拟IP/时钟门控、23 Gate→RTL 数据回映 查表/聚合/SAIF衔接。
六、拓扑与分区协同
板子物理拓扑(mesh 网格、星型、全连接、自定义背板)决定哪些片对之间有直连 lane:
- 分区器的割边矩阵必须落在拓扑邻接关系内:非直连片对通信要中转,每中转一跳多一份 TDM 延迟和带宽占用;
- 热点:割边高度集中的片对会形成瓶颈通道,分区迭代时把对应模块对挪近或加亲和约束(12 多 FPGA 分区算法 割集/容量/图划分);
- 冗余路径:预留少量 lane 给后期增量改 RTL 新增的割边和 probe 回传(14 可观测性插桩 dont_touch/probe/可见性预算),不用一改代码就连不上;
- 拓扑—分区联合优化是 Compiler 与原型团队的接口面:板子设计阶段就要用历史分区数据估 lane 数,否则平台天生跑不高频率(容量规划见 02 多 FPGA 原型系统 ASIC 分区/TDM、43 多板系统)。
七、互联正确性验证
bring-up 在加载用户比特流前先验链路(顺序见 03 原型平台 bring-up 多片点亮/trace):①环回测试——每对 lane 自发自收 PRBS/计数器码型,验证位错率;②BERT——长时间比特误码率统计,排除焊接/信号完整性问题;③时隙对齐测试——发已知时隙帧,验收端解聚合后每条逻辑连接的值与顺序;④协议检查器——Aurora/自定义帧的状态寄存器(buffer error、disparity error、失步次数)可读(寄存器访问见 01 原型验证 Debug IP 寄存器是怎么被访问的)。跨片 probe 数据本身也是这条链路上的一类时隙流量,22 Gate 域信号采集 ILA/trace/带宽深度权衡会用到。
八、与频率收敛的衔接
跨片通道是多片原型系统频率的决定项:先按最坏 TDM 比率算出 f_sys 上限,再要求片内逻辑在该频率收敛(19 原型频率与时序收敛 TDM 降频/关键路径)。若收敛不了,杠杆依次是:重分区降 TDM(治本)、提高 SerDes 速率或换更宽 lane、把关键连接挪到 LVDS 直连、最后才降系统频率。互联、分区、频率三者必须联合迭代,不存在「先各自做好再拼起来」。
九、TDM 协议的工程细节:帧、序号与反压
第三节给了 TDM 的原理骨架,真实系统里的 TDM 传输单元还要处理成帧、错位保护、流控反压等工程问题,任何一项做不好都会表现为「偶发数据错乱、极难复现」。成帧与时槽分配:一条物理链路上周期轮转的时槽不是裸传数据,通常打包成帧——帧头携带帧同步标记、时槽映射表(这个帧里每个时槽属于哪条逻辑连接)、序号;接收端先帧同步再按表分流。时槽映射可以是静态配置的(构建期固定,延迟确定、硬件简单,是主流),也可以带动态分配(按活动度借槽,复杂且延迟不固定,少见)。错位与重同步:接收端本地轮转指针若因复位不同步、比特错误、链路降速恢复而与发送端错位一个周期,所有逻辑连接的数据会整体错相位,且系统不会立即报错——这是最危险的静默故障。保护手段是帧序号连续性检查、周期性发送绝对时槽标记、收发两端复位握手,检测到失步立即丢弃并重训,而不是用错位数据继续运行。多 bit 宽与 SerDes 承载:板级并行互联单根线每周期一位,一组线(如 32 对)传一个位平面;走 SerDes 时,多个时槽数据连同帧头打包成 64b/66b 之类的码组,恢复时钟与本地时钟的频差靠异步 FIFO 吸收,TDM 调度要考虑 SerDes 成帧的粒度,不能假设每个物理周期都能装进整数个时槽。反压与背压传播:当接收端(或它下游的逻辑)暂时不能接收某条逻辑连接的数据(FIFO 将满),反压信号本身也要经 TDM 回传,但 TDM 是周期轮转的,反压到达发送端时已经隔了若干物理周期,发送端必须为「已发出但尚未被反压覆盖」的在途数据保留缓冲(深度 = 往返时槽数),否则会丢数据。每条逻辑连接需要独立的 credit/valid/ready 状态,TDM 只是共享导线、不共享握手语义。复位与使能的顺序:链路训练完成、帧同步之前,所有逻辑连接的输出必须呈现「空闲/无效」,避免训练期间的乱码被当真实事务灌入 DUT;这也是 64 篇版本门禁里「跨片链路就绪」要作为系统解除复位前置条件的原因。这些协议细节通常封装在商用互联 IP 内,但理解它们才能正确配置延迟参数、解读链路状态寄存器、在偶发错乱时定位到底是 TDM 层还是 DUT 功能问题。
十、多片时钟与复位的编排:让一组 FPGA 表现成一台机器
多片系统功能上要让软件和测试团队觉得它是「一颗芯片」,时钟和复位编排是底层前提。时钟同源架构:默认所有 FPGA 由同一低抖动时钟发生器供给同源参考时钟,各片 MMCM/PLL 配置成相同频率与相位关系;这样跨片 TDM 传输即使经过 SerDes,两端也有已知的频率关系,异步 FIFO 只承担相位差与抖动,不会持续积累频差漂移。需要多频率方案时(例如片间跑 250 MHz 接口、DUT 内部等效 5 MHz),频率比必须是整数且在 TDM 调度表中精确登记,67 篇的时间折算才成立。复位树编排:全局复位不能简单地把所有芯片的复位脚同时拉高释放——跨片链路未完成训练时释放 DUT 复位,会灌进乱码;正确顺序是分级:先复位各片基础设施(时钟、TDM 收发器、采集网络),等待全部链路报告帧同步与就绪,再释放跨片接口逻辑,最后按 DUT 的复位域拓扑释放功能逻辑,处理器核通常最后释放。整个序列由一片主 FPGA 或板载控制器编排,每步带超时与失败码,任何一片没就绪就中止启动并点亮对应错误灯——这比「系统有时候启动不起来,多按几次复位就好」专业得多。停钟、单步与锁步(与 65/67 篇衔接):协同仿真需要暂停 DUT 时,编排器要同时停所有片的 DUT 时钟(基础设施时钟不停,保证采集和 TDM 活着),记录停钟区间,恢复时先确认链路仍同步再继续。复位与采集的关系:复位会清空 FPGA 内大部分状态,但采集头里的版本号、缓冲区、同步标记不能被 DUT 复位清掉,否则无法在复位后追查「是什么导致了这次复位」;复位事件本身要打上时间戳进采集流。多板级联(超过两片、跨多张板卡)时还要处理板间时钟分发的偏斜(等长或用时钟树芯片)、主备时钟源切换、上电顺序由电源序列器保证。时钟复位编排逻辑应作为平台基础设施与 DUT 完全解耦、独立验证——它本身是个小型高可靠状态机,值得专门的仿真用例和上电老化测试。
十一、互联层的可观测性与现场故障定位
跨片互联是多片系统里故障最集中的地方,而且故障模式(训练失败、偶发误码、时槽错位、反压丢数据、频差漂移)几乎不可能靠看 DUT 波形定位,必须在互联层内建可观测性。链路级健康寄存器:每条物理链路维护训练状态、帧同步状态、字节/帧错误计数、误码计数(SerDes 自身的 PRBS 校验和帧级校验)、复位以来的失步次数;这些寄存器挂在平台管理总线上(见 fpga/09 的调试寄存器通道),BIST 和日常巡检读取趋势——缓慢上升的误码计数预示连接器老化或时钟源劣化,可以在彻底中断前换板。时槽级活动计数:对每个时槽/逻辑连接统计周期数、valid 占空比、反压次数,这些数据有两个用途:现场定位「为什么这版变慢」(某条连接反压率飙升说明对端停摆或缓冲配置错误);离线反哺分区(真实活动度让下版分区把低 TDM 槽给热边,见 56 篇)。环回与对发测试:互联 BIST 支持内环回(SerDes 自发自收,查本地)、外环回(经过对端再回来,查链路和对端 IO)、多跳对发(沿 TDM 调度表发已知时槽图案,查时槽映射正确性);上电时自动跑,失败码精确定位到哪一对线、哪一级。隔离手段:要能通过寄存器把可疑链路置为静态、强制重训、临时把某条逻辑连接从调度中摘除(让 DUT 看到该连接持续无效而不是乱码),配合二分法把故障范围从「系统不对」缩到「第三、四片之间这条 SerDes」。物理现场因素:多板系统很多互联故障是物理的——线缆松动、散热风扇震动让连接器微磨、电源地弹让高速眼图闭合;可观测性要与物理检查流程结合(错误码定位到具体线缆编号,标签管理),软件日志里的「链路失步」要能翻译成「检查 3 号板到 5 号板的第 2 根线」。把互联层当作需要独立监控的子系统来设计,而不是期望它永远默默工作,是多片原型从实验室走向团队共享和农场化运行的必要条件。
十二、协议无关互联的演进:从固定 TDM 到动态与包交换
固定 TDM 之所以成为多片原型主流,是因为它延迟确定、硬件简单、综合时序友好;但理解它的局限和后续演进方向,有助于在性能撞墙时知道还有哪些牌可打。固定 TDM 的根本代价是带宽利用率与最坏情况绑定:时槽按峰值需求静态分配,即使某条逻辑连接整轮空闲,它的槽位也不能被别人用;割边总量稍一增加就抬升全局 TDM 比,让所有连接一起变慢。第一种改良是半静态重配置:时槽表仍由构建期生成,但支持在运行开始前按「场景」切换多套表——跑数据面测试时把槽位让给数据总线,跑控制面调试时让给调试通道;切换由平台编排器在停钟窗口完成,延迟确定性仍在,只是按场景而非按周期分配。它几乎不增加硬件复杂度,是实践中性价比最高的改良。第二种是信用/握手机制的精细化:在 TDM 框架内给每条连接独立 credit,只在有数据时占用自己的槽,空槽仍空转但不产生反压误判,配合发送端缓冲让热连接实际吞吐接近其分配上限、冷连接不拖后腿——这是对固定 TDM「逻辑上变慢但物理上空闲」悖论的直接修补。第三种是 SerDes 承载下的包/帧交换:当互联走高速串行链路(每条 10Gbps 以上),物理层已经是成帧传输,进一步在片间放轻量交换器,把跨片消息打成带连接号的包、按信用发送,就走向了包交换互联;它的利用率最高、天然支持多跳和动态拓扑,但代价是延迟不固定(排队抖动)、需要更深的弹性缓冲、时序分析从「按 TDM 表折算」变成「按统计延迟评估」。因此包交换通常只用于非关键路径的大数据搬运(trace 导出、批量激励注入、处理器间消息),关键控制面仍走确定性通道,形成混合架构。与商用趋势的对照:商用原型平台和仿真加速器的互联正是沿「并行固定 TDM → SerDes 帧化 → 动态/包交换混合」演进,高端平台用数十 Gbps 串行背板把 TDM 比压到接近 1:1,使多片系统的等效频率损失大幅缩小。选择平台时,互联架构(拓扑、单向/双向带宽、延迟模型、可否多跳、对 TDM 比的标称值)应当与 FPGA 容量同等权重地评估——容量决定装不装得下,互联决定装下之后跑不跑得快,而这两件事在历史上被错误地只关注前者。最后记住:互联层引入的任何延迟与重排都必须进入 57 篇自己讲的延迟模型和 63 篇的频率校正,互联越动态,校正模型和活动数据的解释就越要保守——性能收益与可解释性之间始终有一笔需要显式管理的交易。
十三、互联设计的评审清单:一块多片板开工前要回答的问题
把互联主题落成一份评审清单,在板级设计冻结和每次平台升级前逐项过一遍,可以避免大量「板子做出来才发现」级别的问题。容量与拓扑方面:目标设计的割边总量、最坏时槽比、每对芯片间需要的单向带宽是多少;拓扑是否支持未来扩容(空焊盘、可级联口);任意片对通信要经过几跳,多跳路径的延迟模型是否进入频率预算。物理层方面:并行互联的线对是否等长、阻抗是否受控、参考时钟如何分发与缓冲、SerDes lane 的极性与 AC/DC 耦合方式、损耗预算和连接器选型是否满足目标速率;时钟源冗余和切换方案是什么。协议方面:帧格式与序号是否有失步检测和自动重训,反压在途深度是否覆盖往返槽位,链路训练状态机在异常(超时、误码、对端未就绪)下是否有确定退出路径,复位编排是否把「链路全部就绪」作为功能域释放的前置条件。可观测性方面:每条链路的误码、失步、反压计数是否挂到管理总线,BIST 是否覆盖内环、外环和多跳对发,故障能否定位到线缆/连接器编号。版本化方面:时槽表、帧格式、时序参数是否有版本字段,硬件协议升级时新旧比特流能否共存或被显式拒绝混跑。系统级方面:调试/trace 流量与 DUT 流量如何共享带宽而不互相挤垮,采集导出在峰值 trace 场景下会不会饿死控制通道,掉电/热插拔一片板时其余系统如何降级。每项问题都要求有书面答案和负责人,而不是会上一句「应该没问题」。这份清单的价值在第二个项目才完全显现:第一个项目踩过的坑变成第二个项目的评审项,平台工程的复利就积累在这张不断增长的表上。
十四、结语:互联是多片系统的隐形架构
互联在项目初期最不引人注目——板卡清单和 FPGA 选型是显性决策,TDM 却像水电煤,只有出问题时才被想起。但系列经验反复表明:容量决定项目能不能开始,互联决定项目能跑多快、调试有多痛、数据有多可信。设计阶段对互联的每一分投入(时槽比精算、帧序号、反压深度、健康寄存器、统一复位编排、版本化协议)都在后续每个版本复利式地回报;反过来,互联上欠的债会以最恶劣的形式出现——偶发、错相位、跨温度、无法用 DUT 波形解释。与系列其他主题的关系也在此收束:它的输入来自分区的割边(56 篇),它的延迟进入频率模型(63 篇),它的健康计数进入采集与回映(66、67 篇),它的就绪信号是部署门禁的一部分(64 篇),它的带宽还是 trace 导出和协同激励的物理上限(58、65、66 篇)。因此互联工程师的视野不能停在收发器:协议、时序、调度、采集、版本、运维都是这一层的接口。判断一套多片平台是否成熟,最快的方法是问三个问题——任意一次跨片偶发错乱,链路层能不能自己发现并定位;一个新人能不能凭文档完成一次链路重训和故障定位;板级协议升级时,新旧版本会不会被系统拒绝混跑。三个问题都能肯定回答,互联才算从「能用的连线」升级为「可信的架构」。
知识脉络
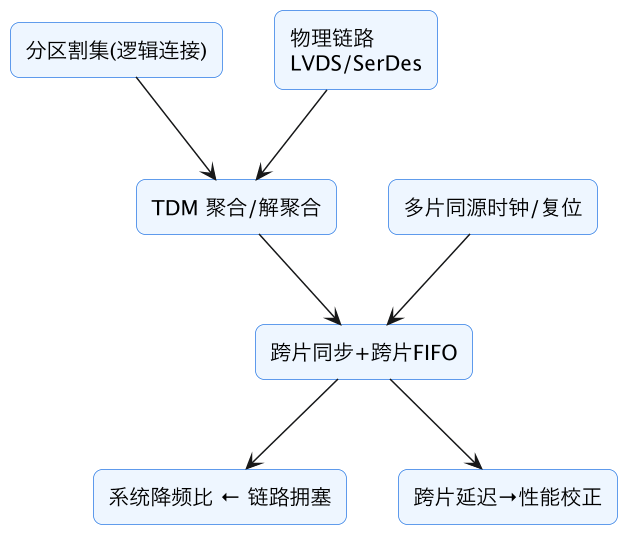
与系列及现有篇目的衔接
- 分区:12 多 FPGA 分区算法 割集/容量/图划分;平台:02 多 FPGA 原型系统 ASIC 分区/TDM
- 物理层:04 高速收发器、05 Aurora、20 LVDS 源同步
- 下游:19 原型频率与时序收敛 TDM 降频/关键路径、03 原型平台 bring-up 多片点亮/trace、43 多板系统
总结
一句话总结:分区割出的逻辑连接要落到并行 LVDS/线缆(低延迟但占引脚)或高速 SerDes/Aurora(带宽密度高但有编码与弹性缓冲延迟)两类物理链路上,引脚、lane 和参考时钟在平台阶段就是硬预算;当逻辑连接数远超物理线数,Compiler 自动在两端插入聚合/解聚合器做 TDM 时分复用,静态时隙表延迟确定是主流、动态时隙利用率高但延迟不定,核心换算关系是 f_sys ≤ f_phy/TDM 比率,因此系统频率被最拥塞通道而非片内逻辑决定;多周期传输必须配 tx/rx 边界寄存器、训练字对齐、吸收 ppm 漂移的跨片弹性 FIFO 和统一复位广播(先训练同步再放行数据);时钟架构默认多片同源、片内 MMCM 生成,被迫跨异步域时按真 CDC 处理;每跨一跳都有可建模的固定额外延迟,功能上靠割在 reg-reg 边界保持透明,性能报告则必须扣除硅上不存在的跨片延迟;分区割边矩阵必须匹配 mesh/星型/全连接物理拓扑并为中转跳数、热点和后期 probe 预留冗余 lane;链路在加载用户设计前要过环回、BERT、时隙对齐和协议状态检查四道关;最终互联、分区、频率必须联合迭代——降 TDM 重分区是治本,提速/加宽/直连是治标,降系统频率是最后手段。