ECO 迭代收敛追踪:多轮变更量、违例数与时序余量的判读方法及叫停纪律
更新时间:2026-10-05。ECO 迭代收敛追踪是 ECO 流程里最容易「埋头修、不抬头看路」的一环:一轮轮网表补丁打下去,每轮都能修掉几百条违例,看起来进展喜人,但项目例会上没人能回答一个简单的问题——我们是在收敛,还是在原地打转甚至发散?这一篇建立一套可落地的追踪方法:每轮 ECO 该记哪些数(变更量、违例数、时序余量三条主线),三条曲线分别怎么判读,什么情况算正常收敛、什么信号说明在发散,以及最重要的——什么时候必须叫停 ECO、回到方案层面重想,而不是继续一轮轮硬修。读之前建议先有 时序 ECO what-if 分析 与 批量 ECO 脚本化流程 的基础,ECO 整体节奏见 Signoff 收敛与 ECO 流程。
本文要回答的问题
- 每轮 ECO 结束,该把哪些数字记进追踪账本,记到什么粒度才有判读价值?
- 变更量、违例数、时序余量三条曲线各自的「健康形状」长什么样?
- 哪些信号说明 ECO 在发散——新增的违例比修掉的还多、WNS 修好 TNS 却恶化?
- 收敛判据怎么定:违例归零就够了吗,为什么要看「尾巴形状」?
- 叫停纪律:连续几轮不达标就该停手,停手之后走哪条升级路径?
一、为什么要追踪:单轮视角的三大盲区
ECO(Engineering Change Order,工程变更)在 signoff 后期是多轮迭代的:每轮跑一遍实现工具(P&R 的 ECO route、时序修复引擎),再跑一遍签核分析(STA、DRC、LVS、功耗),比对违例清单,决定下一轮修什么。单看每一轮,一切都很合理——修了几百条 setup 违例、DRC 从 1200 降到 900。但单轮视角有三个盲区。
第一个盲区是「拆东墙效应」:修 setup 的动作(插 buffer、换高驱动单元、upsizing)会引入新的 hold 违例、新的 DRC 违例(间距、max transition)、甚至恶化功耗。单轮报告只告诉你修了什么,不告诉你弄坏了什么——得跨轮比对违例集合的差分才能看见。
第二个盲区是「边际收益递减被掩盖」:第一轮修掉 800 条,第二轮修掉 300 条,第三轮修掉 50 条,第四轮修了 10 条但新冒出 40 条。每一轮单独看都在「前进」,曲线连起来看却明显收敛不动了,剩下的违例是硬骨头(物理拥塞、时钟树瓶颈),继续用同样的修法则只会空转。
第三个盲区是「团队记忆缺失」:项目紧张时 ECO 可能由多人轮班提交,A 工程师第 3 轮把某条路径的 buffer 删了降功耗,B 工程师第 5 轮又因为 setup 违例把它加回来。没有一份逐轮账本,没人记得哪个区域已经反复动过几次——而反复翻动同一区域正是网表质量劣化和 LVS 风险累积的来源。
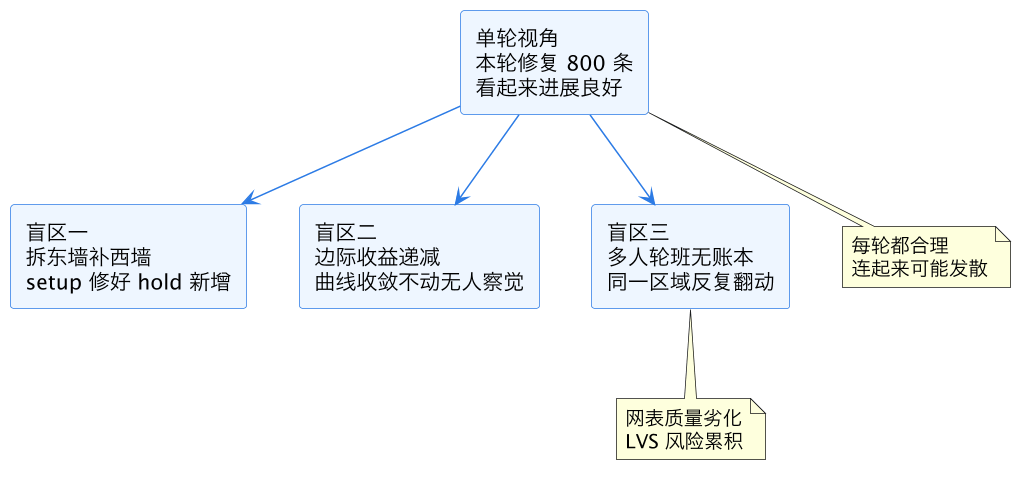
这张图是追踪机制存在的前提:单轮报告永远健康,风险全部藏在轮与轮之间的差分里。下面三条曲线,就是把差分显式化的最小账本。
二、三条主线:变更量、违例数、时序余量
追踪账本的每一行对应一轮 ECO,最少要记三组数。
第一条主线是变更量:这一轮往网表里打了多少东西。细化到:新增/删除 cell 数、resize 次数、插 buffer 数、ECO route 改动的 net 数、动到的模块分布(top 级还是某个 block 集中)。变更量是「成本」曲线——每一轮变更都在消耗剩余的路由资源和物理余量,也在累积 LVS/形式验证的工作量。健康项目里变更量应该逐轮下降:第一轮大改(几千处),到第 4、5 轮只剩几十处精修。
第二条主线是违例数:这是结果曲线,但要分类记,不能只记一个总数。setup 违例数、hold 违例数、max transition/capacitance 数、DRC 违例数、ECO 引入的新违例数(上轮没有、这轮出现的)分开记。其中「新增违例数」是最敏感的指标——它直接度量拆东墙效应。一轮健康的 ECO 应该是:修复数显著大于新增数;如果连续两轮新增数接近甚至超过修复数,就是在打地鼠。
第三条主线是时序余量分布:违例数只告诉你多少条路径没过,不告诉你过得有多勉强。要记 WNS(Worst Negative Slack,最差负余量)、TNS(Total Negative Slack,总负余量)和正余量路径的「尾巴形状」——比如 slack 在 0 到 50ps 之间的路径条数(擦边路径)。WNS 反映最差点,TNS 反映违例总量,擦边路径数反映下一次 corner 漂移或 OCV 建模变化时会新掉下去多少条。健康收敛的形状是:WNS 单调收窄到接近零、TNS 加速下降、擦边路径数不增长。
| 主线 | 记录内容 | 度量什么 | 健康方向 | 告警信号 |
|---|---|---|---|---|
| 变更量 | 新增/删 cell、resize、插 buffer、改 net 数及模块分布 | 修复成本与物理余量消耗 | 逐轮下降,个位数收尾 | 第 N 轮仍上千处变更 |
| 违例数 | setup/hold/transition/DRC 分类计数加新增违例数 | 净修复效果 | 修复数远大于新增数 | 新增数连续两轮接近修复数 |
| 时序余量 | WNS、TNS、0-50ps 擦边路径数 | 收敛质量与抗漂移能力 | WNS 收窄、TNS 加速降、擦边数稳定 | WNS 收窄但 TNS 不降、擦边数膨胀 |
这张表把三条主线的「记什么、看什么」一次收齐。注意最后一列的告警信号——它们都不是单轮报告里能看见的东西,必须跨轮比对才浮现。
三、收敛曲线怎么读:健康形状与三种发散模式
把三条主线按轮次画成曲线,健康的 ECO 收敛有明确的形状:变更量指数衰减(每轮约为上一轮的 1/3 到 1/2),违例数阶梯式下降且新增违例始终贴着零轴,WNS 从 -200ps 这类水平逐轮收窄到 -20ps 以内,TNS 下降速度比违例数下降更快(说明先修掉了深违例)。项目进入这个节奏后,剩下的工作就是收尾——typically 5 到 7 轮内可以见到违例归零或只剩可 waive 项。
不健康的发散有三种典型模式,各自指向不同的根因。
模式一是「打地鼠」:总违例数在某一水平上下震荡,每轮修复数和新增数大体相当。根因通常是修复策略互相打架——setup 修复引入 hold 违例,hold 修复又拉回 setup;或者两类违例集中在同一拥塞区域,物理上没有空间同时满足。判别方法是看新增违例的构成:如果新增 hold 主要来自本轮动过的 setup 修复邻域,就是典型的自我打架。
模式二是「WNS 孤岛」:违例数和 TNS 都在降,但 WNS 连续几轮卡在同一个数值附近不动,而且最差路径一直是同一条或同一个模块。这说明剩下的是结构性问题——时钟树偏差、floorplan 缺陷、或者约束本身有问题(比如该设的 multicycle 没设),继续插 buffer 修不动它。
模式三是「擦边膨胀」:违例数确实在降,但 0-50ps 擦边路径数持续增长——修复引擎把深违例修成了擦边违例,面子上干净了,余量底子更薄了。这种项目在换 corner 重签或电压温度漂移时会成片回弹,是典型的「数字收敛、质量发散」。
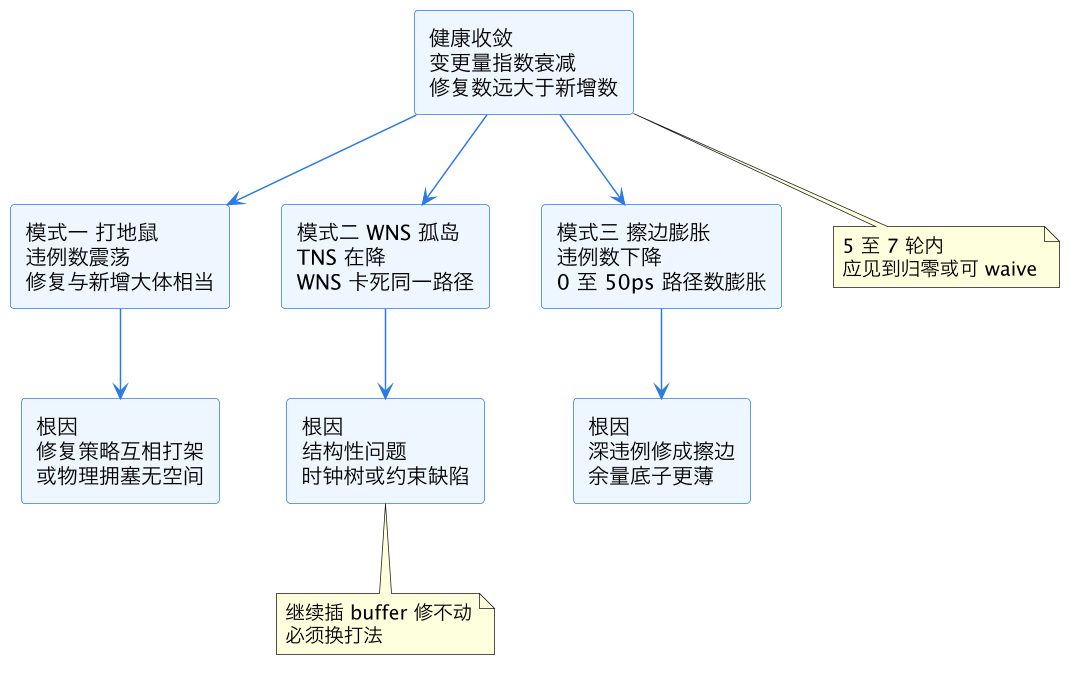
这张图把健康形状和三种发散模式并排对照。关键是每种发散模式的根因都不在「修得不够努力」,而在策略或结构层面——这决定了应对方式不是「再来一轮」,而是下面第五节的叫停与升级。
四、收敛判据:归零不是唯一答案
什么时候可以宣布 ECO 收敛、进入冻结?直觉答案是「违例归零」,但工程上这个答案既不够安全也不够现实。一套可执行的收敛判据应该同时满足四个条件。
条件一,硬违例归零:setup、hold 在 signoff 全 corner 下无违例,或剩余违例逐条有签核批准的 waiver( waiver 清单本身要进账本,防止 waiver 数悄悄膨胀)。
条件二,变更量降到冻结阈值:最后两轮变更量降到预设阈值以下(比如单轮改动 cell 数少于 20、且不触及时钟树和接口逻辑),说明网表已经进入稳定态,形式验证和 LVS 可以跑终版。变更量没降下来,归零只是暂时的——下一轮回归可能又翻出来。
条件三,余量尾巴达标:擦边路径数不超过预算(比如全芯片 0-50ps 路径少于 500 条,且关键接口路径 slack 大于 100ps)。这个预算来自项目对 PVT 漂移和 aging 的历史统计,不是拍脑袋。
条件四,新增违例连续两轮为零:这是「拆东墙效应已经停息」的直接证据。只归零一轮不算数,要连续两轮干净。
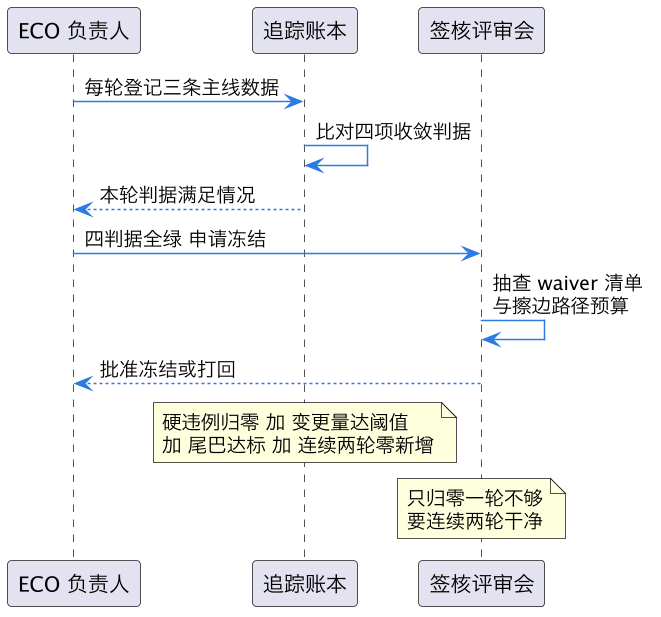
这张时序图是收敛宣布的责任链:账本负责给数据,评审会负责challenge waiver 和尾巴预算。四判据缺一,冻结申请就该被打回——被连环 call 半夜回滚网表的项目,多半是在条件二或条件四没满足时就匆匆冻结了。
五、叫停纪律:什么时候必须停止继续修
比「什么时候收敛」更难的是「什么时候承认这条路走不通」。ECO 有沉没成本陷阱:已经修了六轮,谁都不愿意承认应该推倒重来。叫停纪律就是把「承认」变成事先约定的机械判据,不靠会上拍板。
建议的叫停触发条件(满足任一即触发):其一,连续三轮总违例数无净下降(打地鼠模式实锤);其二,变更量连续两轮超过首轮的 1/2(收敛节奏根本不存在);其三,WNS 卡在同一数值三轮且最差路径不变(结构性问题实锤);其四,新增违例数连续两轮超过修复数的 30%(每修一轮都在制造新麻烦)。
叫停之后不是停工,而是升级路径:打地鼠模式升级到「分域修复」——把 setup 和 hold 的修复动作在空间上和时间上解耦,先冻结 hold 修复清单再动 setup,或者干脆用专门的 hold-fixing pass 收口;WNS 孤岛升级到结构级手段——回 层次化 ECO 的块顶同步 重新切分时钟预算,或检查约束层面是否有漏设的多周期路径;擦边膨胀升级到修复目标的调整——把修复引擎的 target slack 从 0 提到 30-50ps,宁可多留违例也要保住余量底子,代价是多一两轮迭代但换来抗漂移能力。金属层所剩无几时的补救空间见 metal-only ECO 与 spare cell 流程。
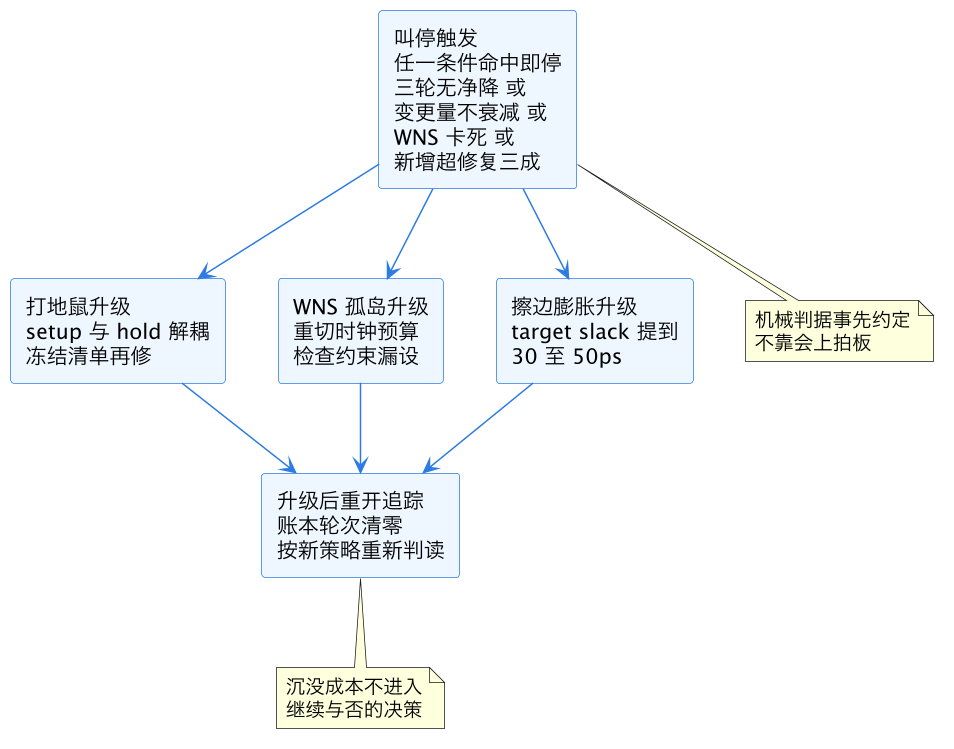
这张图是叫停纪律的完整闭环:触发条件是机械的、升级路径是按发散模式对号的、升级后账本重开。把「叫停」从面子问题变成流程问题,是这套纪律真正能被遵守的关键。
六、落地:账本怎么建、谁来记、怎么评审
落地层面三件事。第一,账本自动化:逐轮数据不该靠人肉抄报告——批量 ECO 流程(见 批量 ECO 脚本化流程)里每轮本来就跑全套 STA/DRC 报告,在流程尾部加一个解析脚本,把违例分类计数、WNS/TNS、擦边路径数、本轮网表 diff 统计(report_changes 类输出加前后网表 diff)抽出来追加到一份 CSV 或数据库表,每轮一行。新增的「新增违例数」靠前后两轮违例清单按路径签名做集合差分得到。
第二,责任到人:ECO 负责人每轮更新账本并在例会上过曲线,评审会按第四节的四判据和第五节的叫停条件逐条对表。多人轮班提交 ECO 的项目,账本里还要记每轮变更的提交人,反复翻动同一区域的提交要在评审时点名复盘。
第三,和里程碑挂钩:收敛判据四条件全绿是网表冻结的前置门禁,叫停条件命中是进入升级路径的前置门禁。两者都写进项目的 signoff checklist(整体框架见 Signoff 收敛与 ECO 流程),不带商量余地。ECO 变更在数据流里的传播链路见 ECO 变更传播,理解它有助于估算每轮变更对下游验证工作量的冲击。
| 落地事项 | 具体做法 | 防止什么 |
|---|---|---|
| 账本自动化 | 报告解析脚本每轮追加一行,违例差分按路径签名计算 | 人肉抄数漏记、口径漂移 |
| 责任到人 | 每轮记提交人,反复翻动区域点名复盘 | 多人轮班的团队记忆缺失 |
| 里程碑挂钩 | 四判据全绿才能冻结,叫停条件命中必须升级 | 沉没成本驱动的硬撑 |
这一篇在知识体系里的位置
本篇是 eda/ 目录 ECO 线里专讲「多轮迭代如何追踪与判读」的一篇,处于「做单轮 ECO」与「宣布收敛」之间:上游接 时序 ECO what-if 分析 的单点修复评估与 批量 ECO 脚本化流程 的逐轮执行框架,同层与 Signoff 收敛与 ECO 流程(整体节奏)、层次化 ECO 的块顶同步(升级路径之一)、metal-only ECO 与 spare cell 流程(后期补救手段)并列,下游落地到 ECO 变更传播 的下游验证安排。握住了三条曲线和叫停纪律,你就不会在第七轮 ECO 的深夜才发现项目其实从第三轮起就在发散。
总结
ECO 迭代收敛追踪的核心是建一份逐轮账本,用变更量、违例数、时序余量三条主线把「在收敛还是发散」变成可读曲线:健康收敛是变更量指数衰减、修复数远大于新增数、WNS 收窄且 TNS 加速降;三种发散模式各有指纹——打地鼠(违例震荡、修复新增相当,升级到 setup/hold 解耦)、WNS 孤岛(同一路径卡死,升级到结构级手段)、擦边膨胀(违例降但 0-50ps 路径膨胀,升级到提高 target slack)。收敛判据是硬违例归零、变更量达阈值、余量尾巴达标、新增违例连续两轮为零四项全绿;叫停纪律是三轮无净降、变更量不衰减、WNS 卡死、新增超修复三成任一命中即机械触发升级路径,账本自动化加评审挂钩让这套纪律不靠自觉执行。