断言库复用:把 SVA checker 做成可参数化、可 bind、可跨项目搬的验证资产
本篇是 SVA 工程化系列的一篇,讨论的是「断言写完之后怎么沉淀」。前置阅读见 SVA 断言实战 与 SVA bind 绑定;单条断言的写法细节见 SVA 断言完全指南。本篇不再讲语法,而是讲怎么把一堆语法正确的断言组织成一个能被多个项目反复搬用的 checker 库。
本文要回答的问题
- 为什么散落在 testbench 各处的断言撑不起复用,必须封装成 checker 模块?
- 一个「可入库」的 checker 模块应该长什么样,内部结构有哪些硬规范?
- 参数化、复位门控、参数开关这三件事怎么设计,checker 才能服务不同配置的设计?
- bind 文件和 checker 源文件怎么组织进库,跨项目复用时版本和回归怎么管?
一、为什么散落的断言撑不起复用
刚接触 SVA 的团队,断言通常长在这三个地方:RTL 模块内部顺手写的 assert property、UVM monitor 里的临时检查、某个 sequence 里针对特定场景的 assert。项目早期这没什么问题——检查确实在跑,bug 确实被抓到过。问题出现在项目收尾和下一个项目启动时。
第一个问题是不可剥离。写在 RTL 里的断言要交给综合、交给客户、交给形式工具,每一处都得用宏小心隔离;写在 monitor 里的断言和该项目的 transaction 类型、analysis port 耦合死,换个环境就编不过。第二个问题是不可检索:项目经理问「AXI 写通道的 AWVALID 稳定性检查我们有没有」,没人能在十分钟内给出确定的答案——它可能藏在三个文件中的任何一个里。第三个问题更隐蔽:同一协议的检查在不同模块里写了三遍,每遍的严格程度还不一样,bug 在 A 模块被抓、在 B 模块漏网,根因是 B 模块那份检查忘了写 disable iff。
断言库复用要解决的正是这三件事:把检查逻辑从设计和环境代码里抽出来,集中到独立的 checker 模块;用 bind 机制挂接,做到 RTL 零改动;用目录、命名、文档把每条检查的「有没有、严不严、测过没」变成可审计的事实。这与 验证 IP 集成与自研取舍 里讨论的自研 VIP 是同一条路线——checker 库本质上就是团队自研的轻量级验证 IP,只不过它只做检查,不做激励。
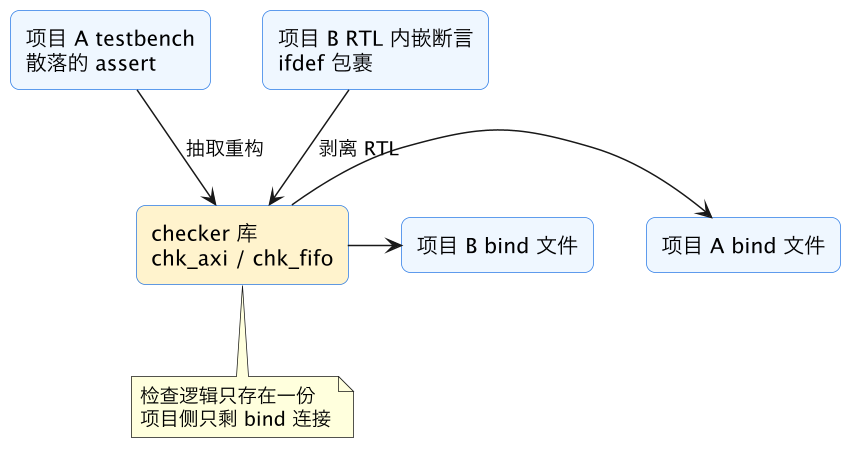
上图是库化前后的对比:左边是断言的典型「野生」状态,右边是收敛后的结构——检查逻辑只在库里存在一份,每个项目侧只留下薄薄的 bind 文件。重构的成本一次性付出,之后每个新项目直接复用。
二、可入库 checker 的封装结构
不是每个写了断言的模块都配叫 checker。一个能进库的 checker 模块,结构上必须有清晰的分层:端口层、门控层、断言组、参数层,各司其职,缺一不可。
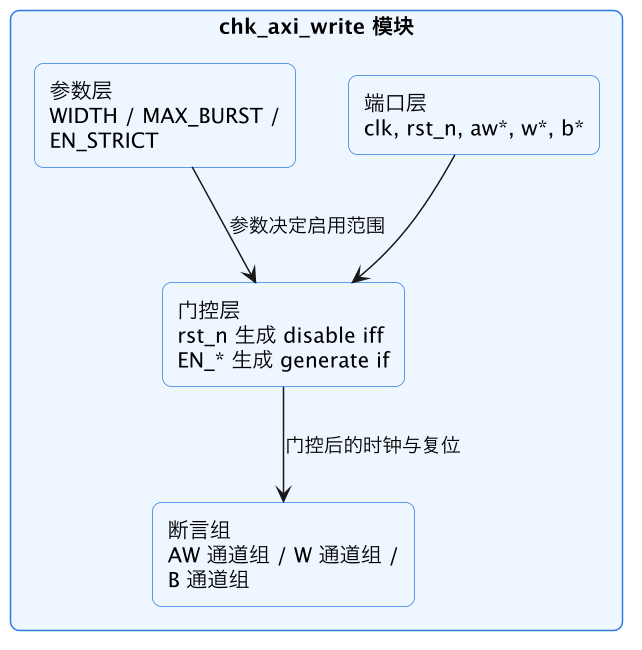
上图是推荐的 checker 内部结构。端口层只接设计信号,不接任何 testbench 对象——这是 checker 能被仿真、形式、emulation 三种工具共同消化的前提(transaction、mailbox 这类对象在形式工具里根本不存在)。门控层集中处理两件事:复位时序(统一的 disable iff (!rst_n),惯例见 disable iff 复位处理)和参数开关(用 generate if 把可选断言组包起来)。断言组按协议通道或功能域划分,每组内 property、assert、cover 三件套写在一起,方便读者一眼看到「这条性质既被断言也被覆盖」。参数层放在模块头,用 parameter 声明,位宽、上界、严格度开关都从这里进来。
具体到代码,一个入库级的 checker 骨架大致如下:
module chk_fifo #(parameter int DEPTH = 8,
                  parameter int WIDTH = 32,
                  parameter bit EN_OVERFLOW = 1,
                  parameter bit EN_UNDERFLOW = 1)
  (input logic clk, rst_n, wr, rd,
   input logic [$clog2(DEPTH):0] count);

  // 门控:统一复位 + 参数开关
  if (EN_OVERFLOW) begin : g_ovf
    property p_no_overflow;
      @(posedge clk) disable iff (!rst_n)
        wr && (count == DEPTH) |=> !wr || rd;
    endproperty
    assert property(p_no_overflow) else $error("fifo overflow wr");
    cover property(@(posedge clk) disable iff (!rst_n) count == DEPTH);
  end

  if (EN_UNDERFLOW) begin : g_udf
    property p_no_underflow;
      @(posedge clk) disable iff (!rst_n)
        rd && (count == 0) |=> !rd || wr;
    endproperty
    assert property(p_no_underflow) else $error("fifo underflow rd");
  end
endmodule
几个细节值得强调。断言组用带名字的 generate 块(g_ovf、g_udf)包起来,这样层次化引用(比如回归脚本里对某一组做 assertion off)有稳定的路径可指。报错信息带模块语境关键词,grep 日志时一眼定位。cover 与 assert 成对出现,覆盖率报表能直接回答「这个极端场景真的被测到过吗」。
还有一个容易被忽略的结构问题是时钟数量。单时钟 checker 最干净,一个 @(posedge clk) 贯穿全模块;多时钟检查(比如 CDC 场景)容易把 checker 写成信号解析的地狱。工程上的折中是:单时钟性质各自成 checker,多时钟性质单独抽一个专用 checker 模块,端口明确标注每个信号属于哪个时钟域,内部用多时钟序列表达,写法参照 多时钟与局部变量。绝不为了「一个模块查所有事」把单时钟与多时钟性质混在一个 checker 里——那不是复用,是把维护成本批发给每个接入项目。
命名规范同样属于封装结构的一部分。库内统一 chk_<协议或功能>_<主题> 的前缀,断言组用 g_<语义>、property 用 p_<语义>,三处命名互相呼应。听起来琐碎,但当验证经理在覆盖率报表里看到 u_chk.g_aw.p_awvalid_stable 时,不需要打开源码就知道这是哪类检查——可检索性正是库区别于散写断言的核心价值之一。
三、参数化设计:一套 checker 服务多种配置
参数化是复用的放大器,也是 checker 库设计里最容易做砸的部分。原则是:结构性差异用参数表达,策略性差异用开关表达,项目私有差异不进库。
| 差异类型 | 例子 | 表达方式 | 理由 |
|---|---|---|---|
| 结构性 | 数据位宽、FIFO 深度、通道数 | parameter | 编译期确定,形式工具可消化 |
| 策略性 | 是否检查溢出、时序上界是否收紧 | parameter bit EN_* | 同一份源码,配置即裁剪 |
| 项目私有 | 特定 SoC 的地址映射检查 | 不进库,留在项目 bind 层 | 入库会污染所有使用者 |
时序上界这类「数值策略」单独说一下。比如 AXI 写响应延迟上界,消费级芯片可能允许 64 拍,实时控制器只允许 8 拍。做法是给一个带默认值的参数 MAX_LATENCY = 64,项目侧 bind 时覆盖:
bind dut_axi chk_axi_write #(.WIDTH(64), .MAX_LATENCY(8), .EN_STRICT(1)) u_chk
  (.clk(aclk), .rst_n(aresetn), .awvalid(awvalid), /* ... */);
bind 传参的机制细节见 SVA bind 绑定,这里只强调入库侧的设计义务:每个参数都要有保守的默认值,让「不传参」永远对应最宽松、最不可能误报的配置。默认值激进(比如默认 MAX_LATENCY=1)是真实踩过的坑——新接入的项目没传参,回归一夜刷出几百条假违例,结论是整个 checker 被标记「不可信」,之后再没人看它的报告。
还有一类参数化需求是「检查对象数量可变」——比如总线上有 N 个 outstanding 事务。这类检查不要试图用参数展开 N 份断言,正确做法是在 checker 内部用一个计数器或 scoreboard 式的小状态机表达,参数只控制上界。把动态结构塞进静态参数展开,是把 checker 写成综合网表的弯路。
四、bind 文件组织与入库
checker 源码只是库的一半,另一半是 bind 模板。入库的 bind 文件要解决三个问题:绑哪些模块、信号名怎么映射、编译顺序怎么保证。
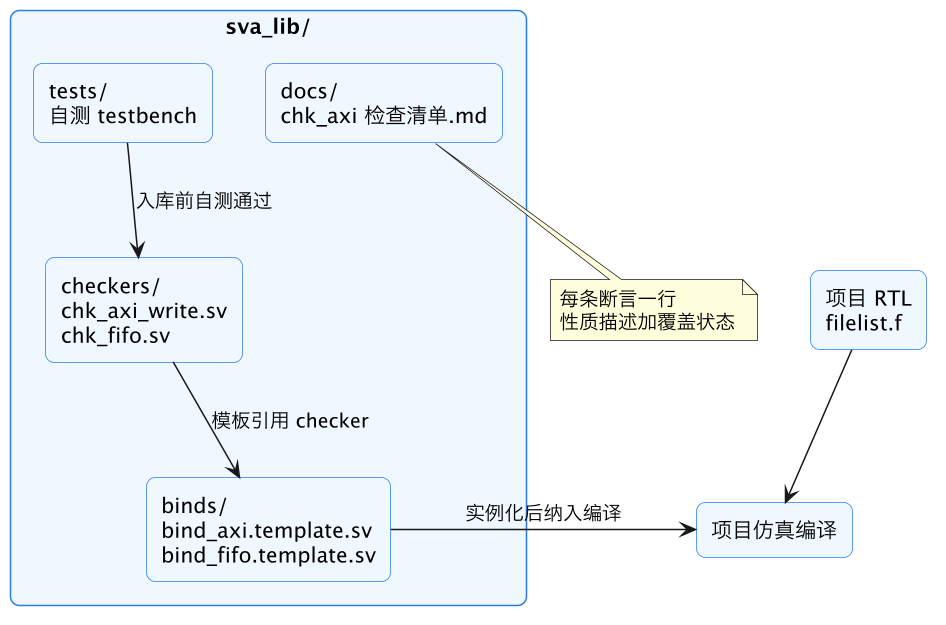
上图是推荐的库目录组织。checkers/ 放参数化 checker 源码,与项目无关;binds/ 放模板文件,模板里信号映射处留注释占位,新项目复制一份改映射即可;docs/ 是检查清单,每条断言一行,写清检查性质、默认门控、对应 cover 状态——这份文档是和 验证计划与覆盖率映射 对接的桥梁,验证计划里的协议检查点直接引用库文档的条目编号;tests/ 是 checker 的自测台架,故意构造违例场景确认断言真的会响、静默场景确认断言不误报。没有自测的 checker 不允许进库——一条从来没能被触发过的断言,和没有断言的检出能力是一样的。
编译组织上,库的文件列表独立于 RTL filelist,项目编译脚本里两行引入:先编 checkers/,再编本项目实例化后的 bind 文件。综合流程完全不接触这两个目录,从机制上杜绝「断言混入网表」这类事故。跨时钟域同步器这类有专用检查模板的场景(见 CDC 同步器检查),同样遵循这个目录结构,按检查主题各成文件。
五、跨项目复用:版本、回归与信任
库建起来只是开始,真正的复用考验在第二个、第三个项目接入时。这里有一套从实际项目里磨出来的纪律。
版本化。checker 库进独立的 git 仓库(或主仓库的独立子目录加 tag),版本号语义化:改默认参数、删断言是破坏性变更,升 major;新增断言组、新增参数(带默认值)是兼容变更,升 minor。项目侧在编译脚本里 pin 住版本号,绝不允许「永远用最新」——库里修一条断言,三个项目回归行为同时变化,排查时根本说不清是谁变了。
变更评审。checker 库的每次修改需要两个视角的评审:验证视角看检查语义对不对,使用方视角看会不会让已有项目产生新的违例。后一条常被忽略。做法是库里维护一套「金标准回归」:用 tests/ 下的自测台架加一两个代表性设计的集成环境,库的任何修改必须金标准全绿才能合入。
违例报告的信任链。复用最大的敌人不是技术问题,是信任流失:某版本 checker 在一两个项目上误报过,团队就会形成「这库的检查不用当真」的集体记忆,之后真违例也被忽略。对抗手段有两条:一是误报必须作为库的最高优先级 bug 修复并记录;二是每个项目接入时先跑一轮「已知好设计」的基线回归,零违例后才算接入完成。这与 回归管理与问题分类 里讲的 triage 流程衔接——库违例单独成一个类别,不混进 RTL 缺陷流。
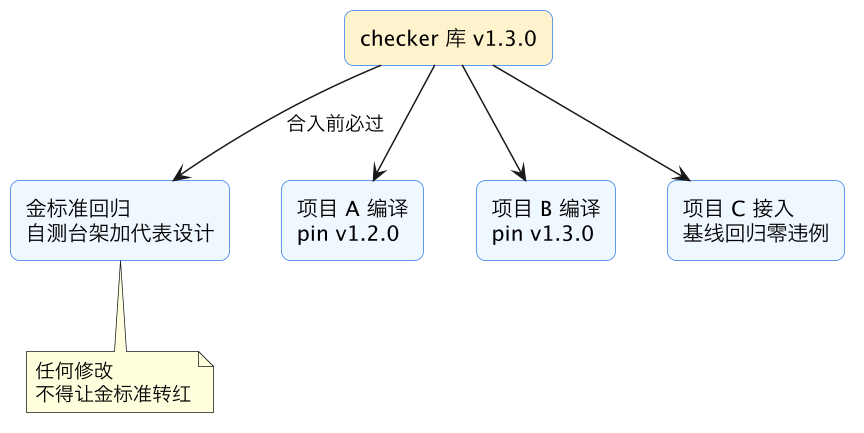
上图是版本与回归的关系:库的任何演进先过金标准,项目各自 pin 版本按需升级,新项目接入以基线零违例为准入。三条线互相独立,升级节奏由各项目自己掌握。
最后说覆盖率闭环。库里的 cover property 不是摆设——跨项目汇总 cover 数据,能回答一个管理者真正关心的问题:「这套检查在我们所有芯片上真的被激活过吗?」长期 cover 不命中的条目要么是死场景(删掉),要么暴露激励盲区(反馈给激励侧补场景)。这个反馈环让库越用越锋利,而不是越堆越臃肿。
形式验证场景下库的价值还会放大。因为 checker 端口只接 RTL 信号、不依赖任何 testbench 对象,同一个 checker 模块在仿真里被 bind 进设计,在形式工具里可以直接作为约束与检查的目标复用——assert 变 proof goal,部分检查反过来用 assume 约束环境,这套 assert/assume/cover 的形式化分工见 assert/assume/cover 与形式验证。很多团队是反过来走的:形式环境先写好一套性质,仿真侧重新抄一遍,两份渐行渐远。入库的 checker 从第一天就按「双工具可消化」的标准写,这条路就始终是通的。
六、常见坑清单
把团队几年的踩坑记录压缩成一张表,新接入 checker 库时逐条自查:
| 坑 | 症状 | 处理 |
|---|---|---|
| 端口接 testbench 对象 | 形式工具编译即挂 | 端口只接 RTL 信号 |
| 默认参数激进 | 新项目接入满屏假违例 | 默认值取最宽松配置 |
| 缺 disable iff | 复位期违例风暴 | 门控层统一处理,禁止散写 |
| 零端口层次引用 | 换工具即解析失败 | 一律显式端口连接 |
| 库永远用最新 | 三项目回归同时变脸 | pin 版本号,升级走评审 |
| cover 与 assert 分离 | 「测到过没有」无据可查 | 三件套成对写进断言组 |
| 项目私有检查入库 | 其他项目被迫 waiver | 私有检查留在项目 bind 层 |
这一篇在知识体系里的位置
本篇属于验证工程化主线上的「资产沉淀」环节:单条断言的语法见 SVA 断言完全指南,挂接机制见 SVA bind 绑定,本篇讲怎么把这些点状能力组织成可复用的库;横向看,环境级复用是同一个思想在 UVM 侧的投影,见 UVM 环境纵向与横向复用 与 testbench 分层架构与复用;库建好之后如何融入签核,衔接 验证计划与覆盖率映射 与 回归管理与问题分类。
总结
断言库复用的本质是把 SVA 从「项目里散落的检查语句」升级为「独立版本化的验证 IP」:checker 模块按端口层、门控层、断言组、参数层四段式封装,结构性差异走参数、策略性差异走开关、项目私有差异不进库,bind 模板加检查文档加自测台架三件套随库交付,跨项目复用靠 pin 版本、金标准回归和基线零违例三条纪律维持信任——做到这些,下一个项目的协议检查成本就从「重写」降为「复制一份 bind 文件」。