UVM 覆盖率模型、收敛与签核
更新时间:2026-10-01。已有 代码与功能覆盖率 和收敛流程单篇,本文聚焦“覆盖率模型怎么设计、什么叫真正收敛签核”。
本文要回答的问题
- 功能覆盖点应该从哪里来,写多少算够?
- 高覆盖率为什么也可能漏功能?
- 怎么从“没命中的 bin”驱动验证收敛?
一、覆盖点来自验证计划
功能覆盖不是把字段都抄一遍,而是把验证计划里承诺要验证的场景映射成 coverpoint:关键状态、操作类型、边界值、字段交叉。先有 testplan 再建 covergroup,覆盖的是“需求点”而非“数据结构”。
covergroup cg_op @(posedge clk);
  cp_op: coverpoint tr.op { bins rd={0}; bins wr={1};
                           illegal_bins bad={2,3}; }
  cp_len: coverpoint tr.len { bins s={[1:4]}; bins l={[5:16]}; }
  cx: cross cp_op, cp_len;
endgroupbins定义要命中的场景,illegal_bins/ignore_bins标记非法或不关心,非法 bin 命中即报错。cross覆盖组合,但维度爆炸时要有选择,避免无意义组合稀释注意力。
二、功能覆盖 vs 代码覆盖
代码覆盖(行/翻转/状态机/分支)衡量“代码被执行到没”,由工具自动;功能覆盖衡量“需求场景被验证没”,需人工设计。二者互补:代码覆盖高不代表关键组合都验证过,功能覆盖达到也可能有没执行到的代码。签核通常要求两者都达标并解释残余。
三、收敛闭环
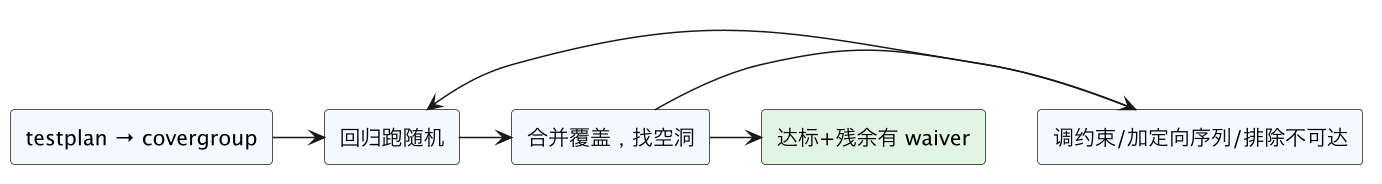
命中不了的 bin 要分类:是约束没生成(调约束/加 seed)、需要特定序列(写定向 sequence)、还是物理上不可达(合理 ignore 并说明)。简单提高随机次数掩盖不了设计/约束缺陷。
四、合并、排除与签核
跨多机/多种子回归合并覆盖率;对确定不相关逻辑做可追溯的排除(waiver)而非默默忽略。签核标准应预先定义(如功能覆盖 100% 可命中项、代码覆盖阈值、未命中项均有解释)。
五、常见坑
- 为字段而覆盖,cross 爆炸却和需求无关。
- 只看总百分比,不看具体空洞。
- 把不可达 bin 硬凑或无记录 ignore。
- 功能/代码覆盖只追一个。
- 不同 seed 覆盖不合并,低估真实进度。
小结
覆盖模型源自验证计划,功能/代码覆盖互补,收敛靠“找空洞→分类处理”闭环,签核需达标且残余可解释。下一篇 回归管理与失败分诊。
总结
功能覆盖率要“到位”而不是凑数字:覆盖点必须来自验证计划里承诺验证的需求场景(关键状态、操作类型、边界、字段交叉),先有 testplan 再建 covergroup,覆盖需求而非数据结构;bins 定义要命中的场景、illegal_bins 命中即报错、cross 覆盖组合但要克制避免维度爆炸。功能覆盖与代码覆盖互补——代码覆盖(行/翻转/状态/分支)量“代码执行到没”、工具自动生成,功能覆盖量“需求场景验证没”、需人工设计,任一单高都可能漏,签核要求两者都达标。收敛闭环是:回归跑随机 → 合并多种子覆盖 → 找空洞 → 对未命中 bin 分类处理(约束没生成就调约束/加 seed、需特定序列就写定向 sequence、物理不可达就可追溯地 ignore),简单提高随机次数掩盖不了缺陷;残余项必须有 waiver 和解释。