FPGA 专家 31:AI 推理加速——把张量计算铺成数据流动的阵列
本文是
fpga/专家层第 34 篇。定点化方法论见 专家 33,roofline/卸载边界见 专家 31,HLS 实现见 专家 19。
一、为什么推理适合 FPGA
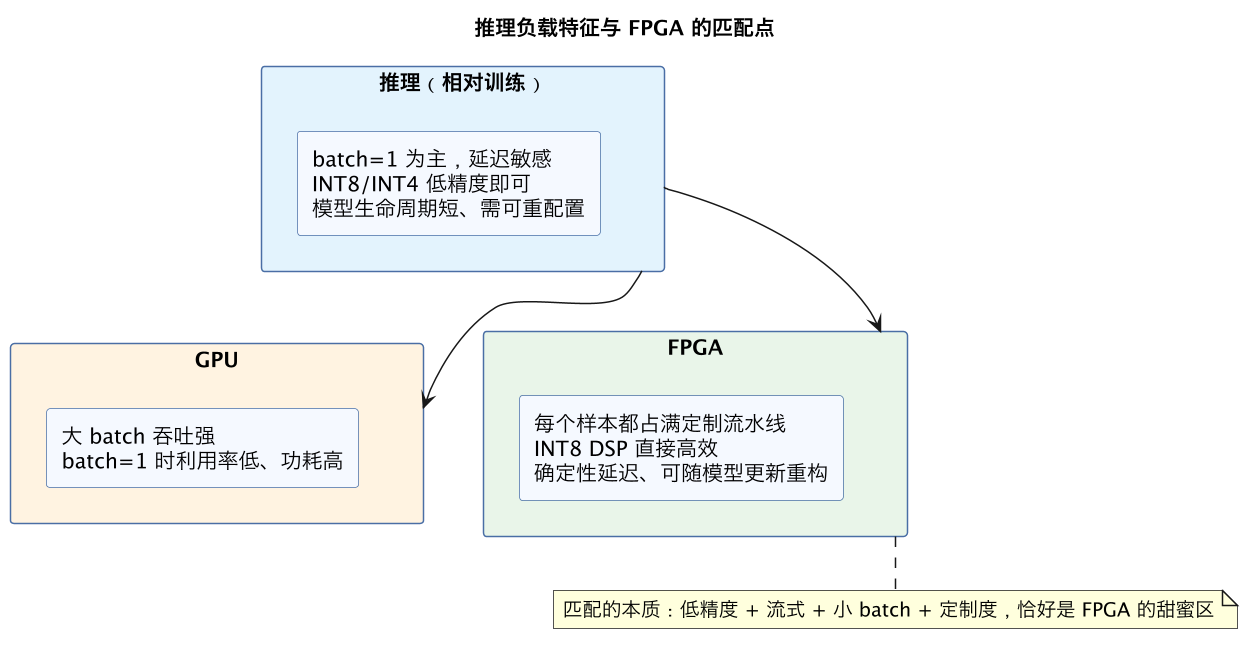
| 训练 | 推理 | |
|---|---|---|
| 方向 | 前向+反向,梯度更新 | 只前向 |
| batch | 大 | 常为 1(实时) |
| 数值 | FP16/BF16 | INT8/INT4 可接受 |
| 要求 | 吞吐、生态 | 延迟确定性、能效、紧耦合 |
二、量化:用任务指标验收
浮点权重/激活 ──校准集统计范围──► scale(+zp) ──► 定点算子 ──► 任务指标
                                       ▲
                  敏感层保留 FP16(混合精度)/ 不达标转 QAT
三、脉动阵列:让数据在 PE 间流动复用
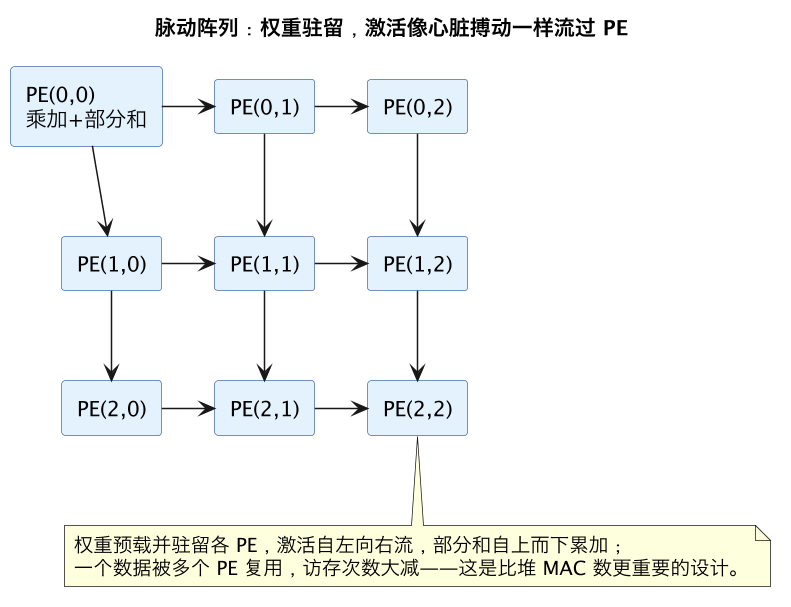
       w 固定在 PE 内
 a0→ [PE]→[PE]→[PE]
 a1→ [PE]→[PE]→[PE]    激活横向流、部分和纵向累加
 a2→ [PE]→[PE]→[PE]
            ↓ 每数被多次复用 → 省访存、易跑高频
按模型形状选数据流(WS/OS/IS),按片上容量分块,配合权重双缓冲/乒乓喂满阵列。
四、三种实现路线
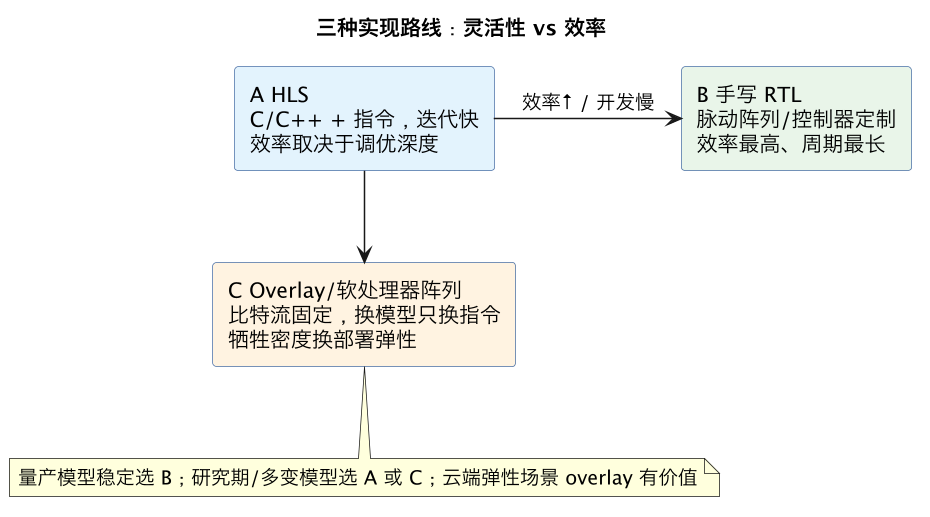
- DPU + Vitis AI:框架模型 → ONNX → 量化/编译 → 指令;标准算子快,非标算子回退 RTL/HLS。
- AI Engine(Versal):向量核阵列,C 可编程、吞吐高,适合信号+AI 融合。
- 手写 HLS/RTL 阵列:固定模型、极致效率/成本时才做。
落地难点多在"周边":动态 shape、reshape/concat、softmax、后处理与前后处理流水线。
五、性能与选型
盯 MAC 利用率与权重带宽:大模型常 memory-bound,靠分块、权重驻留、混合精度平衡;效率闭环用片上计数器核对 roofline 预估。GPU 赢生态/峰值/训练,FPGA 赢确定延迟/能效/前后处理同片紧耦合与定制精度。
六、量化深入:校准、非均匀量化与感知训练
量化是 FPGA 推理的第一杠杆,因为它同时压缩存储、减少搬运(推理常受带宽限制)、并把宽浮点乘加换成窄整数乘加(INT8 一个 DSP 可容纳多路乘法,吞吐成倍提升)。要把量化做对,必须区分两条路线和它们的工程含义。**训练后量化(PTQ)**不需要重训,只用一小批有代表性的校准数据统计激活的取值范围,据此确定缩放因子(scale),几小时内能把浮点模型转成 INT8,成本最低,是 FPGA 部署的默认起点;**量化感知训练(QAT)**在前向时模拟量化噪声、反向时用直通估计(STE)让权重“学会”在量化下工作,精度更高但要动训练流程。经验上,常见 CNN/MLP 的 INT8 PTQ 精度损失通常很小(1% 上下),但深度可分离卷积、检测/分割头、小模型、注意力等对量化敏感,往往要 QAT 或部分层保高精度。
scale 怎么定直接决定精度。最简单的 per-layer(整层共用一个 scale、非对称还要 zero-point)实现容易但对分布不均的特征图不友好;per-channel(每个输出通道独立 scale)对权重量化几乎是标配,能显著降低卷积核动态范围差异带来的误差;激活侧进一步可做 per-tensor 甚至分组。标定方法上,max(取最大绝对值)容易被离群值带偏(一个异常大值把整个分布压到很少几个量化级),因此常用 moving-average、百分位/分位数裁剪(clip 掉极端尾部)、或熵最小化(如 KL 散度搜索最优裁剪阈值,经典校准方法)。离群激活是 PTQ 的头号杀手:某几个通道偶发极大值使其余 99% 的有效分辨率骤降。对策包括逐通道/逐 token 缩放、SmoothQuant 一类把激活的难度迁移到权重(激活难量化、权重量化噪声容忍度高)的数学变换、以及关键层保 FP16/BF16 或 INT16 的混合精度。
非均匀与极低比特在 FPGA 上要谨慎看待。INT4/三值/二值网络在学术上压缩惊人,但硬件上“非均匀/低比特”并不天然友好:二进制/三值乘法确实可退化为选择/异或门,能效极高,但精度通常只在特定任务成立且需 QAT;非均匀(对数域、codebook)量化在编码上省位宽,却要求查表/编解码,破坏规则的阵列乘法,FPGA 上往往得不偿失。实用甜点仍是规则的 INT8(部分 INT16/FP16),因为它与 DSP 位宽、AXI 位宽、整齐的脉动阵列天然契合。对 FPGA,“规则、可拼成阵列、可预测”比“理论压缩率最高”更重要,这与 ASIC 上追求极致低比特的取向不同。
量化的正确性验证要贯穿全链:量化后模型先在框架侧跑任务指标验收(不是看逐层误差而是看最终精度/mAP/召回);导出时保证 folding(把 BN、ReLU、偏置折叠进卷积权重)和 scale 对齐(权重、激活、累加器之间的小数点/scale 换算)正确;硬件侧用 bit-true 模型(见 专家 33)逐层对拍。常见 bug 不是量化理论错,而是 scale 的小数点位在矩阵相乘、累加、反量化时换算错位,结果差一个固定倍数。还要把量化误差与真实部署的激活分布绑定——用真实场景数据校准,用训练集校准会因分布漂移而过度乐观。
动态/在线量化与稀疏是进阶话题。运行时按每批数据动态算 scale 能适应分布漂移,但在数据通路里插入了求最大值和除法,破坏固定流水线,通常只在确实有漂移的传感/长尾场景用。结构化稀疏(整通道为零)对 FPGA 有真实价值(可跳通道、省算力和带宽),非结构化稀疏则需要硬件索引和解码支持,规则阵列上收益常被开销吃掉,要按 roofline 实测而非按理论零值比例估算。把这些选择与任务指标、硬件结构、roofline 三者联动决策,量化才是工程杠杆而不是赌博。
七、脉动阵列微架构:权重驻留、数据流与复用模式
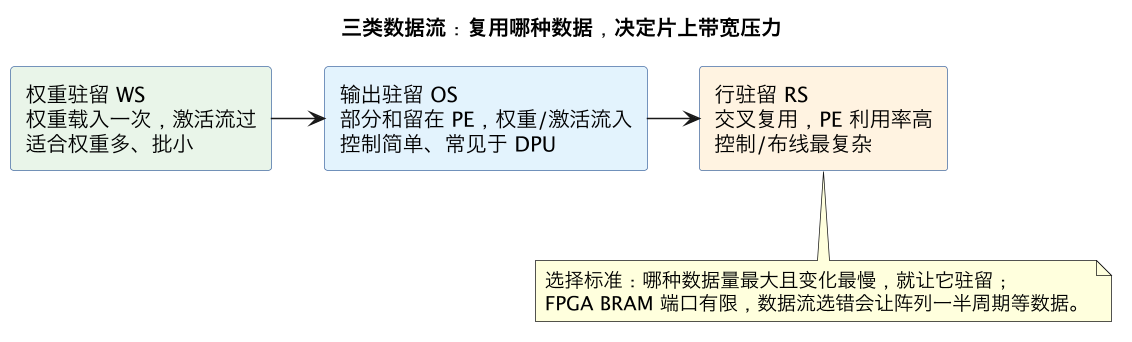
矩阵乘法是神经网络的主体,FPGA 上把它做到高吞吐的典型结构是脉动阵列(systolic array):一个 PE(处理单元)二维网格,数据以精心安排的节奏在相邻 PE 间流动,每个 PE 在每拍做一次乘加并把数据或部分和传给邻居。它的魅力在于数据在阵列内部被反复复用,几乎不访问外部存储——这正好命中神经网络“计算极密、数据复用极高”的特征,也直接回应 roofline 对运算强度的要求。理解脉动阵列,关键是理解“什么数据停住、什么数据流动、部分和如何累积”。
三种经典**数据流(dataflow)**对应复用不同的量。权重驻留(weight-stationary, WS):权重预先载入并留在 PE 本地寄存器里,激活从一侧流入、穿过阵列,部分和沿另一方向累加。权重被复用最充分(读一次用很多次),控制直观,是最常见的 CNN/矩阵乘结构。输出驻留(output-stationary, OS):每个 PE 负责一个输出元素,权重和激活都流过来,部分和在该 PE 本地累加直到完成,减少了部分和的搬运、利于做深累加,但权重/激活的供给更复杂。行驻留(row-stationary):让权重行、激活行、部分和分别沿不同方向脉动,试图在同一阵列里同时复用三类数据,能效高但控制和映射复杂。选型本质是权衡哪类数据最昂贵(最缺带宽)就让它驻留复用最多。
卷积到矩阵乘的映射决定阵列利用率。全连接/1×1 卷积天然是 GEMM;普通卷积常用 im2col(把每个卷积窗口展开成列,卷积变矩阵乘)但会产生数据复制(一个像素被多个窗口共享,展开后重复存放),FPGA 上更常用片上行缓冲(line buffer)+ 窗口广播,在不物理复制的情况下复用邻域数据,运算强度更高。多通道、多输出特征图被切成适合阵列维度的块(tiling):阵列通常是 M×N,一个维度映射输出通道、另一个映射输入通道或空间维度,靠循环分块让工作集(权重块、输入块、部分和块)落进片上 BRAM/URAM。利用率取决于块大小能否整除阵列维度和问题维度:真实网络层形状千奇百怪(小 batch、小通道数、非 2 的幂),阵列边缘常出现 PE 空转,因此标称 TOPS 与有效 TOPS 差距很大,必须按目标网络的逐层形状算平均利用率,而不是用一个大方阵的峰值自我安慰。
PE 内部和阵列边界有大量决定频率与资源的细节:乘法用 DSP 还是 LUT(INT8 可让一个 DSP 干多个乘法,但要核对该器件 DSP 的位宽和预加器能力);累加器位宽 = 输入位宽×2 + 对数(累加次数),漏算会溢出;部分和在阵列底部/侧边用加法树归并,归并网络可能成为新关键路径;激活函数(ReLU 易,sigmoid/softmax/GeLU 难)通常放在阵列外用查表或分段多项式实现;归一化/缩放尽量折叠进权重以避免运行时除法。阵列越大,时钟越难收敛、布线越拥塞,且规模越大对“块整除”越敏感——很多高效设计宁可多个中等阵列并行,也不追求一个巨型阵列。
与存储层级的协同是阵列真正跑满的前提。权重从 DDR→片上权重缓冲→PE 本地寄存器的供给要连续无气泡;激活在层间尽量留在片上(层融合:卷积→BN→ReLU→池化在数据流过时一次做完,不把中间特征图写回 DDR);双缓冲(ping-pong)让“当前块计算”和“下一块搬运”重叠,掩盖 DDR 延迟。凡是每算一小块就要停下来等 DDR 的设计,阵列再大也只跑到带宽上限。评估一个推理加速器,正确顺序是:按目标网络算 roofline 和逐层运算强度→定数据流和驻留策略→按典型层形状定阵列维度与分块→设计双缓冲与层融合把搬运藏起来→用真实模型逐层仿真有效利用率,而不是先画一个大阵列再找数据喂。
八、存储层次、模型压缩与多模型支持
推理系统的性能和成本往往不由峰值算力决定,而由权重和激活在 DDR、片上 SRAM、PE 寄存器之间的搬运决定。这一节把存储层次、压缩和“一个加速器如何服务多个模型/层”放在一起讲,因为它们本质上是同一个问题:如何用有限的片上存储和外部带宽,让数据在被用到时刚好就在近处。
先建立量化的字节预算。一个未经压缩的模型,权重可能几 MB 到上百 MB,远超片上 BRAM/URAM 容量(通常几 MB 量级,且还要留给激活和中间值),因此权重常驻 DDR、分层或分块载入;而单层激活在合理 batch 下往往能部分或全部进片上。关键机会是层间融合与中间结果不落盘:卷积、归一化、激活、池化、逐元素加(残差)若在一次数据穿过流水线时完成,中间张量就不必写回 DDR 再读出,省下的是两层外部访存。算子融合(operator fusion)是推理加速器性价比最高的优化,常比加 PE 更有效,与 专家 31 强调的“把字节算够本”完全一致。Transformer 类模型还要处理 KV cache 随序列增长,需要专门的片上/近存储组织。
权重压缩在带宽受限时有直接收益。INT8 量化本身就是 4 倍压缩;结构化剪枝(把整个通道/头裁掉并微调恢复)能真正减少计算和规则搬运,FPGA 友好;权重共享/聚类 + 索引表、低秩分解(把大矩阵分解成两个瘦矩阵)对特定层有效但会引入不规则性和额外运算。压缩必须与硬件解码能力匹配:非结构化稀疏的“稀疏权重 + 坐标索引”在通用阵列上需要复杂的 gather 和负载均衡,理论稀疏度高但实测加速常打折;块稀疏/结构化稀疏才容易映射成“跳过整块、阵列规整运行”。工程上应只采用硬件能零成本或低成本解码、且能实测降低延迟/带宽的压缩,而不是看到参数减少就采用。
多模型、多网络支持是产品化绕不开的需求,有三种由僵到活的实现策略。其一固定数据通路:把一类网络(如固定的 CNN 拓扑)烧死成流水线,效率最高、延迟最低,但换模型/换拓扑要重新综合,适合大批量单一功能(传感器里的固定检测模型)。其二参数化、运行时可配:数据通路设计成处理一组算子原语(Conv/FC/Pool/激活…),权重、层形状、参数从内存加载,控制器按“网络描述(指令/张量描述符)”逐调度——同一比特流可跑任意由这些原语构成的模型,这是大多数推理加速卡的形态,代价是控制面复杂、对不规则算子利用率下降。其三部分重配置(PR):不同模型/算子作为可动态加载的分区,按需换入换出,兼顾灵活度和效率,但重配置有延迟、分区边界固定、流程复杂,适合模型集合有限且切换不频繁的场景。更前沿的是可重构数据流/覆盖架构(overlay),用软定义的粗粒度阵列兼顾灵活性,但通常有频率和效率折损。
控制面与运行时因此不可缺位(与 专家 31 呼应):需要一个编译器/映射器把训练框架的模型(ONNX 等 IR)编译成加速器的指令/张量描述符序列,决定分块、片上摆放、算子融合、双缓冲调度;运行时负责权重加载、描述符提交、完成同步。工具链的成熟度往往比峰值 TOPS 更决定真实可用性和上模型的速度——一个需要手工为每层写 RTL 的“高指标”加速器,产品价值可能远低于指标普通但能自动吃 ONNX 的方案。选型时务必评估“新模型从训练框架到上板”的端到端时间。
精度模式与数值格式也要按网络演进前瞻选择:除 INT8 外,越来越多网络需要 BF16/FP16 甚至块浮点(block floating point,一组数共享指数)兼顾动态范围与整数 MAC 效率;FPGA 的 DSP 对特定浮点格式支持因代而异。设计时把数据位宽和算子类型参数化、留出混合精度(敏感层高精度、其余 INT8)的能力,能显著延长一个加速器对新模型的适应寿命,避免一代模型(如新的归一化/激活函数)就让硬件报废。
九、三种实现路线对比与上板验收
把 FPGA 推理的实现路线摆开,各自的能力、成本和适用场景差别很大,选错路线会让团队在错误的抽象层上耗费数月。
路线一:手写 RTL(Verilog/VHDL/Chisel/SpinalHDL)。直接设计 PE 阵列、控制器、DMA,资源和时序控制最精细,效率上限最高、延迟最低、可塞入最苛刻的资源/功耗预算。代价是开发与验证周期长、门槛高、换模型可能要改硬件、团队稀缺。适用:大批量、固定或收敛的模型族、对单卡成本/延迟/功耗极度敏感(量产边缘设备、高频低延迟推理),且模型拓扑在产品生命周期内相对稳定。
路线二:高层综合(HLS,C/C++/SystemC 加 pragma)。用软件语言写算子,靠 pipeline/unroll/array_partition/dataflow 等指示引导硬件,仿真快、迭代快、能与算法共享 C 模型做 bit-true,工程师上手门槛低于 RTL。代价是对复杂控制和最优数据搬运的掌控不如手写,极致频率/资源常需 RTL 老手回炉,且“写得像普通 C”的 HLS 往往生成低效硬件(关键是按硬件思维组织数据流,见 专家 33)。适用:算法快速迭代、算子级加速、中小团队、需要在精度/位宽/并行度上频繁探索的研发期,也是大量原型的主力。
路线三:推理框架/覆盖架构(厂商 DNN 库、第三方加速器 IP、softcore overlay)。直接喂量化后的模型,工具自动分层、调度、生成比特流或运行在预置可重构阵列上,上模型最快、软件团队即可驱动、生态持续更新支持新算子。代价是灵活性被框架支持的算子/模型范围限制,峰值效率通常低于纯手写,资源占用和调度是黑盒,遇到不支持的算子要退回 HLS/RTL 定制。适用:模型种类多、迭代快、上市时间优先、团队偏软件的云端/数据中心场景,以及先做 PoC 验证价值再决定是否 RTL 固化。
一个成熟团队往往分层混用:框架/HLS 快速验证并承担易变部分,确证的热点算子或固定数据通路用 RTL 做到最优,通过标准 AXI 接口集成;新模型先用框架跑通、profiling 定位瓶颈、只把瓶颈下沉定制。无论哪条路线,决策都应回到统一的验收口径,避免被峰值 TOPS 营销误导。
上板验收清单(按此逐项实测):①端到端吞吐用真实 batch 和真实模型测性能(帧/秒、token/秒、单帧延迟、P99 延迟),而非阵列峰值 TOPS;②逐层利用率与 roofline 对比,找出空转/等存储的层并优化分块、融合、双缓冲;③精度在真实数据上对比量化前后的最终任务指标(mAP/准确率/召回),含 corner case 和分布漂移样本;④bit-true:硬件输出与量化模型逐层对拍通过;⑤带宽实测:DDR/PCIe 有效利用率,确认瓶颈归属(host 传输 vs 片上 vs 算力);⑥资源与时序:LUT/FF/BRAM/URAM/DSP 占用有裕量、目标频率时序收敛、多模型/PR 分区能装下;⑦并发与控制面:多请求/多模型排队、运行时加载、完成与错误语义正确;⑧长期稳定性:连续推理无误差累积/挂死、温度功耗在限内、有性能/错误计数器;⑨模型更新路径:新模型从框架到上板的全流程时间可接受;⑩与 GPU/CPU 的端到端 TCO 对比(含开发成本、功耗、单价、批量、延迟)成立。用这份验收而非峰值参数拍板,才能确保 FPGA 推理真正“更快/更省/更确定”,而不只是“能跑”。
十、Transformer 与大模型推理的 FPGA 视角
大语言模型把推理负载的重心从卷积转向了超大矩阵乘加注意力机制,这改变了 FPGA 推理架构的几乎所有假设,也需要冷静评估 FPGA 在这条赛道上的真实位置。先看计算特征:Transformer 的主体是批量矩阵乘(注意力的 Q/K/V 投影、输出投影、前馈网络两层),算术强度随序列和批量而变;真正的麻烦不在矩阵乘本身(它是规则的、脉动阵列友好的),而在访存、非线性算子和变长序列。
访存是第一矛盾。权重规模从几 GB 到几十上百 GB,片上放不下,推理往往是带宽受限而非算力受限:每生成一个 token 都要把相关权重读一遍(decode 阶段批量小、强度低),HBM 容量/带宽和片外权重搬运成为主瓶颈,FPGA 卡常见的 DDR 配置在大模型上先天吃亏,只有配 HBM 的高端平台才进入可讨论区间。KV cache 随上下文线性增长,需要分层管理(片上放最近窗口、片外放历史)、按注意力机制做高效读取,并为它预留大量高带宽存储——这部分架构在传统 CNN 加速器里根本不存在。
非线性与数据格式是第二矛盾。Softmax、LayerNorm/RMSNorm、GeLU/SiLU、RoPE 位置编码、GELU 门控这些算子包含除法、指数、平方根、归约,不适合脉动阵列,要用查表、分段多项式或专用向量单元,且必须与主矩阵乘流水重叠,否则它们成为串行尾巴;数值格式上,BF16/FP16、FP8、各类块浮点和权重量化(INT8/INT4 weight-only)快速演进,离群激活处理(类似 SmoothQuant 的通道缩放、按 token 动态量化)必不可少。FPGA 的 DSP 对这些格式的支持随代际差别很大,格式一变硬件就要重做,生态成熟度远不如 GPU。
变长与调度是第三矛盾。自回归生成本质是逐 token 的串行依赖(下一步依赖上一步输出),decode 阶段算子小、批量低、控制复杂,与 FPGA 擅长的大批量规则流不匹配;prefill(处理输入 prompt)反而是大矩阵乘、高并行,两个阶段特性完全不同,常需分别优化或用连续批处理(continuous batching)在运行时拼批。调度器、KV cache 管理、推测解码(speculative decoding)、分页注意力这类系统技术主要活在软件栈里,FPGA 只有在配合成熟 runtime、且作为标准矩阵乘/注意力卸载设备时才有现实意义。
冷静的结论是:前沿大模型训练和主力推理是 GPU/专用 ASIC 的舞台,FPGA 的现实机会在边缘/私有化部署的中小模型(权重可放进板载 HBM 或有限 DDR、批量小但要求低延迟确定性、需要定制预处理/后处理和加密)、流式长序列里把注意力与前端信号处理融合、以及在数据格式和模型结构尚未收敛的窗口里做快速架构探索。把 FPGA 当“小 GPU”硬拼大模型显存带宽和软件生态几乎必输;按“确定性、定制化、端侧融合”的差异化定位才有赢面。
十一、推理系统的端到端工程:预处理、调度与服务化
一个推理产品交付的不是一个卷积核,而是一条完整服务链,FPGA 只负责其中“模型执行”一段,系统性能常常被它之外的环节决定。端到端视角至少包括:输入获取(摄像头/网络/总线)、预处理(缩放、色彩空间转换、归一化、裁剪)、模型执行、后处理(NMS、解码、阈值、结构化)、结果输出与业务联动,以及多请求的调度和服务管理。
预处理/后处理往往占掉意外多的时间。软件做图像缩放和归一化要吃 CPU 且引入拷贝;成熟方案把它们做成 FPGA 入口的流式硬件(一个像素流进来,边到边缩放转格式,直接喂推理核),输出端把 NMS/解码这类规则性强的部分也硬件化,主机只处理稀疏的最终结果。判据仍然是数据量:凡是全分辨率、每帧都要做、规则固定的操作,硬件化收益大;稀疏、策略多变、需要业务知识的决策留给软件。整条链应避免“硬件算得快,但数据在主机内存里来回拷了三次”——这正是控制面/数据面分离和零拷贝原则(见 专家 29、专家 31)在推理场景的复述。
批处理与延迟的权衡是调度核心。增大 batch 能摊薄权重读取、提高阵列利用率和吞吐,但排队等待成批本身增加延迟,实时检测/控制场景常常强制 batch 为 1。架构应支持两档:实时档单帧直通(浅缓冲、固定延迟),吞吐档攒批执行(高利用率),由调度器按 SLA 动态选择。多模型/多路视频共用一个加速器时,需要时分调度、上下文保护(权重切换成本——权重在 DDR 时换模型开销大,在片上分区常驻则受容量限制)和 QoS(某一路不能被其他路饿死),这本质上又回到了带优先级的队列和有界调度问题。
服务化与运维:推理设备作为网络服务时要有健康检查、模型版本管理(多模型灰度、可回滚,呼应 专家 46 的发布纪律)、输入输出的监控与漂移检测(现场数据分布变化会让量化模型悄悄掉点)、以及结果和版本的关联(每条推理结果可追溯到模型与比特流版本)。资源隔离上,多路租户或业务不能互相踩控制寄存器和缓冲区。这些“非推理”需求决定了设备能不能真正进生产,却几乎不出现在 benchmark 里。
十二、基准测试的诚实性:别被 TOPS 营销误导
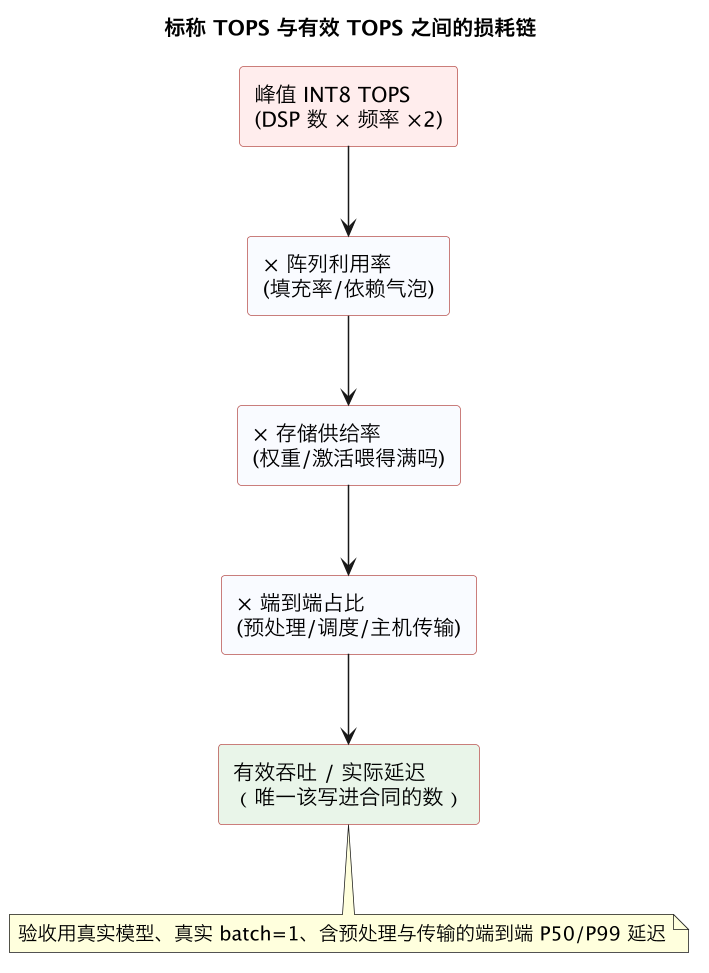
AI 加速器领域最容易失真的就是性能数字。选型和验收时必须穿透标称指标,建立一套诚实的基准方法,否则“纸面 TOPS 很高、实际帧率很低”几乎是必然。
标称峰值几乎不可达。峰值 TOPS 通常假设所有 DSP/PE 每周期都做有效乘加、数据无限供给、不统计非线性算子和控制开销;真实模型有层间切换、填充(padding)、非理想尺寸、激活/权重搬运、softmax 等串行操作。正确指标是在具体模型、具体精度、具体批量和分辨率下的有效吞吐(帧/秒、token/秒、推理/秒)和端到端延迟(输入进入设备到结果可用,含预处理、搬运、后处理),并同时报告硬件利用率(有效乘加/理论乘加)。对比 GPU/CPU 也必须在同一模型、同一精度(量化对精度的影响要单独标注)、同一输入规模下做端到端对比,而不是峰值对峰值。
精度对比要带任务指标。INT8 不是“FP32 的免费高速档”,验收要给量化前后的最终业务指标(mAP、召回、误报率、词错率)及在现场数据集上的分布,而不只是逐层误差;混合精度、敏感层保高精度的方案要在指标里体现收益。还要报告尾延迟和确定性:平均延迟对实时业务意义有限,P99/最大值、随温度和并发的抖动才是 FPGA 相对 GPU 的主要差异化卖点,应作为一等指标实测。
能效与总拥有成本:数据中心和边缘都应报性能/瓦(在真实供电边界测整机功耗,不是只看芯片热设计功耗),边缘还要看推理/毫焦;TCO 含开发人力、工具链授权、模型更新成本和供货周期——一个指标极高但每换模型都要三个月重综合的方案,整体可能远劣于灵活方案。基准应可复现:固定比特流/驱动/模型版本、固定数据集、脚本化运行、结果归档进 CI(见 专家 46),让每次改动后的性能和精度变化都能回归对比。
一套实用验收问题:目标网络逐层的利用率是多少、最低的层卡在哪(带宽还是边界)?去掉主机搬运后纯硬件时间与端到端时间差多少?batch=1 延迟多少、P99 多少?量化在现场数据上掉点多少、温度拉满后性能/稳定性如何?换一个模型/分辨率要改多少东西、重新综合多久?这些数字凑齐,才是一次基于事实而非基于营销的 AI 加速选型。
总结
FPGA AI 推理靠"INT8 量化换密度 + 脉动阵列换数据复用 + DPU/AIE 换开发效率":精度用校准/混合精度/QAT 按任务指标守住,瓶颈用 roofline 和 MAC 利用率定位,选型在实时边缘紧耦合场景选 FPGA、大模型训练与高吞吐选 GPU。