UVM compare 与 do_compare:字段自动化、比较器策略与自定义比对
更新时间:2026-09-28。scoreboard 比对在 UVM sequence、driver 与 scoreboard 的协作 里只被一句话带过——「把期望事务和实际事务 compare 一下」。这一篇把这一句展开:compare 到底走了什么调用链、
uvm_comparer能调哪些策略、宏自动生成的比对长什么样、什么情况下必须手写do_compare。拷贝语义见 SystemVerilog 对象拷贝:浅拷贝、深拷贝与 clone,两篇是姊妹篇。
本文要回答的问题
- scoreboard 里一句
exp_tr.compare(act_tr),底层究竟经过了哪几个函数? uvm_comparer的 policy、show_max、miscompares 都是干什么的,什么时候要换掉默认比较器?`uvm_field_int这类宏是怎么把do_compare自动写出来的?代价是什么?- 哪些字段不该参与比对,怎么干净地把它们排除?
一、compare 的调用链:从入口到钩子
UVM 的比对不是一锤子「逐位相等」,而是一条可定制的调用链。scoreboard 里最常用的写法:
if (!exp_tr.compare(act_tr)) begin
  `uvm_error("MISMATCH", $sformatf("exp:\n%s\nact:\n%s",
              exp_tr.sprint(), act_tr.sprint()))
end
compare 是 uvm_object 的公开入口,但它自己几乎不干活,真正的比对逻辑分散在三个层级:
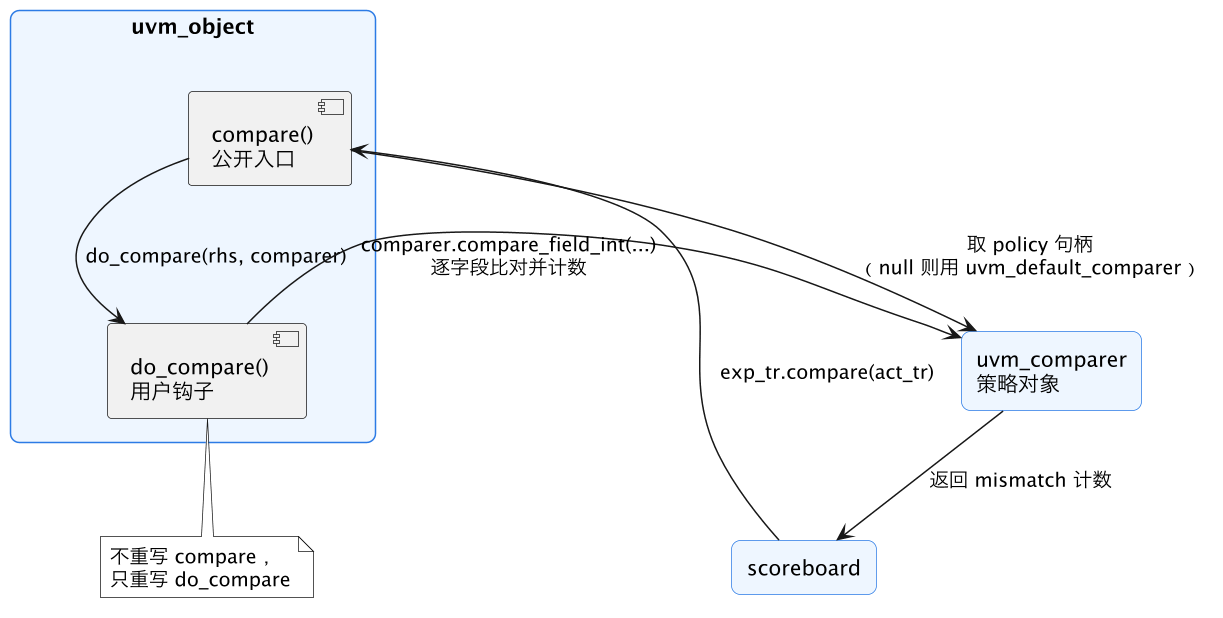
读这条链抓住三个分工:compare 负责「开场」——接收可选的比较器参数、判 null、然后把活转交给 do_compare;do_compare 是留给用户的钩子函数,要么由宏自动生成,要么手写;uvm_comparer 是策略对象,负责单个字段怎么比、错了怎么记、记多少条之后停。返回值语义是「比对通过与否」:compare 返回 1 表示一致,不一致的同时把详细 mismatch 记录留在 comparer 里。
有一个约定必须守住:永远不要重写 compare 本身,只重写 do_compare。copy/clone、print、pack 一族全是同样的「入口 + do_xxx 钩子」模式,重写入口会破坏基类里对 null 比较器、递归保护等公共逻辑的处理。
二、uvm_comparer:比对的策略中心
默认情况下 compare 不传第二个参数,底层就用全局单例 uvm_default_comparer。它有几个值得知道的开关:
| 成员 | 默认值 | 作用 |
|---|---|---|
policy | UVM_COMPARE | 比对策略:逐值比(UVM_COMPARE)、仅引用相等(UVM_REFERENCE) |
show_max | 1 | 最多打印多少条 mismatch,超过后只计数不打印 |
result | 0 | 累计 mismatch 条数,本次比对期间累加 |
miscompares | "" | 所有 mismatch 的文本记录 |
verbosity | UVM_LOW | mismatch 消息的报告冗余度 |
sev | UVM_ERROR | mismatch 的严重级别 |
compare_field_int(...) 等 | — | 各类型的单字段比对方法,do_compare 里逐字段调用 |
show_max 是回归里最有用的一个:一个 bit 翻转可能引起一帧里几十个字节全错,默认只打第一条、其余静默计数,日志不至于被刷屏。想自己控制策略,就 new 一个 comparer 传进去:
uvm_comparer my_cmp = new;
my_cmp.show_max = 5;
my_cmp.sev      = UVM_WARNING;   // 容忍性比对:错了只告警
if (!exp_tr.compare(act_tr, my_cmp)) ...典型用途有两个:一是容忍性比对(比如 timestamp 类字段允许抖动,scoreboard 只警告不报错);二是同一事务多处比对时隔离计数——每个 scoreboard 用自己的 comparer 实例,mismatch 记录互不串味。注意 result 不会自动清零,复用同一个 comparer 做多次比对前要手动 result = 0(或用 flush 风格封装),否则第二次的返回值会被前一次的记录污染。
三、字段自动化宏:do_compare 的免费午餐
绝大多数 sequence item 不需要手写任何比对代码。声明字段时挂上宏,do_compare、do_copy、do_print 全部自动生成:
class axi_txn extends uvm_sequence_item;
  rand bit [31:0] addr;
  rand bit [31:0] data [];
  rand bit [3:0]  strb;
       bit [63:0] timestamp;   // 采集时刻,不参与比对

  `uvm_object_utils_begin(axi_txn)
    `uvm_field_int(addr,                 UVM_ALL_ON)
    `uvm_field_array_int(data,           UVM_ALL_ON)
    `uvm_field_int(strb,                 UVM_ALL_ON)
    `uvm_field_int(timestamp,            UVM_ALL_ON | UVM_NOCOMPARE)
  `uvm_object_utils_end
endclass宏的第二个参数是标志位掩码,每个字段独立控制四种自动化行为的开关:UVM_COPY、UVM_COMPARE、UVM_PRINT、UVM_PACK。UVM_ALL_ON 全开,按位或去掉某一项即可——上面 timestamp 用 UVM_NOCOMPARE 把它踢出比对(保留拷贝和打印),这正是处理「每次采集都不同、不能比」字段的标准手法。同理,UVM_NOPRINT 常用于密钥类字段,UVM_NOPACK 用于超大数组避免打包开销。
宏自动生成的 do_compare 逻辑等价于:
function bit axi_txn::do_compare(uvm_object rhs, uvm_comparer comparer);
  axi_txn rhs_;
  do_compare = 1;
  if (!$cast(rhs_, rhs)) return 0;
  do_compare &= comparer.compare_field_int("addr", addr, rhs_.addr, 32);
  do_compare &= comparer.compare_field("data", data, rhs_.data, 32);
  do_compare &= comparer.compare_field_int("strb", strb, rhs_.strb, 4);
  // timestamp 因 NOCOMPARE 被宏跳过
endfunction注意到一个细节:自动生成的代码先 $cast 再逐字段比,类型对不上直接返回 0。这意味着 compare 是类型敏感的——父类句柄指向的子类对象之间做 compare,宏版本只比父类已知的字段,子类扩展字段若忘了在子类里补宏,会静默漏比。
宏的代价也要心里有数:逐字段走 comparer 的虚函数调用,性能比手写 == 慢;且宏展开依赖字段声明顺序,重构时调整字段顺序不影响正确性,但 mismatch 报告里的字段顺序会变。对绝大多数 item 这都不是问题,只有百万级事务的高频比对路径才值得考虑手写。
再补一个常被忽略的标志位细节:UVM_NOCOMPARE 是「这个字段永远不要比」的静态声明,适合时间戳、随机种子、采集序号这类每次仿真必然不同的字段。但如果一个字段「在配置 A 下要比、配置 B 下不要比」,静态标志位就无能为力了——要么声明时保守地标上 UVM_NOCOMPARE,再在 do_compare 里手写条件比对补回来;要么干脆不挂这个字段的宏,全程手写。两种路线都能走,关键是选一种并在一处收敛,最怕宏里开了一半、手写又补了一半,review 时谁也说不清这个字段到底比没比。忽略字段还有第三个选项:比对前把两边的该字段都清零再 compare。这个做法看似省事,实际上污染了事务本身——比对之后还想打印或覆用这条事务时,字段已经被改掉,属于典型的「为了比对修改证据」,不推荐。
policy 一栏里的 UVM_REFERENCE 也值得一说:它只比句柄引用是否指向同一对象,不比内容。这在对「配置对象」做一致性检查时有意义——你关心的不是两个配置对象字段值碰巧相等,而是 driver 拿到的确实就是 test 下发的那一份。对 sequence item 几乎用不到,知道存在即可。
四、什么时候手写 do_compare
宏覆盖不了时,就该自己接管。三个典型场景:容差比对(浮点或时间戳允许误差带)、条件比对(某些字段只在特定模式下有效)、跨字段一致性(比如 length 必须等于 data.size() 才有比对意义)。
function bit axi_txn::do_compare(uvm_object rhs, uvm_comparer comparer);
  axi_txn rhs_;
  do_compare = super.do_compare(rhs, comparer);  // 先比父类字段
  if (!$cast(rhs_, rhs)) return 0;

  do_compare &= comparer.compare_field_int("addr", addr, rhs_.addr, 32);

  // 容差:timestamp 差 2 拍以内算通过
  if (!((timestamp - rhs_.timestamp) inside {[-2:2]})) begin
    comparer.result++;
    do_compare = 0;
  end

  // 条件:仅写事务比对 strb
  if (kind == WRITE)
    do_compare &= comparer.compare_field_int("strb", strb, rhs_.strb, 4);
endfunction手写时三条纪律:第一,先调 super.do_compare,父类字段的比对不丢;第二,通过 comparer 记录失败(result++ 或 compare_field_xxx),不要自己 uvm_error——报告策略是 comparer 的职责,越权发消息会绕过 show_max 控制;第三,返回值的与累积,任何一个字段失败最终都要反映到返回值上,scoreboard 靠它分支。
还有一个容易踩的坑:do_compare 的 rhs 参数是 uvm_object,别忘了 $cast;cast 失败要返回 0 而不是 uvm_fatal——类型不匹配本身就是一种 mismatch,让它走正常报告路径。
容差比对里最典型的是浮点字段。SystemVerilog 的 real 类型走宏自动比对时按位精确比较,而 DUT 与参考模型之间常有舍入路径差异——参考模型用双精度算,RTL 用定点逼近,最后一位几乎必然不同。这类字段必须在 do_compare 里改成「差的绝对值小于 epsilon 即通过」,epsilon 按数据通路精度量级取,一般比预期误差大一到两个数量级,留出余量又不足以掩盖真 bug。掩码比对是另一个高频需求:总线响应里的状态位、ECC 校验位、保留位往往不应参与逐位比较,标准做法是先 & mask 再丢给 compare_field_int,掩码作为 item 的成员随配置下发,不要写死在比对函数里——同一套 item 在不同 test 下关心的位段可能不同。
手写场景还有一个隐形收益:失败信息的可读性。宏自动生成的 mismatch 报告格式统一但信息单薄,只告诉你哪个字段、期望值多少、实际值多少。手写比对时可以在记录失败的地方附上业务语义,比如「第 3 拍数据的 CRC 与重算值不符,疑似写通路干扰」,回归 triage 时这条消息能让定位时间从小时级降到分钟级。做法是在 comparer.result++ 的同时把诊断文本拼进 miscompares,或者先用 compare_field_int 拿到结果再在失败分支里补充说明——两者都不破坏 comparer 的计数与 show_max 机制。
五、在 scoreboard 里的正确姿势
把上面所有点收拢到 scoreboard 的落地写法:
function void my_scoreboard::check_phase(uvm_phase phase);
  axi_txn exp, act;
  while (exp_q.size() && act_q.size()) begin
    exp = exp_q.pop_front();
    act = act_q.pop_front();
    if (!exp.compare(act, cmp)) begin
      `uvm_error("SB_MIS", {"mismatch:\n", cmp.miscompares})
    end
    cmp.result = 0;            // 复用 comparer,清计数
    cmp.miscompares = "";
  end
endfunction
比对之前的队列攒对、乱序对齐属于另一套话题,见 UVM scoreboard 的追踪与对齐 和 SystemVerilog scoreboard 的队列实现;本篇只保证「拿到一对事务后,比对这一步做对」。
最后说一个回归量级下的经验:比对失败的调试成本,一半花在「找到 mismatch」,另一半花在「读懂 mismatch」。前者靠 show_max 和清晰的字段名,后者靠 sprint 出来的事务可读性——所以 do_compare 的调优往往要和 do_print/convert2string 一起做:字段名对齐、十六进制按位宽补齐、枚举转字符串,这些看似排版的小事,在凌晨三点翻日志时都是实打实的效率。comparer 的 miscompares 串在比对失败后要第一时间打出来,不要攒到 check_phase 结束统一倒——多对事务连续失败时,混在一起的长串几乎无法对应回具体事务。
这一篇在知识体系里的位置
- 协作全景:UVM sequence、driver 与 scoreboard 的协作 说明 compare 在数据流里的位置。
- 拷贝语义:SystemVerilog 对象拷贝:浅拷贝、深拷贝与 clone 是同族「do_xxx 钩子」的另一篇,比对常与拷贝配套出现。
- 对齐前置:UVM scoreboard 的追踪与对齐 解决「比哪两个」的问题,本篇解决「怎么比」。
总结
UVM compare 是「入口 + 钩子 + 策略」三段式:compare 开场、do_compare 干活、uvm_comparer 管策略与计数;普通 item 用 `uvm_field_* 宏加 UVM_NOCOMPARE 等标志位即可获得全字段自动比对,遇到容差、条件、跨字段一致性才手写 do_compare——守住「先 super、经 comparer 记录、cast 失败返回 0」三条纪律,比对既准确又不刷屏。