FPGA 进阶 33:HLS 优化——pipeline/unroll/dataflow 与存储分区
本文是
fpga/进阶层第 37 篇。指令基础见 HLS 入门。HLS 优化的思路和手写 RTL 的流水线与资源优化完全同构——时间并行、空间并行、存储带宽、数据搬运四件事。
本文要回答的问题
- PIPELINE/UNROLL/DATAFLOW 分别是什么并行?代价是什么?
- II 压不到 1 时怎么定位瓶颈?
- 数组为什么要分区?block/cyclic/complete 怎么选?
- 优化迭代的正确顺序是什么?
一、三个并行杠杆
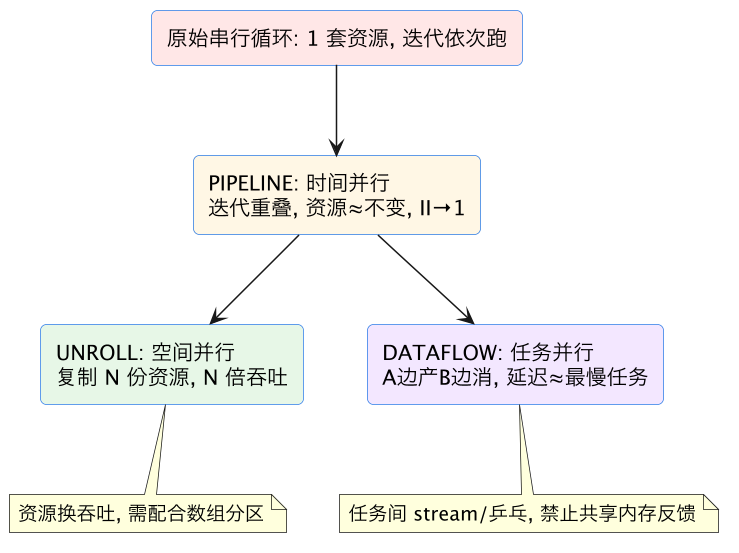
| 指令 | 并行类型 | 吞吐收益 | 资源代价 | 前提 |
|---|---|---|---|---|
PIPELINE II=1 | 时间(流水) | II 从循环延迟→1 | 几乎不增 | 存储/依赖/接口喂得饱 |
UNROLL(完全/部分) | 空间(复制) | N 路并行 | N 份运算+存储端口 | 数组同步分区 |
DATAFLOW | 任务级 | 多任务重叠 | FIFO/乒乓缓存 | 单向流式数据传递 |
二、II 压不下去:三类瓶颈
PIPELINE 后看综合报告 'II achieved' vs 'II requested',达不到时报告给出瓶颈:
- 存储端口瓶颈:循环每拍读 4 个元素,一块 BRAM 只有 2 口 → 分区:cpp
#pragma HLS ARRAY_PARTITION variable=buf cyclic factor=2 dim=1complete:全拆成寄存器,并行度无限、最费 LUT/FF;block:连续段切块(适合按段访问);cyclic:交错分块(适合多通道轮询);factor=块数。
- 循环携带依赖(loop-carried):
acc += a[i]*b[i]这类累加,每轮依赖上轮;多为部分展开+多个部分和(树状累加)缩短依赖链; - 接口/搬运:stream 反压、m_axi 未突发——连续访问模式让工具合并 burst,DATAFLOW 预取。
三、存储整形:PARTITION vs RESHAPE
- PARTITION:一块大数组拆成多块小 BRAM/寄存器,增加并行读写端口数(为 UNROLL/高 II 服务);
- RESHAPE:不拆块,但把多个元素合并进一个更宽的字(如 16 个 8bit→4 个 32bit),一次访问读多个元素,端口数不变、单次读得更多。
经验:小系数表/抽头窗 → complete 成寄存器;大帧缓冲 → 留 BRAM/DDR,靠分块+突发提高带宽。
四、数据搬运与 roofline
HLS IP 的实际性能上限 = min(算力, 接口带宽)。先估:
- 算力:DSP 数 × 频率 / 每样本所需乘法数;
- 带宽:每进出字节数 × 吞吐率,对比 m_axi 位宽 × 频率(如 128bit×150M≈2.4GB/s 理论,突发效率再打折)。
带宽不够时:压缩数据位宽、减少中间结果往返 DDR(任务合并/片上缓存复用)、多个 m_axi 口并行、DATAFLOW 让计算与搬运重叠。
五、推荐优化顺序
- 定接口与数据格式:stream 流式、axilite 配置、数组走 m_axi 且访问连续;
- 内层循环 PIPELINE II=1:解决存储分区/依赖直到报告达标;
- DATAFLOW:把读入→计算→写出拆成流式任务并行;
- 外层 UNROLL:还需更高吞吐时空间复制,同步分区数组,盯资源报告;
- cosim 复核:周期级仿真确认真实 II/延迟/反压行为;
- 迭代到满足吞吐且 DSP/BRAM/LUT 在预算内(与 FPGA 功耗估计联动)。
常见坑对照
| 坑 | 后果 | 正确做法 |
|---|---|---|
| 不看 II 报告就认为流水成功 | 实际 II>1、性能差 | 每次综合看 achieved II 与瓶颈 |
| UNROLL 不分区数组 | 存储端口卡死,UNROLL 白做 | UNROLL 配 ARRAY_PARTITION |
| 任务间共享大数组 | DATAFLOW 失败/回退串行 | 用 stream 或乒乓缓冲单向传递 |
| m_axi 随机跳地址 | 无法突发、带宽极低 | 访问连续化、合并 burst |
| complete 分区大数组 | LUT/FF 爆炸 | 大数组 block/cyclic 或留 BRAM |
| 累加链不处理 | II 被依赖链锁死 | 部分和树状累加 |
| 忽略反压/ FIFO 深度 | cosim 卡死或丢数 | 配足 FIFO、cosim 验证 |
相关与延伸
前置:HLS 入门、流水线与资源优化、AXI4 与带宽。 取舍深论见专家层《HLS 深水区》《HLS 与手写 RTL》。
一句话总结
HLS 优化四个杠杆:PIPELINE 是时间并行(迭代重叠、资源几乎不增、II→1,性价比最高);UNROLL 是空间并行(复制 N 份运算单元,必须同步 ARRAY_PARTITION 拆数组喂端口);DATAFLOW 是任务并行(多任务流式重叠、延迟≈最慢任务,要求单向 stream/乒乓、禁共享内存);ARRAY_PARTITION/RESHAPE 是存储整形(complete→寄存器无限并行最费、block/cyclic→多块 BRAM 增端口、reshape 加宽字)。方法论:定接口(stream/m_axi 连续突发)→ 内层 PIPELINE 拿 II=1 → 按报告瓶颈(存储端口/携带依赖/接口)逐个解 → DATAFLOW 任务并行 → 仍不够再 UNROLL,每步看综合报告的 achieved II/资源并用 cosim 周期级复核;最后用 roofline 判断瓶颈是算力还是带宽——接口不够时优化计算毫无意义。