英伟达 AI 产品矩阵全解:H100、B200、GB200 NVL72 到底怎么排
最后更新:2026-09-19|数据截止 2026 年中:已上市世代的规格为已公布值,2026 下半年之后(含 Rubin 平台)为官方路线图与量级估计,以正式发布为准。
本文是产业观察,不堆参数表,而是回答:面对 H100、H200、B200、GB200、NVL72 这一堆名字,怎么一眼看出它们在矩阵里的位置、卖给谁、英伟达靠这套排列怎么赚钱。 晶体管与封装原理属芯片/FPGA 工程篇,本文只讲产品层级、世代节奏和商业模式。它是另两篇的延伸:国产 AI 芯片与算力管制 讲「为什么管制、卡在哪几道墙」,HBM 与先进封装 讲「这些卡为何被 HBM 和 CoWoS 卡脖子」,而本文先把「被卡的产品本身」讲清楚。
先说结论
- 英伟达卖给数据中心的不是一颗芯片,而是「芯片 → 模组 → 基板/整机 → 机柜」四个越包越大的层级。 越往上层走,单台售价越高、客户越省事、英伟达拿走的价值也越多。看懂一个名字先问它处在哪一层。
- 世代用架构代号 + 数字表达,节奏基本是一年一代。 A(Ampere,安培)→ H(Hopper,霍普)→ B(Blackwell,布莱克韦尔)→ R(Rubin,鲁宾,路线图);同一代里再用 SXM/PCIe 区分形态、用后缀区分市场(如出口特供)。
- 竞争的最小单位正从「一张卡」变成「一个机柜」。 GB200 NVL72 把 72 颗 GPU、36 颗 CPU、NVLink 交换、供电和液冷打包成一个整体交付,客户买的不再是零件而是「通电就能训的算力块」——这是英伟达抬高客单价、加深锁定的关键一跃。
- 出口管制倒逼出一条「特供卡」支线。 A800、H800、H20 都是同一代芯片在「单卡算力 / 互联带宽 / 显存」上被定向削减的版本;管制打的不是单点峰值,而是万卡集群所需的高速互联(详见管制篇)。
一句话:这套矩阵表面是芯片型号表,底层是一台精密的商业机器——用年度架构升级逼人换机,用整柜化提升单笔交易额,用 NVLink/CUDA 把客户锁在自己的体系里。 下面逐层拆。
一、为什么值得先读懂这张产品表
在工程语境里,GPU(Graphics Processing Unit,图形处理器;AI 语境指承担大规模并行乘加的通用加速卡)的优劣常被简化成几个数字:算力多少 FLOPS(每秒浮点运算次数)、显存多大、带宽多高。但站在产业视角,参数表年年换,稳定的是「产品怎么分层、怎么命名、怎么捆绑销售」这套结构。 读懂结构有三个实际用处:
- 看新闻不被名字绕晕。 「发布 GB300」与「发布 Rubin」是不同性质的消息:前者是当代产品的显存/配置升级版,后者是下一代架构平台;分不清,就会把路线图当成现货。
- 看懂管制和短缺卡在哪。 出口管制、台积电 CoWoS 产能、HBM 分配,都按具体产品层级生效;不知道 NVL72 里有多少 GPU、多少 HBM,就无法理解「一个机柜为什么值几百万美元、为什么交货要排一年」。
- 判断国产替代对标哪一层。 国产 AI 芯片多数能对标「单卡」,越往上(高速互联、整柜、软件)差距越大——这正是 国产 AI 芯片与算力管制 所说「买得到的卡、买不到的生态」的产品侧注脚。
所以本文按「先分层级、再排世代、再看特供、最后读商业」展开,让你以后看到任何新名字,都能自己把它放回正确的格子里。
二、先分层级:芯片、模组、基板、机柜
英伟达数据中心产品最容易让人困惑的地方,是它在四个不同抽象层级上都卖东西,而且名字看起来差不多。从下往上依次是:
| 层级 | 形态 | 典型名字 | 客户买到的东西 |
|---|---|---|---|
| ① 芯片/单封装 | 一颗带显存的计算封装 | H100、B200 | 最核心的算力单元(个人一般买不到) |
| ② 加速卡/模组 | 芯片 + 板卡 + 供电散热 | H100 PCIe、H100 SXM | 一张可插进服务器的卡 |
| ③ 基板/整机 | 4 或 8 卡组成的 GPU 基板或整机 | HGX H100、DGX B200 | 一台现成的 AI 服务器 |
| ④ 机柜 | 数十颗 GPU + CPU + 互联 + 供电液冷 | GB200 NVL72 | 一个即插即用的「算力机柜」 |
下面这张图标出「越往上越整、越贵、越锁定」的关系(本文配图,非实物照片):
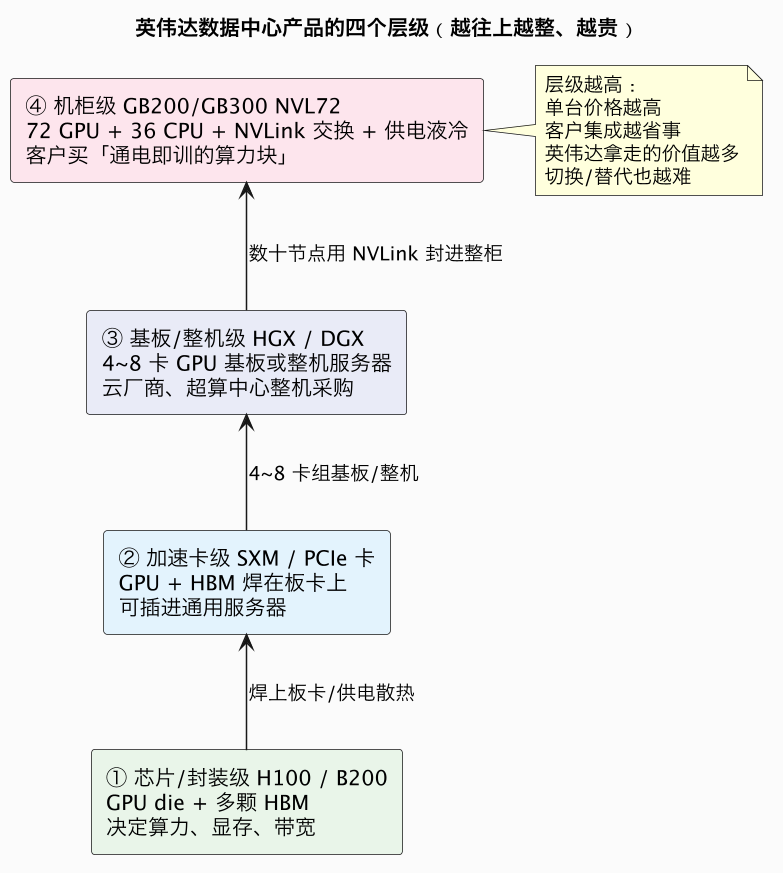
这张图正是英伟达商业模式的骨架,逐层看:
① 芯片/封装级是算力源头:一颗 GPU 逻辑芯片(die)旁用先进封装贴着多颗 HBM(High Bandwidth Memory,高带宽内存,用 TSV 硅通孔三维堆叠的显存,详见 HBM 与先进封装)。H100、B200 首先指这一层的芯片设计。
② 加速卡级把芯片做成能插的卡,分两种形态:SXM(英伟达专用的高功耗、高带宽模组规格)与 PCIe(通用服务器插槽,Peripheral Component Interconnect Express,外围高速互连总线)。同颗芯片 SXM 版功耗更高、NVLink 互联更完整,PCIe 版更易塞进存量服务器。
③ 基板/整机级把 4~8 颗 SXM 卡焊在一块 GPU 基板(baseboard)上配 CPU:HGX 卖给云厂商/ODM(原始设计制造商,再贴牌造整机)做「准系统」,DGX 是英伟达自定义的「参考整机」。客户买回去就是一台现成 AI 服务器。
④ 机柜级是最新、最关键的一跃。GB200 NVL72(72 指机柜内 GPU 数量)把 72 颗 Blackwell GPU、36 颗 Grace CPU、NVLink 交换网络、整套供电和液冷打进一个标准机柜整体交付——客户买到的是通电、接光纤就能用的「算力块」。
关键判断:竞争和采购的最小单位,正从「一张卡」变成「一个机柜」。 这把原本属于服务器 ODM(工业富联、广达等)和集成商的系统价值收进英伟达的定义,也意味着单 GPU 的国产替代短期难覆盖整柜级系统竞争。第五章会反复用到这一条。
三、再排世代:A、H、B、R 一年一代的节奏
看懂层级之后,再看型号里的「字母」。数据中心旗舰卡的世代,用架构代号的首字母表示,近年的主线是:
| 代号 | 架构名 | 代表 GPU | 同期 CPU/整柜 | 数据中心世代的关键变化 |
|---|---|---|---|---|
| A | Ampere(安培) | A100、A800(特供) | DGX A100 | 上一代主力,奠定数据中心 GPU 标准 |
| H | Hopper(霍普) | H100、H200、H800/H20(特供) | HGX H100、H200 | H100 是这轮生成式 AI 爆发的「通用货币」;H200 主要升级 HBM 容量/带宽 |
| B | Blackwell(布莱克韦尔) | B100/B200、GB200 | GB200 NVL72、B300(升级) | 双芯封装 + NVLink 升级 + 整柜化,单机柜性能数量级跃升 |
| R | Rubin(鲁宾) | 路线图 | Rubin 机柜平台 | 下一代,官方路线图阶段,规格以正式发布为准 |
读这张表有三个要点。
第一,同代里不同数字往往是「定位」而非「新旧」。 例如 Blackwell 代的 B100 与 B200,B200 是更高规格(功耗、算力、配置更满)的一档;H 代里 H100 是首发旗舰、H200 则是「沿用 Hopper 架构、把显存从 HBM3 升到 HBM3E、容量更大」的增强版。看到「数字变大」不要简单等同于「架构换代」——H100→H200 是同代增强,H100→B200 才是跨代。
第二,GB 是「Grace CPU + Blackwell GPU」的组合封装。 名字里的 G 来自英伟达自研的 Grace 数据中心 CPU。GB200 不是一颗纯 GPU,而是把 Grace CPU 和 Blackwell GPU 用超高带宽封装在一起的「超级芯片(superchip)」,再用 72 个这样的单元组成 NVL72 机柜。理解这点,才能理解为什么整柜级产品的名字是 GB 打头、而单卡是 B 打头。
第三,年度节奏本身就是商业武器。 一年一代的可预期升级,让云厂商形成「今年不买、明年落后一代」的采购节奏,也让二手与租赁价格随发布快速重置——英伟达把「摩尔定律预期」变成了「客户换机纪律」。这对客户意味着昂贵的 GPU 资产折旧很快(与 大模型的算力账单 的折旧口径直接相关)。
还有一层容易被忽略:跨代平台不只是多买几张卡,而是机房要跟着改。 从八卡 DGX 走向 NVL 整柜,供电、散热、承重、布线都要重做——这正是 A1/A2/A4 那组「接电、液冷、供电」独立产业被单柜上百千瓦的产品逼出来的原因(同批规划)。
四、SXM 与 PCIe:同一颗芯片的两种卖法
确定芯片世代后,还要确认形态。同代旗舰几乎总有 SXM 和 PCIe 两版,区别不只是插槽:
| 维度 | SXM 模组 | PCIe 卡 |
|---|---|---|
| 形态 | 英伟达专用高速模组,直接装到 HGX 基板 | 标准 PCIe 插槽,通用服务器可插 |
| 典型功耗档 | 更高(旗舰常达 700W 级) | 相对低一档 |
| GPU 间互联 | NVLink 全互联,带宽最高 | 通常无 NVLink 或仅有限支持,走 PCIe |
| 适用场景 | 大规模训练、紧耦合多卡 | 推理、通用加速、存量机房改造 |
| 集成门槛 | 需 HGX/DGX 整套 | 插进现有服务器即可 |
这里第一次出现后面要反复用到的两个词:
- NVLink:英伟达自研的 GPU 高速互联总线(总线是芯片之间传数据的通道)。多卡训练时,GPU 之间要频繁交换梯度和中间结果,互联带宽直接决定多卡能否像「一颗大 GPU」一样协同。SXM + NVLink 全互联是旗舰训练系统的标配。
- PCIe:通用标准,好处是「哪台服务器都能插」,代价是带宽远低于 NVLink。
这就解释了一个常见现象:推理卡、存量机房改造更爱买 PCIe 版,而新建的万卡训练集群几乎清一色 SXM + NVLink 的 HGX/整柜方案。 也解释了出口管制为什么把「互联带宽」单列成一道墙——把 NVLink 带宽砍到阈值以下,单卡峰值或许还在,但万卡级训练集群的效率会被显著拉低,这正是 国产 AI 芯片与算力管制 的核心论点之一。
五、NVL72 与整柜战略:把「组网」也收进自己手里
如果说 HGX 是「八卡一台机」,那么 NVL 整柜就是「把几十台机的互联也预先做好」。以 GB200 NVL72 为代表,它的关键不在单颗芯片,而在把整个机柜定义成一个产品。
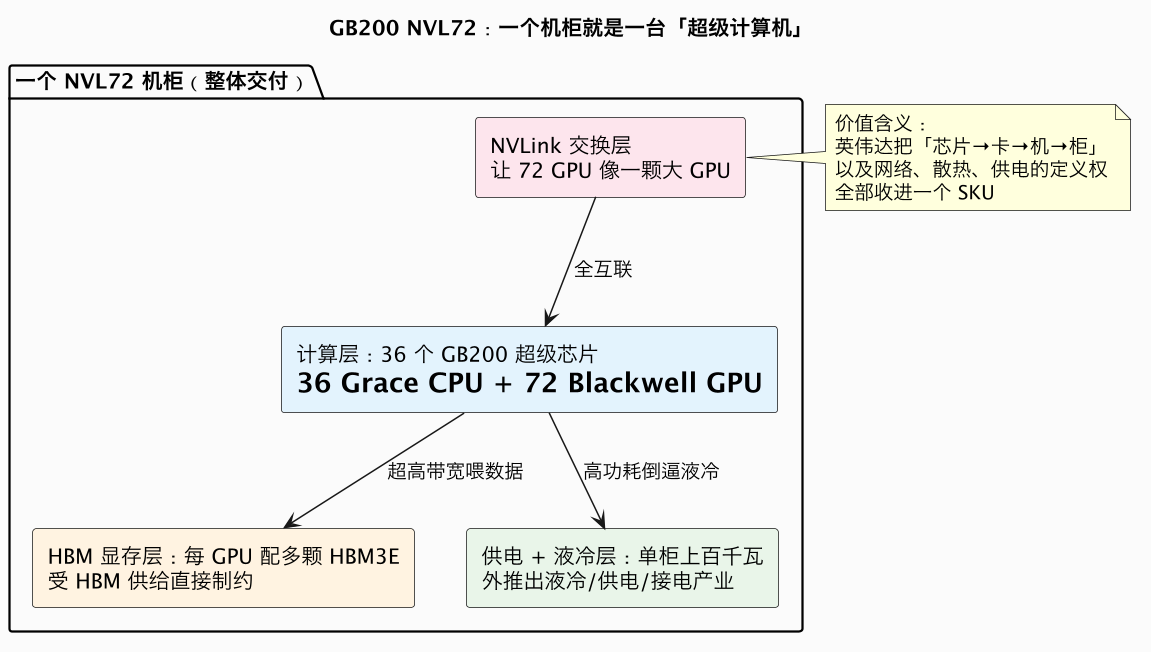
图里每层都对应一门生意,这就是为什么「一颗 GPU」的新闻会牵动整条产业链:
- NVLink 交换层:72 颗 GPU 经 NVLink/NVSwitch(盒内交换芯片)全互联。把「组网」从客户的工程难题变成英伟达的内置能力,是整柜战略最深的意图——AMD、国产芯片即便单卡性能够,也难在「开箱即用的万卡域」上对等竞争(开放阵营正用 UALink 等标准回应,见同批互联篇)。
- 计算层:36 个 GB200 超级芯片(Grace CPU + 双 Blackwell GPU)构成 72 GPU;CPU 用自家 Grace,顺带把数据中心 CPU 也带入捆绑。
- HBM 显存层:整柜 HBM 用量极大,这正是英伟达要提前向 SK 海力士/三星/美光锁产能、而 HBM 又是最大供给瓶颈的原因,机制见 HBM 与先进封装。
- 供电液冷层:单柜上百千瓦,风冷难撑,液冷、高压直流成为必选——每卖出一个 NVL 机柜,就同时为液冷、电源、供电创造一份配套订单,上游产业是被整柜规格「算」出来的。
商业含义:整柜化让英伟达更像「卖算力块的平台公司」。单笔合同从「按卡计价」跃升到「按柜计价」(满配 NVL72 是百万美元级资本开支),客户一旦按 NVL72 设计机房,扩容、备件、软件都会沿同一体系滚动,锁定极深。
六、特供卡支线:A800、H800、H20 是怎么来的
理解了「层级 + 世代 + 形态」,就能看懂一条由管制倒逼出来的特殊产品线。2022 年以来美国对华先进计算芯片出口管制,按「单卡算力」和「互联带宽(性能密度)」等指标划线;英伟达为了合规继续供货中国,就把同代芯片定向削减后推出「中国特供版」:
| 特供型号 | 对应正代 | 被定向削减的能力 | 管制想打掉的用途 |
|---|---|---|---|
| A800 | A100 | GPU 间互联带宽大幅降低 | 大规模训练集群的多卡协同 |
| H800 | H100 | 主要砍 NVLink 互联带宽 | 万卡训练的高效互联 |
| H20 | Hopper 代 | 主打合规算力上限,保留大显存、互联受限 | 限制训练、保留部分推理市场 |
读这张表要抓住一个反直觉点:管制最在意的往往不是「单张卡有多快」,而是「很多张卡能不能高效连成一台超级计算机」。 训练前沿大模型靠上万卡长时间协同,互联带宽、集群通信、软件栈缺一不可;只削单卡峰值而保留高速互联,训练集群仍能堆出来。所以规则后来从「单卡算力」升级到同时限制「互联带宽/性能密度」,专打集群能力(三轮管制完整复盘见 国产 AI 芯片与算力管制)。产品侧有三个后果:
- 特供卡是「合规边界上的产品」,政策一变就可能停售或再改,采购方要承担「下一轮管制后无法持续扩容」的风险。
- 它常被设计成「推理可用、训练受限」,与「推理先破、训练最难」的产业判断互为表里。
- 它给国产芯片留出的主要是训练替代窗口——昇腾、寒武纪、海光等(同批规划有专门一篇盘点)主攻的正是拿不到满血集群时用国产卡顶上。
注意口径:特供卡的具体规格与是否在售会随政策与发布调整,本文只描述其产品逻辑(削互联、保部分推理),具体某型号当前能否采购,以厂商和官方规则原文为准。
七、矩阵背后:这是一台怎样的商业机器
把产品表读到底,会发现英伟达的护城河不是任何单一参数,而是矩阵本身的设计,它同时做四件事:
1)年度架构升级 = 客户换机纪律。 A→H→B→R 的可预期节奏让「不升级就落后一代」成为共识,GPU 成为快速折旧、持续追加的资本开支,与 大模型的算力账单「训练门票 + 推理房租」互相强化。
2)整柜化 = 抬高单笔交易额。 从卡到 HGX 再到 NVL72,英伟达把原本分给服务器厂、集成商的系统增值收进自己的 SKU(Stock Keeping Unit,标准化交付型号),数据中心收入越来越多由「高价值系统出货量」而非单纯芯片销量决定。
3)NVLink/NVSwitch = 把组网锁进体系。 单卡可被对标,但「72 卡像一颗大 GPU」的开箱互联连同整柜供电散热,是长期工程积累;UALink、AI 原生以太网想撬动的正是这层,但从协议到大规模量产验证需要时间。
4)CUDA 与软件栈让硬件锁定可持续。 迁移真正的成本是十几年积累的 CUDA 代码、算子库、调优与人才;产品越整、网络越封闭,软件锁定越难破(量化见同批 C7 专文)。
四件事叠加的结果:英伟达卖的不是芯片,而是「确定性」——确定能跑通的软件、确定能交付的整柜、确定能排到的产能(前提是接受它的体系与价格)。下游越怕在 AI 军备竞赛里掉队,越愿意为这份确定性付费。
八、实操:以后看到一个新名字,怎么快速归位
给读者一个可复用的判断流程,四步就能把任何英伟达新品放回矩阵:
- 看层级:它是单封装(B200)、卡(PCIe/SXM)、基板整机(HGX/DGX),还是机柜(NVLxx)?数字若是「几十颗 GPU 的整柜」,一定在第④层。
- 看字母定世代:A/H/B/R,B 之前是当代、R 多半还是路线图;名字含 G(如 GB200)通常是 Grace CPU + GPU 的组合。
- 看形态与后缀:SXM=高功耗全互联训练向;PCIe=通用/推理/存量机房;出现「A800/H800/H20」这类不在正代序列的,大概率是出口管制下的特供支线。
- 看它牵动哪条供应链:凡涉及 NVL 整柜/HBM3E,向上联动 HBM、CoWoS、光模块、液冷、供电;凡涉及特供卡,联动出口管制与国产替代。
按这四步,「GB300 NVL72 量产」= 第④层 Blackwell 升级版(利好 HBM/液冷,非新架构);「Rubin 路线图」= 下一代预告,不按现货解读;「特供卡更新合规参数」= 第六章支线,看互联是否再被削,而非单卡跑分。
九、哪些变量可能改写这套矩阵:带置信度的判断
产品矩阵不是静止的,下面五个变量决定它未来 2~5 年的形状,并标注置信度。
| 变量 | 作用方向 | 时间窗 | 置信度 |
|---|---|---|---|
| 整柜化继续推进 | NVL 之后的平台把更多芯片/网络封进更大单元 | 已发生并延续 | 高 |
| HBM / CoWoS 供给 | 直接决定新平台能交付多少、卖多贵 | 1~3 年紧平衡 | 高 |
| 出口管制口径 | 决定特供卡支线的存废与规格 | 持续不确定 | 中(政策变量) |
| 开放互联(UALink/超以太网)与 AMD/ASIC | 试图削弱 NVLink 整柜锁定 | 2~4 年见效 | 中 |
| 推理专用芯片/国产替代 | 在第①②层分流,短期难撼第④层整柜 | 3~5 年 | 中 |
带置信度的判断:
- 未来 1~2 年(高置信度):采购与竞争单位继续停在「机柜」层,NVL72 及升级款成为头部云厂商新集群事实标准;出货仍受 HBM3E/HBM4 与 CoWoS 约束,「能否拿到机柜」比「单卡贵不贵」更关键(产能见 HBM 与先进封装)。
- 未来 2~3 年(中高置信度):AMD 的 MI 系列、云厂商自研 ASIC(TPU/Trainium 类)在第①②层拿到更多份额,但「整柜 + 全互联 + 软件」的整体确定性仍难对等;开放互联开始进入部分新建集群。
- 未来 3~5 年(中置信度):推理负载占比上升,而推理对 NVLink 全互联的依赖低于训练,给 PCIe、推理 ASIC 和国产芯片更现实的分流空间;英伟达会以更强的推理整柜与软件生态回应。
- 长期 / 低置信度:整柜与网络层的封闭会否被「开放标准 + 多供应商」打破,取决于开放生态能否在大规模生产环境证明同等可靠性,以及客户对单一供应商锁定的容忍度,并与算力地缘长期走向绑定。
十、对不同角色,这意味着什么
- 采购/云基础设施:不能只比单卡价,要按「整柜可获得性、供电散热改造、网络与软件锁定、扩容路径」综合算账;特供卡还要计入政策不连续风险。
- 芯片/服务器从业者:价值正从「卡」向「柜」与「网络」迁移,机会在被整柜规格带旺的液冷、供电、高速连接、整柜集成。
- 国产替代:单卡对标只是入场券,硬仗在高速互联、整柜系统与软件生态;现实路径是先在推理与受限场景立足,再上攻训练集群。
- 投资者/观察者:盯三个领先指标——HBM/CoWoS 产能分配、整柜大客户订单、开放互联的量产进展,它们比单卡发布会更能说明利润走向。
结语:型号会变,结构不会
H100、B200、NVL72 这些名字明年后年还会换,但底层结构相当稳定:芯片 → 卡 → 基板整机 → 机柜的四级封装、一年一代的换机节奏、NVLink/CUDA 构成的系统与软件锁定、以及由管制倒逼出的特供支线。 记住结构,再看任何新品,你都能迅速回答三个问题——它处在哪一层、属于哪一代、牵动哪条供应链。读懂这张矩阵,也就读懂了 国产 AI 芯片与算力管制 的管制清单、HBM 与先进封装 的产能争夺,以及整条 AI 硬件链为何被一个又一个「整柜」推着往前走。
数据口径与延伸
- 数据口径:世代命名(Ampere/Hopper/Blackwell/Rubin)、SXM 与 PCIe 形态差异、HGX/DGX 定位、GB200 NVL72 的「72 GPU + 36 Grace CPU + NVLink + 液冷整柜」组合、特供卡(A800/H800/H20)「削互联、限训练」的产品逻辑,来自英伟达官方发布、财报说明会与主流行业研究的常见公开口径。本文刻意不堆逐卡 FLOPS/功耗等易变参数,统一采用层级、量级与区间表述;单柜「上百千瓦」「百万美元级」为量级描述,随配置与周期波动很大。数据截止 2026 年中:已上市世代为已公布值,Rubin 及之后为官方路线图,规格与命名以正式发布为准;管制与特供卡细节以官方规则原文为准。
- 相关产业观察:国产 AI 芯片与算力管制(管制与四道墙)、HBM 与先进封装(产能瓶颈)、从卖盒子到卖 Token(商业模式重构)、大模型的算力账单(折旧与推理成本)。
- 同批待写延伸:液冷与核电(能源层)、CoWoS 产能与 HBM4(封装层)、国产芯片盘点与 CUDA 护城河(竞争层)、万卡网络拓扑与 800G/1.6T 光模块(互联层)。
一句话总结:英伟达数据中心产品表面是一张让人眼花的型号表,本质是「芯片—卡—基板整机—机柜」四级封装、一年一代的架构节奏、NVLink/CUDA 的系统与软件锁定,再加一条由出口管制逼出的特供卡支线;竞争与采购的最小单位正从一张卡变成 GB200 NVL72 这样的整柜,单笔交易、供电液冷配套和客户锁定随之跃级——读懂这套结构,才能真正看懂管制清单卡在哪、HBM/CoWoS 在为什么排队,以及整条 AI 硬件链的利润如何被「整柜化」重新分配。