从卖盒子到卖 Token:云厂商和芯片商的商业模式正在被重写
最后更新:2026-09-16
本文是产业观察的一篇,承接《大模型的算力账单》——既然算力已经能被换算成"每 token 多少钱",那么把它直接当商品卖就顺理成章。本文讲的不是技术怎么做,而是计价单位的迁移如何重写整条产业链的收入结构、风险归属和谈判地位:从"把一台服务器/一块加速卡卖给你(卖盒子,CapEx)",到"你用多少 token、调多少次、占多少秒 GPU,我收多少钱(卖效用,OpEx)"。云原生的底层逻辑见云原生目录,算力成本账见算力账单,国产算力供给见国产 AI 芯片。
先说结论
- 计价单位从"资产"变成"效用",本质是把算力做成了电。 企业不必再为一个不确定的需求预先购买、折旧、运维昂贵的 GPU 集群(重资本开支 CapEx、利用率自担),而是按 token、按请求、按占用秒数付费(运营开支 OpEx,随用随付)。这和云计算对传统 IDC、电力对自建发电机的替代是同一类历史。
- 价值被切成三层,每层的钱和风险都不同。 ①造芯片/盒子(一次性收入,被英伟达等拿走,毛利高但客户集中);②建云、管集群(赚规模与利用率差价,重资产、强运维,由云厂商承担利用率风险);③卖模型/API/Agent(按 token 收租,粘性强但要在模型降价战里持续投入)。越往上离客户和数据越近,越往下越吃资本和工程壁垒。
- 英伟达的特殊之处:它既卖盒子,又对整个"算力税基"抽成。 CUDA 软件生态让卖出去的每张卡都在加固护城河;当算力服务化,英伟达既是云厂商最大的供应商,又通过整机/网络/软件甚至自有云直接卡位(参见英伟达护城河与 CUDA)。云厂商则用"自研芯片 + 多云"来对抗这种议价权。
- "买还是租"没有永恒答案,取决于利用率和锁定风险。 稳定、高利用率、有长期规划的负载,自建/包年实例摊下来更便宜;波动大、要快速试错、团队没有集群运维能力的,按 token/Serverless GPU 租更划算。真正的陷阱是:为图省事全押单一 API,既付出长期溢价,又把数据和切换权交了出去。
一句话:从卖盒子到卖 Token,是把算力从"需要采购和折旧的固定资产"变成"拧开就有、按用量计费的效用";它降低了用 AI 的门槛、把利用率风险从客户转移给云厂商,也让"谁掌握算力税基、谁掌握模型入口、谁掌握客户数据"成为三场同时进行的商业战争。
一、三种卖法:盒子、算力、Token
同样支撑一个 AI 应用,采购方式可以落在三个抽象层级,越往上越"省心"、单位越贴近业务,但锁定与单位溢价通常越高:
| 层级 | 你买什么 | 计费 | 谁承担利用率风险 | 典型形态 |
|---|---|---|---|---|
| 卖盒子 | GPU 服务器/加速卡 | 一次性采购 + 折旧 | 买方 | 自建机房、买断硬件 |
| 卖算力(IaaS) | GPU 实例/裸金属 | 按小时/包年 | 部分转移给云厂商 | GPU 云、 reserved/spot 实例 |
| 卖 Token(MaaS) | 模型推理结果 | 按 token/请求/秒 | 主要在供给方 | 大模型 API、推理云、Serverless GPU |
| 卖结果(更上层) | Agent/能力/工作流 | 按任务/坐席/结果 | 供给方 | 端到端 AI 产品 |
底层逻辑是风险与控制权的交换:
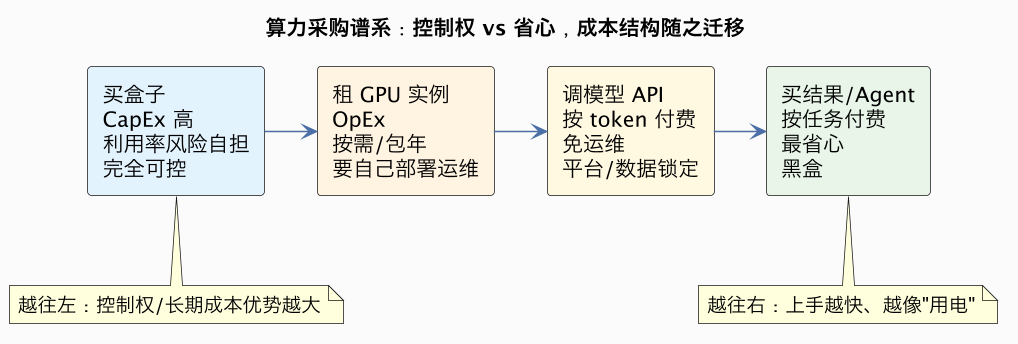
这与云原生把服务器、存储、数据库一步步"效用化"的历史完全一致,只是这次被效用化的是最贵、最热、迭代最快、供给最紧的资源——GPU 算力(云原生目录见/cloud/)。
二、为什么供给方愿意"卖 token":利用率是真正的生意
云厂商和模型公司不是做慈善。把算力按 token 卖能成立,靠的是在波动需求上把利用率做高、用规模摊薄成本——这正是算力账单里 MFU/批处理逻辑的商业化:
- 削峰填谷:单个客户的请求有明显波峰波谷,但把成千上万客户的负载聚合到一个大池子里,波峰互相抵消,集群平均利用率可以远高于任何单租户自建集群。
- 批处理与超额订阅:continuous batching、优先级调度、spot/可抢占实例让同一张卡服务更多请求;夜间训练、白天推理,混部进一步填满。
- 硬件代际套利:大平台第一批拿到新一代芯片、大规模采购折扣高、折旧周期管理精细,单位成本天然低于零散买家。
- 软件溢价:托管推理(自动扩缩容、KV 缓存、网关、可观测、安全合规)让客户愿意为"省一个 SRE/算法平台团队"付溢价。
所以这门生意的本质是:供给方用规模和工程能力,把自己每 token 的成本压到低于向客户收取的价格,赚"利用率差 + 软件溢价"。 反过来说,一旦需求增长放缓、芯片供给宽松、价格战加剧,承担巨额折旧的也是这些平台——卖 token 把风险从客户转移给了供给方,并不是消除了风险。
三、三层价值的博弈:芯片厂、云厂商、模型商
3.1 造盒子的人:一次性收入 + 生态税基
英伟达这类公司的收入大头仍是卖芯片/整机/网络(一次性、单价高、毛利高、客户集中在少数云和大模型公司)。但它真正的护城河是 CUDA 生态(见国产 AI 芯片的软件生态难题):每卖一张卡,都在加深软件锁定,等于扩大了长期"税基"。当算力服务化,它还推出整机柜、网络、参考设计乃至云上实例,沿价值链向上下游延伸。
3.2 建云的人:当房东,同时想摆脱房客式依赖
云厂商(及新兴 GPU 云)的位置很微妙:
- 一方面它们是英伟达最大的买家、赚算力零售差价和托管软件溢价;
- 另一方面,GPU 成本在 AI 服务器里占比极高,议价权在上游手里,云厂商利润被挤压,于是纷纷自研芯片/ASIC(为自家负载定制,牺牲通用性换成本与能效),并用"多供应商 + 自研"对冲;
- 它们还掌握客户关系、数据中心、电力和网络,是 token 经济里离企业钱包最近的"房东"。
3.3 卖 token 的人:高粘性,但在降价战里狂奔
模型/API 厂商按 token 收费,收入随调用量持续发生(比卖软件 license 更细水长流),粘性来自数据、微调、工作流和迁移成本。但基础模型 API 高度同质化、价格以季度为单位下降,公司必须不断证明"我的模型/上下文/Agent/企业合规值得溢价",否则就退化成纯拼价格的管道。单位价格在跌、总用量在涨,谁的量涨得更快谁活下来——又是算力账单里的杰文斯悖论。
四、企业怎么选:自建、租卡还是调 API
这是一线技术决策者真正要回答的问题。没有统一答案,但有清晰的判据:
| 决策因子 | 倾向自建/包年 | 倾向按 token/API |
|---|---|---|
| 负载利用率 | 高且稳定(常年 >50%~60%) | 波动大、不确定、早期试点 |
| 时间窗口 | 有长期规划、能等采购周期 | 要立刻上线、快速试错 |
| 团队能力 | 有集群/推理优化/SRE 能力 | 不想养基础设施团队 |
| 数据敏感度 | 强监管、数据不能出域 | 可脱敏、可接受云端 |
| 单位成本敏感度 | 用量巨大,省差价可观 | 用量尚小,差价不抵人力 |
| 定制需求 | 要自研模型/特殊算子/私有化 | 通用能力即可满足 |
实务上多数中大型组织是混合架构:核心、稳定、敏感的负载走自建或专属实例(VPC/裸金属);波峰、新业务、长尾能力走 API 或 Serverless GPU。关键的工程动作是做一层可切换的抽象(统一网关、模型路由、prompt/评测可移植),避免把业务逻辑焊死在单一供应商的私有接口上——这和多云、数据库可移植性是同一类架构纪律。
五、对工程师的启示
- 把"成本建模"当成核心技能:能把一个功能拆成 token 数、调用次数、并发、GPU 秒,进而比较自建/租卡/API 的盈亏平衡点(方法见算力账单)。
- FinOps for AI:像监控云账单一样监控每个功能、每个模型、每个租户的 token 与 GPU 消耗,设预算、告警和配额;AI 时代的成本可观测性与传统云成本治理同源(SRE/容量视角见/sre/)。
- 防锁定的架构能力:模型网关、抽象层、可移植评测、多供应商路由,会从"可选优化"变成"标配"。
- 理解硬件—云—模型的联动:选型时同时看芯片供给、实例价格、API 降价节奏和数据合规,而不是只比模型榜单。
相关与延伸
- 每 token 成本怎么算:大模型的算力账单
- 上游芯片与生态锁定:国产 AI 芯片与算力管制
- HBM/封装对算力供给的约束:HBM 与先进封装
- 云原生与效用化:云原生目录
- AI 应用怎么构建:数据与 AI
一句话总结:从卖盒子到卖 Token,是把 GPU 算力从"自购折旧的固定资产"变成"按用量计费的公用事业";它把利用率风险转移给云与模型厂商、降低了用 AI 的门槛,也让芯片厂(税基与生态)、云厂商(规模与客户)、模型商(粘性与降价战)围绕价值分配展开博弈——工程师的新基本功,是会算这笔账、会做成本治理,并给供应商锁定留出可切换的架构后路。