LLM 推理成本趋势:token 价格为何快速下降、能否持续
最后更新:2026-10-03
本文是产业观察的一篇。上一篇大模型算力账单讲的是训练侧的巨额投入,而训练贵只是一次性的故事——模型训练完就躺在那里,真正每天烧钱、也真正决定 AI 能不能普及的,是推理(inference)的单位成本:用户每问一句话、Agent 每跑一步,都要重新过一遍几十上百亿参数的矩阵乘法。本文衔接从卖盒子到卖 token里"算力商品化"的视角,回答一个更具体的问题:LLM 推理成本趋势到底降了多少、靠什么降的、还能不能继续降。
本文要回答的问题
- 过去三年 token 价格到底降了多少?有没有可靠的数字坐标?
- 价格下降是哪些技术在推动?每一项贡献了什么?
- DeepSeek 为什么能把行业价格一下打穿一个数量级?
- 推理成本的下限在哪里?内存带宽、能耗、资本折旧各自扮演什么角色?
- 成本一降再降,为什么总算力消耗反而暴涨?这对应用层意味着什么?
一、先看数字:token 价格的下降曲线有多陡
先把坐标系立起来。2023 年 3 月 GPT-4 刚发布时,API 定价是输入 30 美元、输出 60 美元每百万 token——写一篇三千字的中文报告,光模型调用就要花掉几块人民币,按这个成本,"让 AI 帮人写所有代码"是纯粹的经济学笑话。
三年之后,同样的钱能买到的 token 数量翻了一到两个数量级:
| 时间点 | 代表模型与价格(美元/百万 token,输出) | 相当于 GPT-4 发布价的比例 |
|---|---|---|
| 2023-03 | GPT-4:60 | 100% |
| 2024-05 | GPT-4o:15 | 25% |
| 2024-08 | GPT-4o mini:0.60 | 1% |
| 2025-01 | DeepSeek-R1:2.19(错峰更低) | 约 4% |
| 2025 下半年 | 各家旗舰推理模型:2-10 | 3%-15% |
| 2026 | 开源小模型自部署:等效 0.1-0.5 | <1% |
这张表要注意两点。第一,这不是"同一模型降价",而是智能水平不降反升前提下的价格坍塌——2024 年的 GPT-4o 比初版 GPT-4 更强却便宜 75%,这在芯片史上相当于"每一代 CPU 性能翻倍同时价格砍半"连续发生好几轮。第二,不同档位的差距拉得极大:前沿旗舰(GPT-5 系、Claude Opus 级、Gemini Ultra 级)依然维持在每百万 token 几到几十美元,而开源的 7B-70B 级别模型自托管,等效成本已经逼近每百万 token 几毛人民币。市场从"一个价格"分裂成"前沿溢价 + 大宗商品"两层,这是理解后面所有推理经济学的前提。
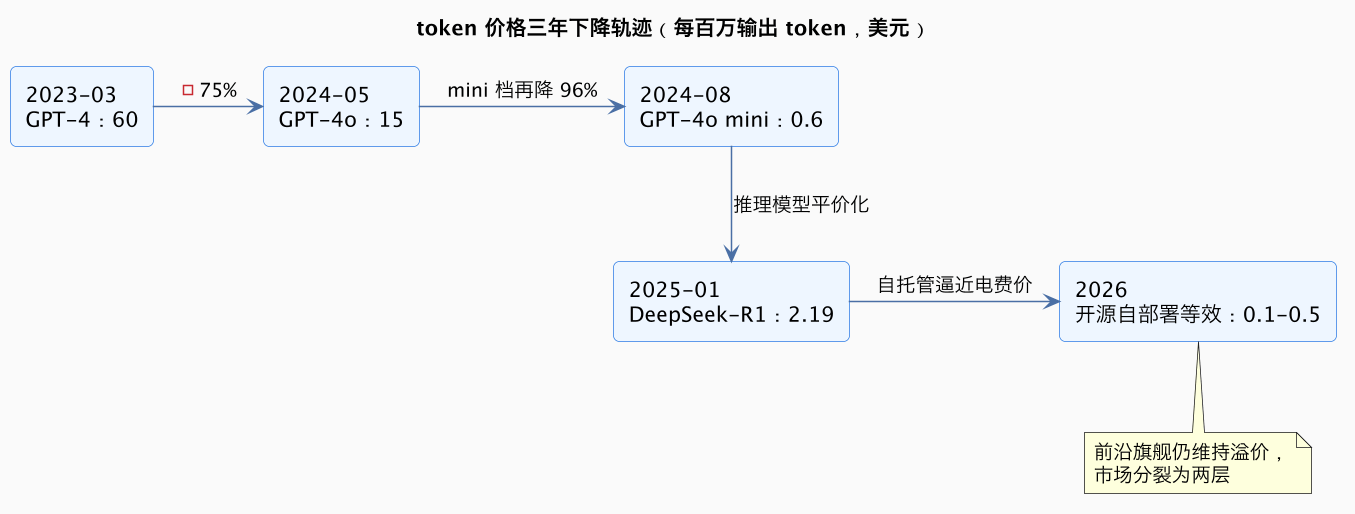
上图把下降轨迹画成一条阶梯:每一级台阶背后都不是"厂商良心发现",而是一组具体技术把成本曲线往下压。下面就拆这些技术。
二、推理为什么这么贵:先搞清钱花在哪儿
拆优化技术之前,必须先建立正确的成本模型,否则后面每一项技术对不上账。LLM 推理的每一轮生成分两个阶段:
- 预填充(prefill):把用户的 prompt 一次性并行算完,生成第一个 token。这个阶段是**算力受限(compute-bound)**的——矩阵乘法拉满,GPU 的 TFLOPS 决定快慢。
- 解码(decode):之后逐个 token 生成,每生成一个都要把整个模型的权重从显存里读一遍。这个阶段是**内存带宽受限(memory-bandwidth-bound)**的——一个 70B 参数、FP16 的模型,权重 140GB,H100 的 HBM 带宽约 3.35TB/s,理论上限也就是单卡每秒二十几个 token。
这个"两个阶段、两种瓶颈"的结构是理解推理经济学的钥匙:decode 阶段 GPU 的算力大部分时间在空转等显存,单看 FLOPS 利用率可能只有个位数百分比。 所以推理优化的主战场不是"更快的芯片",而是"怎么让昂贵的显存带宽和算力别闲着"。
| 成本项 | 占比量级 | 由什么决定 |
|---|---|---|
| GPU 资本折旧 | 40%-60% | 卡价、利用率、折旧年限(3-5 年) |
| 电力与机房 | 15%-25% | 整卡功耗、PUE、当地电价 |
| 显存带宽与容量 | 体现在吞吐上限 | HBM 代际(HBM3→HBM3e→HBM4) |
| 网络与调度开销 | 5%-15% | 多卡并行、空闲率、请求波动 |
注意第一行:推理成本的大头是折旧,折旧的大敌是闲置。 一张 H100 采购价摊到三年、每小时成本约 1-2 美元,它空转一小时就是纯亏一小时。这解释了后面 continuous batching 为什么是所有优化里杠杆最大的一项——它直接攻击"利用率"这个分母。
三、五板斧:每一项优化分别砍掉了什么
这一节是全文的技术主干。推理成本三年降一两个数量级,不是一个银弹,而是五类优化层层相乘的结果。先看全景图,再逐项展开。
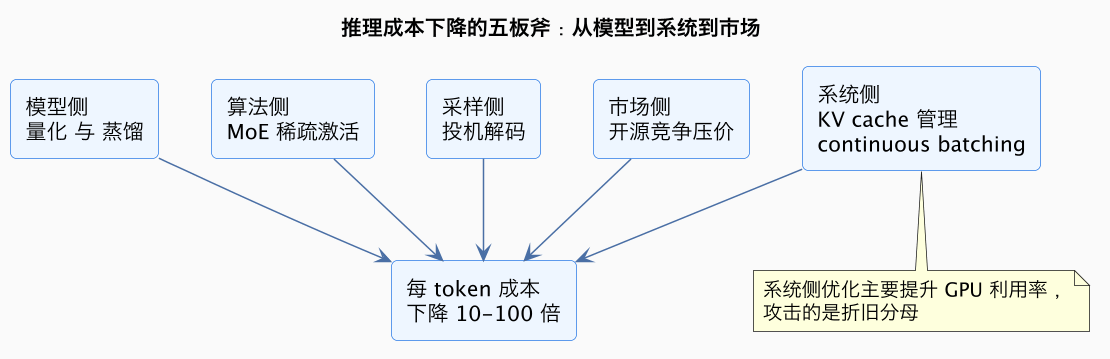
第一板斧:量化。 把权重从 FP16 压到 INT8、INT4 甚至更低。收益是双重的:显存占用减半再减半(70B 模型从 140GB 压到 INT4 的约 35GB,单卡可放),同时 decode 阶段要搬的数据量同比缩小,带宽瓶颈直接缓解。GPTQ、AWQ 这类后训练量化把精度损失控制在 1% 以内,使 INT4 成为 2025 年后开源部署的事实标准。
第二板斧:蒸馏与小模型。 用大模型当老师,把能力蒸到 7B-30B 的小模型里。Qwen、Llama、DeepSeek 的蒸馏小模型在很多业务场景达到旗舰 80%-95% 的效果,而参数量小一个数量级意味着显存、带宽、能耗全部同比缩小。应用层慢慢学会一个朴素道理:不是所有请求都值得用旗舰模型。
第三板斧:MoE(混合专家)。 DeepSeek-V3 总参数 671B,但每个 token 只激活约 37B——用"很多专家、每次只叫醒几个"的稀疏结构,把"模型容量"和"每 token 计算量"解耦。这是模型架构层面最狠的一次成本攻击:智能水平对标稠密大模型,推理 FLOPs 却只有零头。
第四板斧:投机解码(speculative decoding)。 用一个小草稿模型先猜几个 token,大模型一次性并行验证,猜对就白赚。decode 阶段本来是串行逐字蹦,投机解码把"验证"变成并行批操作,实测端到端提速 1.5-2.5 倍,等于同样的硬件多吐一倍的 token。
第五板斧:KV cache 管理与 continuous batching。 这是最偏系统、也最容易被低估的一项。Transformer 每生成一个 token 都要引用历史所有 token 的注意力中间结果(KV cache),长上下文下 KV cache 能吃掉几十 GB 显存。vLLM 的 PagedAttention 借鉴操作系统虚拟内存分页的思想管理 KV cache,把显存碎片浪费从 60% 以上压到个位数;continuous batching 则不等一整批请求全部做完,而是每个 token 步就把完成的请求换出、新请求换入,让 GPU 始终保持满批运转。两项合计把吞吐拉高数倍——前面说过,推理大头是折旧,吞吐翻倍等于单位成本直接砍半。
| 优化技术 | 作用层 | 主要攻击的瓶颈 | 典型收益 | 代价 |
|---|---|---|---|---|
| 量化(INT4/INT8) | 模型权重 | 显存容量与带宽 | 2-4 倍 | 精度小幅损失 |
| 蒸馏小模型 | 模型结构 | 全部成本项 | 5-10 倍 | 能力上限下降 |
| MoE 稀疏激活 | 模型架构 | 每 token FLOPs | 3-8 倍 | 显存仍要装全量专家 |
| 投机解码 | 采样算法 | decode 串行瓶颈 | 1.5-2.5 倍 | 多跑一个草稿模型 |
| KV cache 分页 与 连续批处理 | 推理系统 | GPU 利用率 | 2-5 倍吞吐 | 系统复杂度上升 |
五板斧相乘,再叠上 HBM3e/HBM4 显存带宽代际提升和专用推理芯片(Groq 的 LPU、各家 NPU)对能效的改善,一两个数量级的成本下降就完全对得上账了。没有任何一项是噱头,每一项都对应成本模型里一个具体的分母。
四、DeepSeek 冲击与 API 价格战:技术降本如何变成价格降本
2025 年 1 月 DeepSeek-R1 发布,是推理成本史上的分水岭事件。它做的事拆开看并不神秘:MoE 架构摊薄每 token 计算量、MLA(多头潜在注意力)把 KV cache 压缩数倍、用纯强化学习练出推理能力从而绕开昂贵的监督数据、再加上极致的工程优化。但组合起来的结果是——对标当时最强推理模型的能力,API 定价却只有对方的零头(输出每百万 token 约 2 美元出头),并且模型权重直接开源。
这一下打穿了行业的心理价位。在此之前,"前沿智能"被默认为稀缺资源,值得溢价;DeepSeek 证明了同等智能可以用低一个数量级的成本复现,于是所有厂商被迫跟进:OpenAI 推出更便宜的推理模型档位,Google 把 Gemini Flash 系列打到白菜价,国内厂商更是直接掀起每百万 token"几毛钱"的价格战。
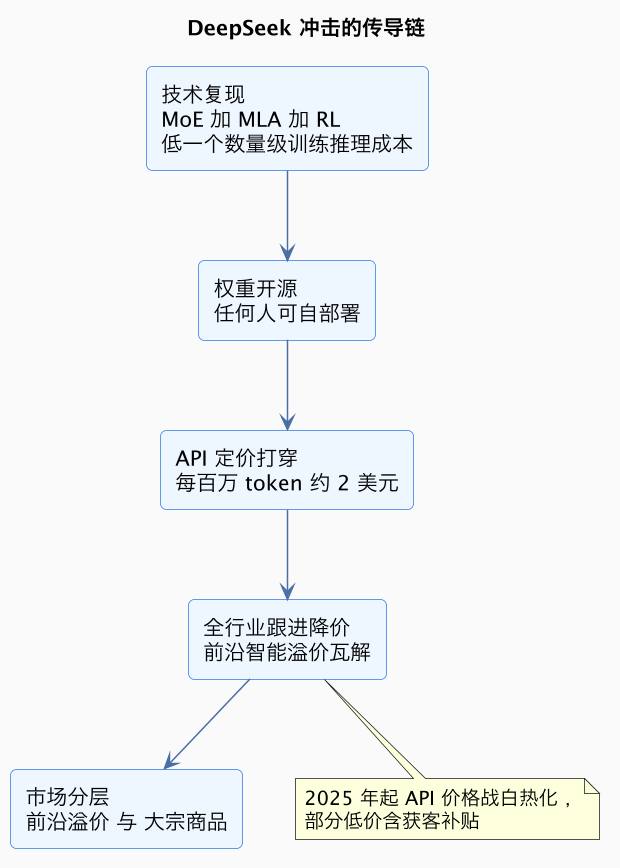
但这里必须泼一盆冷水,这也是老骨架里"常见坑"之一:把补贴价当成长期均衡价。 2025-2026 年的部分超低价 API 里含着厂商的获客补贴和战略亏损,毛利未必为正。判断一个价格是否可持续,看三个指标:一是同等能力是否已开源(开源价是成本的真实下界),二是厂商云业务整体毛利走势,三是价格是否还在随硬件代际继续下移。技术降本是真的,但价格表的数字不全是技术给的。
五、成本的下限与杰文斯悖论:为什么越降越不够用
推理成本会一直降下去吗?物理上不会。下限由三道墙构成:HBM 显存带宽(decode 阶段的硬约束,带宽代际提升只有每年 30%-50%)、能耗与散热(单柜功率冲向 100kW 以上,电力本身成为稀缺资源,见电力成为算力约束)、资本折旧(芯片再快也要摊销采购价)。这意味着成本曲线是"快速下降后渐趋平缓"的 L 形,而不是无限归零。
更有趣的是另一个方向的问题:成本降了,总支出降了吗?没有,反而暴涨。这就是经济学里的杰文斯悖论(Jevons Paradox)——十九世纪蒸汽机效率提升、每吨煤能干更多活之后,英国的煤炭总消耗量不降反升,因为便宜的动力打开了无数过去用不起的场景。推理 token 正在精确重演这段历史:
- 每 token 便宜 90%,于是应用从"人问一句答一句"变成 Agent 一个任务自动跑几百上千轮调用,单用户 token 消耗涨了不止十倍;
- 推理模型(reasoning model)刻意用"思考 token"换准确率,一个回答背后烧掉几千个不可见的思维链 token,智能本身被重新定义成一种可以花钱买的量;
- 成本越过阈值后,过去完全不成立的场景被解锁:全量代码审查、客服全量覆盖、文档逐页理解、端侧常驻助手。
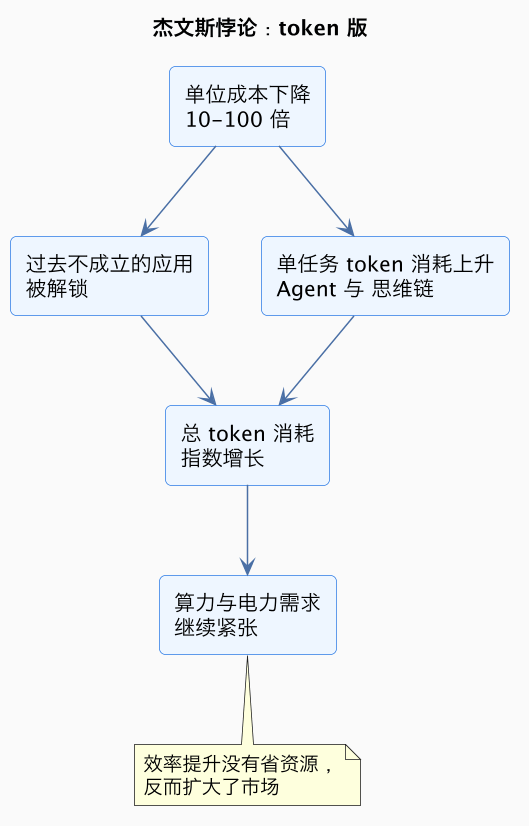
上图的闭环解释了 2025-2026 年看似矛盾的现象:token 价格屡创新低的同時,全球 AI 数据中心建设反而在加速、电力缺口成为头条新闻。推理成本下降不是算力需求的减压阀,而是放大器。 对从业者来说,这也意味着"等成本再降降再做"的策略基本无效——成本下降的红利会被消耗量的暴涨吃干抹净,真正的竞争力在于用同样的 token 预算做出别人做不出的产品。
再给一组量化的感觉。2023 年一个日均一万次调用的客服机器人,每次对话按两千 token 输出估算,用初版 GPT-4 的价格每月账单超过三万美元,多数公司算完账就放弃了;到 2026 年,同样的负载路由到开源中档模型自托管,月成本可以压到几百美元量级——成本下降两个数量级之后,讨论的问题从"用不用得起"变成了"为什么不用"。这正是一轮技术扩散的典型节奏:价格每越过一个心理阈值,就有一整批此前被经济学否决的场景集中爆发,而爆发的需求又反过来支撑更大规模的算力投资,推动下一轮成本下降。理解这个正反馈,就不会再用静态眼光问"成本降到多少才算够",因为答案是动态的——永远有下一批场景在阈值下面等着。
对应用层的具体启示可以归纳成三条。第一,模型路由成为标配:按请求难度分流到旗舰模型、中档模型、本地小模型,成本可以差出两个数量级而体验损失很小。第二,成本会计前置到设计阶段:Agent 产品的成败越来越取决于"每个任务烧多少 token"这个数字,而不是模型多聪明。第三,自部署的门槛持续下降:INT4 量化的开源模型跑在消费级或入门级数据中心卡上,等效成本已低于多数 API 定价,数据敏感型场景的经济账彻底翻转。
这一篇在知识体系里的位置
本文是产业观察线上"算力经济学"三部曲的中间一环:上游是大模型算力账单(训练侧的一次性投入如何决定模型格局),商业模式侧的展开在从卖盒子到卖 token(算力如何从卖设备演变成卖 token 的商品生意)。成本下降对基础设施的反噬——数据中心建设与电力瓶颈——在电力成为算力约束中展开;想理解提供这些推理算力的硬件霸主,可读英伟达的崛起。技术侧的量化、KV cache 等主题,在 concepts/ 与 tools/ 目录下有对应的底层原理与观测工具文章可对照深入。
总结
LLM 推理成本趋势的本质是:量化、MoE、投机解码、KV cache 与连续批处理五板斧层层相乘,叠加开源竞争引爆的价格战,把每 token 价格在三年内打低了一到两个数量级;但 HBM 带宽、能耗与资本折旧构成物理下限,杰文斯悖论又让成本下降反而放大总消耗——推理会越来越便宜,而算力永远不够用,赢的人是把每个 token 花得比别人值的人。