数据中心的能耗墙:电力正在成为算力的硬约束
最后更新:2026-09-16
本文是产业观察,不带系列编号。AI 军备竞赛里,人们先关注 GPU、HBM 和先进封装(见国产 AI 芯片与算力管制、HBM 与先进封装),但越往后越发现还有一堵更"物理"的墙:电。每一次矩阵乘法最终都要换算成焦耳和热量,而一座大型 AI 数据中心的耗电量已相当于一座中小城市。本文回答:电力为什么取代芯片供给成为新瓶颈、功率密度和散热发生了什么变化、PUE 是什么、行业如何应对,以及一线工程师在能效与容量上能做什么。成本账见大模型的算力账单,算力服务化见从卖盒子到卖 Token。文中功率与用电量为公开报道与行业常见量级,地区与项目差异很大,只取数量级与方向。
先说结论
- 算力的尽头是电力。 一张高端 AI 加速卡的功耗从数百瓦走向千瓦级,一个满载机柜的功率密度从传统 IT 的几 kW 跳到几十甚至上百 kW;一个万卡集群动辄数十 MW,超大规模园区向数百 MW、GW 级演进,相当于一座工业城镇的用电量。芯片可以下订单,电却不能凭空变出来。
- 真正的瓶颈是"供电的时间"和"散热的密度"。 数据中心用电要经过发电、高压输电、变电站、园区配电层层落地,从签约选址到可靠通电常需数年(变压器、开关设备本身也短缺)。同时高密度机柜的热量已逼近风冷极限,液冷(冷板式/浸没式)从可选项变成必选项。有电、能送来、能散掉热,三者同时满足才能上线。
- PUE 衡量"非计算开销",但 AI 负载让旧优化逻辑改变。 PUE = 数据中心总能耗 / IT 设备能耗,越接近 1 越好;制冷和配电是主要损耗。传统云靠规模化、热通道封闭、自然冷源把 PUE 压到 1.1~1.3,但 AI 的超高热密度让风冷难以为继,液冷和余热回收成为新焦点。
- 能效直接进成本,也进了模型架构决策。 电费是推理长期成本的大头(见算力账单),每 token 的焦耳数与每 MFU 的有效产出一样重要;模型压缩、量化、专用芯片、把任务调度到低碳/低价电力区,都是在跟物理账单较劲。
- 杰文斯悖论在重演:芯片越省电,总用电反而越多。 单位算力能效持续提升,但 AI 需求增长更快、价格下降刺激用量爆炸,数据中心总用电量仍快速攀升。能源(核电回归、可再生能源 PPA、燃气调峰)与电网容量因此成为 AI 产业的战略议题和选址决定因素。
一句话:当算力需求被 AI 拉成垂直曲线,最先撞上的不是更先进的晶体管,而是发电容量、输变电的多年周期和把成吨热量移走的物理极限;电力和散热正从"机房后勤"变成决定 AI 项目能否按期上线、单位成本能否打平的一级约束,能效工程也随之成为和算法同样重要的竞争力。
一、量级:一座 AI 数据中心到底用多少电
先建立数量级直觉(均为量级估算):
| 对象 | 功率/耗电(量级) |
|---|---|
| 一张高端 AI 加速卡 | 数百 W ~ 1000W+(且代际继续上升) |
| 一台 8 卡 AI 服务器 | 10 kW 级(含 CPU/内存/网络/电源损耗) |
| 一个满载 AI 机柜 | 30~100+ kW(传统 IT 机柜常仅 3~8 kW) |
| 一个万卡集群 | 数十 MW |
| 超大规模 AI 园区 | 数百 MW,规划向 GW(1000 MW)级演进 |
作为参照,数十 MW 到数百 MW 的持续负荷,已是一座工业城镇乃至小城市的用电规模;而 GW 级园区意味着要配套专门的输电线路和变电站。问题不只是"电费贵",更是物理供给:
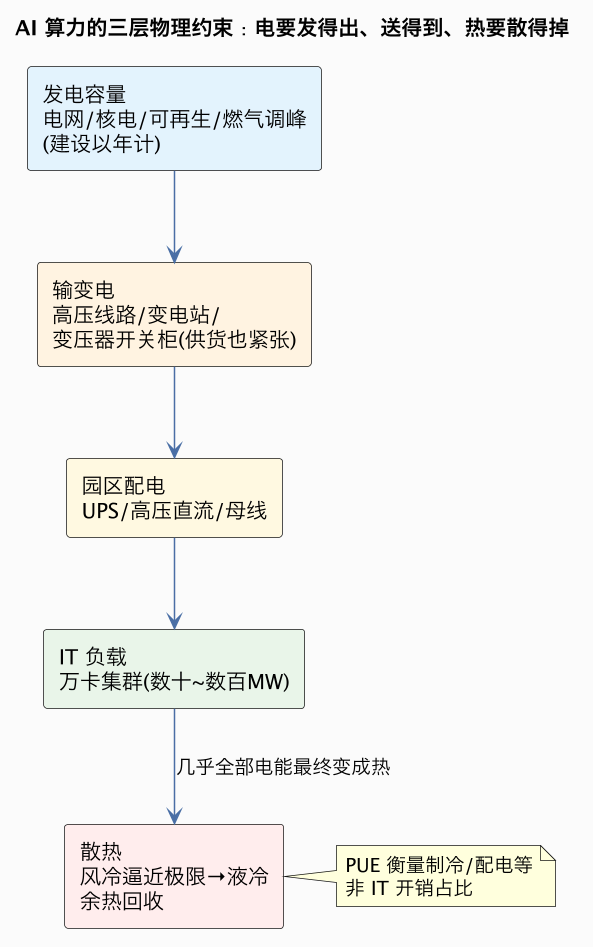
三个常被低估的事实:
- 供电有"时间墙":新增发电、输电和变电容量是多年工程,且变压器、中压开关设备全球供应紧张。很多 AI 项目的真实排期不是等芯片,而是等电。
- 热几乎等于电:进入数据中心的电能最终几乎全部转化为热,必须实时移走,散热能力直接限制可部署的芯片数量。
- 选址逻辑改变:数据中心开始围绕"便宜且充足的电、冷凉气候或水源、宽松的电网接入"布局,甚至绑定独立电源。
二、PUE 与功率密度:为什么风冷不够用了
PUE(Power Usage Effectiveness) = 数据中心总能耗 ÷ IT 设备能耗。PUE 1.2 意味着 IT 每用 1 度电,制冷配电等额外消耗 0.2 度。行业通过这些手段压低 PUE:热通道/冷通道封闭、变频精密空调、自然冷却(free cooling)、提高回风温度、高效 UPS 与高压直流、智能化群控。
但 AI 带来了质变——功率密度:
| 维度 | 传统云/通用 IT | AI 训练集群 |
|---|---|---|
| 单机柜功率 | 约 3~8 kW | 约 30~100+ kW |
| 主流散热 | 风冷足够 | 风冷逼近极限,转向液冷 |
| 热点 | 相对均匀 | GPU/显存处局部热流密度极高 |
三、能效正在进入模型与架构决策
电力不只是 CFO 和选址团队的事,它正沿栈向上影响技术决策——因为电费在算力账单里占比越来越大:
- 每 token 的焦耳数成为指标:和延迟、准确率并列。量化(FP8/INT8/INT4)、稀疏化、MoE(只激活部分专家)、KV Cache 管理、更好的批处理,既降算力也降电。
- 专用芯片的能效优势:在固定推理负载上,ASIC/专用加速器的每瓦性能往往优于通用 GPU,推动云厂商自研芯片(见从卖盒子到卖 Token 里的自研逻辑)。
- 时空维度的调度:把可延迟的训练/批处理任务调度到电价低、碳强度低的时段或地区("跟着风电跑"),利用电力市场的价差和绿电波动。
- 利用率即节能:MFU 低不仅浪费钱也浪费电——把 GPU 利用率从 30% 提到 50%,等于用同样的电做更多有用功,空转的高功率集群是最大的浪费。
也就是说,AI Infra 工程师的优化目标正在从"跑得快"扩展为"在给定功率/热量预算下产出最多有效算力",性能/瓦(performance per watt)成为一类一等公民指标。
四、能源侧的回应与约束
- 核电重新被认真讨论:多个大型科技公司投资或洽谈小型模块化反应堆(SMR)、长协购买核电,看中其稳定、低碳、可支撑超大基荷负荷;但核电站建设周期长,短期难解近渴。
- 可再生能源 + 长协(PPA):风光电力 + 储能 + 跨区电网是绿色数据中心主线,问题是间歇性,需要调峰电源(燃气、储能)配合。
- 电网与监管约束:很多地区电网接入排队、用电指标、碳考核成为硬门槛;"能不能拿到电"甚至先于"能不能买到地"。
- 杰文斯悖论:单芯片能效每年都在提升,但总用电仍快速上升,因为成本下降刺激出更大用量(多模态、Agent、更长上下文)。能效改善没有换来用电下降,反而扩大了算力的应用边界。
需要把事实与判断分开:AI 数据中心用电快速增长是事实,具体到某年占全社会用电比例的预测差异很大(取决于能效改进速度、采用率、电网结构),不宜用单一吓人数字下结论;但"电力从后勤变成一级约束"这一方向性判断在 2025–2026 年已被大量投资和选址行为验证。
五、对工程师的启示
- 建立能效直觉:像看延迟、QPS 一样看功耗、每瓦性能、PUE;在方案评审里加入能耗与热设计约束。
- 推理优化更值钱:量化、投机解码、连续批处理、KV 管理、专用芯片适配,直接降低电与热——这是把算力账单和能耗墙同时缓解的杠杆。
- 容量规划纳入电力维度:SRE/平台团队做容量模型时,要把机柜功率密度、供电上限、散热能力、电价和碳强度作为约束(与 SRE 容量规划、平台工程的资源治理同源)。
- 液冷与数据中心工程是新机会:高密度散热、配电、监控、余热利用等"物理 AI Infra"岗位需求上升,是软件工程师向软硬协同延伸的方向。
- 绿色与成本常常一致:优化利用率、减少空转、用绿电调度,既降碳也降钱,可持续性正成为技术竞争力而非合规口号。
相关与延伸
- 电费如何进入每 token 成本:大模型的算力账单
- 芯片—云—模型的价值分配:从卖盒子到卖 Token
- 封装/HBM 对功耗密度的放大:HBM 与先进封装
- 容量与资源治理的组织侧:平台工程、SRE 目录
- 国产算力与供给约束:国产 AI 芯片与算力管制
一句话总结:AI 把算力需求拉成垂直曲线后,最先撞上的墙是电力与散热——单卡千瓦、机柜上百 kW、园区百 MW 级的负荷,让"发电容量 + 输变电的多年周期 + 液冷散热"从机房后勤变成决定项目能否上线、单位成本能否打平的一级约束;PUE、每瓦性能和每 token 焦耳数随之成为技术指标,核电与绿电成为战略变量,而杰文斯悖论提醒我们:芯片更省电不等于世界更省电,能效工程正在成为和算法同样重要的竞争力。
| 供电 | 常规配电 | 高密母线、近端供电、冗余升级 |
液冷因此成为关键技术,主要两条路线:
- 冷板式液冷(direct-to-chip):液冷冷板贴在 GPU/CPU 上,液体带走主要热量,风扇仍辅助其余部件;改造成本相对可控,是当前主流过渡形态。
- 浸没式液冷:整机服务器浸在绝缘冷却液中,散热能力最强、可极致降噪节能,但对机柜、运维、液体管理改变较大。
液冷不仅解决散热,还能通过提高进水温度、余热回收(给办公楼、区域供暖、工业用热供热)进一步改善综合能效。