大模型的算力账单:一次训练和每一次推理,到底在烧多少钱
最后更新:2026-09-16
本文是产业观察的一篇。"训练一个大模型要上亿美元""聊一次天要烧掉几美分"这类说法广为流传,却很少有人把账算清楚。本文不做财经评论,而是沿用工程师能核对的口径,把参数量、token 数、FLOPs、GPU 有效利用率、功耗、PUE、折旧一项项换算成钱,并区分两本性质完全不同的账:训练是一次性的巨额资本开支,推理是随调用量增长、可能更大的持续运营成本。这正是国产 AI 芯片两本账、HBM 与先进封装瓶颈在商业层面的落点。所有金额均为量级估算:GPU 单价、电价、模型规模、利用率差异巨大,本文给的是可套用的计算框架和数量级,不是精确报价(截至 2026 年初的常见公开口径)。
先说结论
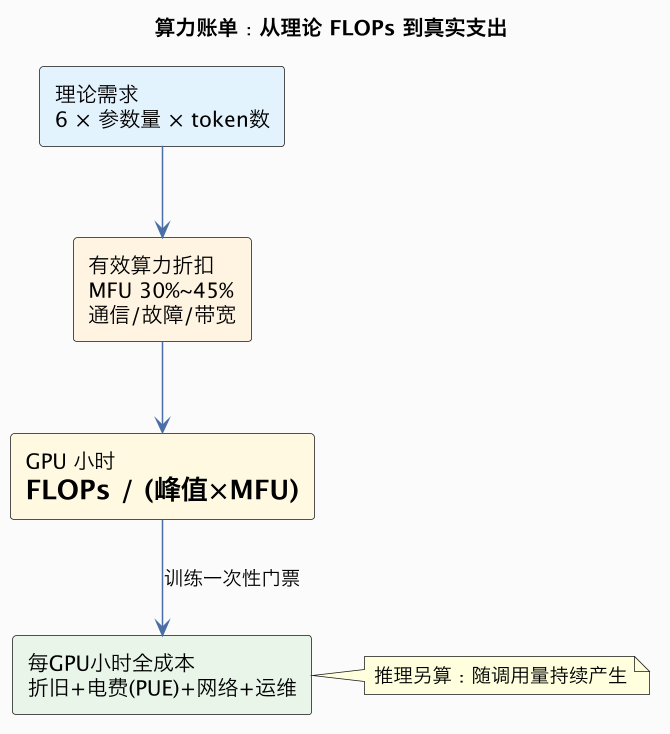
- 算力账单 = 物理计算量 ÷ 有效利用率 × 单位算力成本。 先由参数量和处理的 token 数估出所需 FLOPs(训练约为
6 × 参数量 × token 数),再除以集群实际能稳定输出的有效算力(受 MFU、互联、通信、故障拖累,往往只有理论峰值的 30%~45%),最后乘以"每 GPU 小时的全成本"(硬件折旧 + 电费 + 数据中心 + 网络 + 运维)。每一项都可以量化,也都可能差出一个数量级。 - 训练是一次性"门票",贵但确定;推理是持续"房租",会随用户量滚大。 前沿大模型一次预训练的算力成本常在数千万到上亿美元量级(含失败重试与多版本),但它是一次性的;推理成本与"用户数 × 人均 token × 服务时长"成正比,随着产品规模化,总推理开支完全可能超过训练——这就是"推理(inference)成为新战场"的根本原因。
- 成本下降极快,但"便宜"和"赚钱"是两回事。 芯片代际、量化、算子优化、投机解码、MoE、KV Cache 管理让单 token 成本在一两年里下降一个数量级;但免费/低价产品的调用量可以爆炸式增长,且多模态、长上下文、Agent 多步推理会把单次任务的 token 消耗放大几十上百倍。单位成本暴跌,总账单未必同步下降。
- 真正的瓶颈常常不是算力峰值,而是显存带宽和集群效率。 推理尤其是 memory-bound,HBM 带宽决定了每个 token 能多快读完权重;训练则受万卡互联、通信、checkpoint、故障恢复制约,理论 FLOPs 与有效 FLOPs 之间有巨大缝隙。谁能把利用率做高,谁的真实成本就低。
一句话:大模型不是"一次训练贵"那么简单,它是"一次性巨额训练门票 + 随用量指数增长的推理房租"的组合;决定盈亏的不是 GPU 标称算力,而是你能把多少理论峰值变成有效产出,以及把每个 token 的全链路成本压到多低——算力效率正在成为这个行业最核心的工程和商业指标。
一、第一笔账:训练一次要多少 FLOPs
训练成本的物理底座是计算量。对稠密(dense)Transformer,业内常用的一阶估计是:
前向每 token:约 2 × N  FLOPs(N = 参数量)
训练含前向+反向:约 6 × N  FLOPs / token
训练总算力需求 C ≈ 6 × N × D
  N = 参数量,D = 训练 token 数
举例(纯数量级示意,不对应某一具体模型):
| 模型规模 | 参数量 N | 训练 token D | 估算 FLOPs ≈ 6ND |
|---|---|---|---|
| 70 亿级(7B) | 7×10⁹ | ~2×10¹² | ~8×10²² |
| 700 亿级(70B) | 7×10¹⁰ | ~3×10¹² | ~1.3×10²⁴ |
| 数千亿级 | 4×10¹¹ | ~1×10¹³ | ~2.4×10²⁵ |
这只是"理想数学计算量"。真实账单还要乘以多次实验/调参/重试(同一代模型常训练很多版)、更长迭代周期,以及把 FLOPs 变成 GPU 小时所需的有效利用率折扣。MoE(混合专家)参数量大但每 token 只激活一部分专家,估计要改用激活参数量,但它对显存容量和路由通信的需求仍在。
二、第二笔账:把 FLOPs 换成 GPU 小时和钱
一张加速卡有理论峰值算力,但大集群能稳定跑出来的有效比例(MFU,Model FLOPs Utilization)通常只有 30%~45%,原因包括:
- 通信:张量/流水线/数据并行的 all-reduce、跨节点网络(NVLink/InfiniBand)等待;
- 显存与带宽:权重、梯度、优化器状态、激活值占用 HBM,重算/换入换出有开销;
- 故障与长尾:上万张卡的集群单卡故障频繁,checkpoint、重启、慢节点(straggler)拖慢全局;
- 调度气泡:流水线 bubble、批次不均、数据加载。
计算框架:
所需 GPU 小时 ≈ C / (单卡理论 FLOPS/s × 3600 × MFU)
训练总成本   ≈ GPU 小时 × 每 GPU 小时全成本
每 GPU 小时全成本 ≈ (硬件价 / 折旧月数 / 月有效小时)
                    + (功耗 × PUE × 电价) + 网络/机房/运维摊销
三、第三笔账:推理为什么是"会长大的房租"
推理算式完全不同。单条请求计算量与"处理的 token 数(输入 + 生成长度)"成正比,但分两部分:
- Prefill(处理输入):计算密集,一次性处理整段 prompt,较吃算力;
- Decode(逐 token 生成):访存密集,每生成一个 token 都要把模型权重从 HBM 读一遍,瓶颈是显存带宽而非算力峰值。
由此得到几个反直觉结论:
- 单 token 延迟/成本主要由 HBM 带宽和模型大小决定,不是 GPU 的 FLOPS 标称值。这是 HBM 成为最紧瓶颈的原因(见HBM 与先进封装)。
- 批处理(continuous batching)是推理省钱的命门:把多用户请求拼在一起,一次"读权重"同时服务多条序列,可摊薄数倍到数十倍成本。
- KV Cache 吃显存:长上下文要为每段对话缓存注意力键值,显存容量决定并发,是长文档/多轮对话成本的主要推手。
- 推理总成本随用量线性甚至超线性增长:Agent 完成一个任务要自我循环调用模型几十上百次,总 token 消耗暴涨。
推理月成本 ≈ 月活用户 × 人均请求数 × 每次 token 数
             × 每千 token 成本 + 常驻/空闲实例成本
当产品有数千万上亿用户、每人每天几千到几万 token,即便单 token 成本已很低,月推理账单也可达数千万到数亿美元,长期超过训练投入。这解释了三件事:为什么拼命做推理优化、为什么"卖 token 服务"成为商业模式(见《从卖盒子到卖 Token》)、以及为什么"用户暴涨"对 CFO 可能是坏消息。
四、单位成本暴跌,为什么还普遍不赚钱
过去一两年单 token 推理成本接近一个数量级的下降,主要来自:
| 降本杠杆 | 做了什么 | 代价/边界 |
|---|---|---|
| 芯片代际 | 新 GPU/专用加速器算力带宽大涨 | 采购、供电散热升级 |
| 量化 | FP16→INT8/INT4,减小权重与带宽压力 | 精度损失,需校准评测 |
| 算子/编译优化 | 融合算子、Flash-Attention、更优 kernel | 门槛高,依赖底层软件栈 |
| 投机解码 | 小模型起草、大模型校验 | 命中率高才划算,实现复杂 |
| MoE | 每 token 只激活部分专家 | 参数/显存仍大,路由通信复杂 |
| KV/调度优化 | PagedAttention、连续批处理、缓存复用 | 强平台工程能力 |
但单位成本下降 ≠ 总利润转正,需求侧同时膨胀:多模态(图像/音视频 token 密度远高于文本)、长上下文(prompt 与 KV 暴涨)、Agent 化(一个任务上百次模型调用)、低价竞争(API 当获客手段)。这是"杰文斯悖论"的 AI 版本:用起来越便宜,用量越爆炸,总支出与总电力反而越高。
五、这笔账如何决定产业格局
- 门槛是资本,更是效率:万卡集群的钱、HBM/CoWoS 供给、电力与数据中心,把前沿训练变成少数巨头游戏;同等硬件下,MFU 和推理利用率高的团队成本低、迭代快。
- 全栈锁定的价值在"有效算力":护城河不只是芯片,而是 GPU + NVLink/IB 网络 + 软件栈让万卡集群更稳、MFU 更高、迁移更痛(见英伟达全栈与 CUDA)。
- 算力服务化:多数公司自建集群不划算,租 GPU 云、按 token 付费成为主流,商业模式从卖硬件转向卖算力效用。
- 能源成硬上限:算力尽头是电力,PUE、液冷、供电密度与电价直接进入每 token 成本。
六、对工程师的启示
- 建立成本直觉:定方案前先估参数量、token 量、FLOPs、显存与目标 MFU,把"每请求多少钱"和"效果好"并列为指标。
- 推理系统是高价值方向:continuous batching、KV 管理、量化、投机解码、MoE 路由、专用 kernel——把利用率从 30% 拉到 50% 的工程能力直接对应真金白银。
- 读懂硬件约束:HBM 带宽、显存容量、互联拓扑、PUE/供电是算法工程师绕不开的物理课;架构选择本质是成本决策。
- 职业判断:AI Infra、推理优化、分布式训练、算力调度与容量规划是被账单验证过的确定性赛道。
相关与延伸
- 训练/推理两本账与国产芯片:国产 AI 芯片与算力管制
- 显存带宽与封装供给:HBM 与先进封装
- GPU/加速器知识目录:GPU 与加速计算
- 数据与 AI 应用:数据与 AI
- AI 编程工具:AI 编程工具
一句话总结:大模型的真实账单 =「参数量×token 决定的物理 FLOPs」除以「MFU 只有三四成的有效算力」,再乘以「含电费/PUE/折旧的每 GPU 小时成本」;训练是一次性昂贵门票,推理才是随用户和 Agent 用量持续膨胀、可能更大的长期房租——行业核心竞争力正从"能不能做出模型"转向"能把每个 token 的有效成本压到多低"。
每 GPU 小时全成本随采购价、电价、利用率和折旧年限,在自建满载集群约 1~3 美元/小时量级、云租赁更高之间变化。把上面的 FLOPs、数万卡集群、30%~40% MFU 和数月训练时间代进去,就得到"前沿模型一次正式训练数千万到上亿美元、算上全部试验更高"的量级,与各机构公开估计一致。利用率每下降 10 个百分点,账单就上升约两三成——工程优化直接等于省钱。