GPU 计算(GPGPU / CUDA)
本域讲 GPU 通用计算(GPGPU):架构、CUDA/编程模型、高性能算子、多卡多机与性能调优,主要服务 AI 训练/推理与 HPC。FPGA 视角的对照见 GPU 计算入门与 FPGA 对照,神经网络背景见 nn/。
下面按入门 / 进阶 / 专家三层给出学习地图:每层列出该阶段要掌握的议题,建议顺着路线图由浅入深;已有成文的篇目带链接,可直接点读。
学习路线
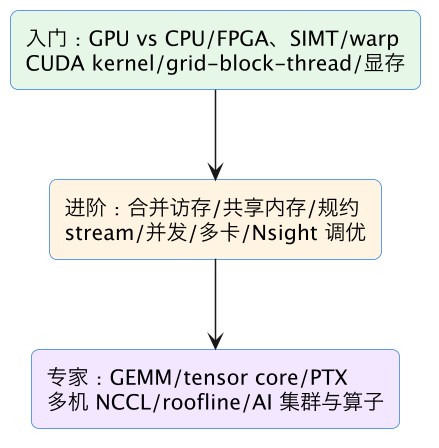
入门(beginner)
入门层先建立“GPU 为什么快、CUDA 程序怎么跑起来”的直觉。FPGA 视角的对照可先读 GPU 计算入门与 FPGA 对照。
- 架构直觉:GPU 是什么(图形卡到通用计算)、GPU vs CPU 架构对照、SIMT 众核模型、warp 与锁步执行、线程发散 divergence、流式 SM 与占用率 occupancy、延迟掩盖与海量线程
- 第一个 CUDA 程序:CUDA 编程模型、grid·block·thread 层级、threadIdx·blockIdx 索引、第一个 kernel 向量加法、
__global__启动配置、host 与 device、cudaMalloc/cudaMemcpy、deviceQuery、编译与 nvcc、运行时 API vs 驱动 API、cudaGetLastError 错误检查 - 显存层次:显存层次总览、全局内存、合并访存 coalescing、共享内存、寄存器与局部内存、
__syncthreads同步、block/grid 维度选择 - 第一批 kernel:规约 reduction、矩阵转置、简单矩阵乘、算术强度直觉、带宽与算力峰值、roofline 模型入门
- 生态与环境:PyTorch/TensorFlow 如何用 GPU、tensor core 是什么、混合精度入门、多 GPU 概念、stream 异步与 event 计时、云 GPU 与 Colab、驱动/CUDA/cuDNN 版本、环境安装排错、cudaEvent 计时、out of memory 常见报错、术语速查
进阶(intermediate)
进阶层从“能跑”走向“跑得快、调得动”:吃透 SM 微架构与访存,掌握常用算子优化、多卡与 Nsight 分析。
- 微架构与访存:SM 微架构(SP/SFU/LD-ST)、warp 调度与双发射、寄存器分配与占用率、共享内存 bank 冲突、L1/L2 缓存、常量/纹理内存、统一内存 UM、cp.async 异步拷贝、访存模式优化
- 常用算子优化:warp shuffle 规约、scan 前缀和、直方图与原子操作、GEMM 分块 tiling、共享内存矩阵乘、卷积 im2col 与 Winograd 直觉、FP16/BF16、WMMA 编程、混合精度实践、elementwise kernel 融合
- 并发与多卡:stream 并发与 overlap、多流流水线、CUDA Graph、多 GPU 数据并行、P2P 与 NVLink、NCCL 集合通信入门、all-reduce 原理、pinned memory 与零拷贝
- 分析与工具:Nsight Systems、Nsight Compute 指标、内存吞吐 vs 计算吞吐瓶颈、occupancy 调优、动态并行、thrust、cuBLAS/cuDNN、PyTorch 自定义算子扩展、CUDA C++ 模板、cuda-gdb 调试、显存池与分配器、MPS/MIG、容器 CUDA 兼容、PTX/cubin、Triton 入门、OpenMP target、InfiniBand 概念
专家(expert)
专家层面向极致性能与大规模 AI 基础设施:指令级优化、集合通信、多机并行与数据中心 GPU。
- 指令级与极致算子:PTX/SASS、寄存器 tiling 与软件流水、tensor core MMA 指令、CUTLASS 分块 GEMM、FlashAttention、kernel fusion 自动化、稀疏 SpMM、INT8/FP8/FP4 低精度与量化 kernel、persistent kernel、网格扫尾与负载均衡、roofline 定量建模
- 多机通信与并行:NCCL 源码级 ring/tree allreduce、通信带宽建模、RDMA/GPUDirect、NVLink/NVSwitch 拓扑、张量并行通信、3D 并行(对照 nn/)、ZeRO 显存分片、流水线并行微批调度、梯度同步与重叠、大模型显存优化
- 推理系统:vLLM PagedAttention、连续批处理、推测解码、Triton/CUTLASS 自定义硬件后端、MPS 多进程服务、GPU 虚拟化分时、ECC/XID 故障排错
- 数据中心与趋势:H100/B200 架构、Grace Hopper NVLink-C2C、RoCE/IB 集群网络、拓扑感知集合通信、训练 MFU 度量、推理 SLA 与批处理、液冷供电与 TCO、GPU vs TPU/FPGA/ASIC(对照 FPGA)、脉动阵列 vs SIMT、性能回归 CI、大规模训练复盘、前沿硬件趋势
相关主题域
- nn/ —— 神经网络与深度学习(GPU 的主要负载:训练/推理);
- fpga/ —— FPGA 加速对照:入门 20 GPU vs FPGA、AI 推理入门、定点量化;
- concepts/cpu/ —— CPU 微架构/缓存(对照理解 GPU 内存层次);
- chip-design/ —— 硬件设计方法(加速器/芯片视角)。
一句话总结
本页是 GPU/CUDA 域学习地图,按入门(SIMT、kernel、显存)、进阶(合并访存、算子优化、多卡、Nsight)、专家(tensor core、NCCL 多机、AI 集群、roofline)三层组织,服务 AI 训练推理与高性能计算。