GPU 并行存储与数据管线
先说结论
- GPU 贵,最怕“等数据”:存储吞吐、元数据、网络或数据预处理跟不上,再强的加速卡也会因 input starvation 空转,MFU 被拖低。
- 训练有两类相反的存储压力:周期性 checkpoint 要高带宽、大块写;训练样本读取要高 IOPS、强元数据、随机小 IO;两者要分开优化。
- 数据管线是端到端系统:从对象存储/数据湖 → 并行文件系统/缓存 → RDMA/NVMe-oF 传输 → 节点本地 NVMe → 多进程 DataLoader 并行读取、解压、增强,每一环都可能是瓶颈。
- 趋势是分层 + 本地化 + 流水线:冷数据放对象存储,热数据在并行文件系统和节点本地缓存,用预取让“数据等 GPU”,并把 CPU 预处理与 GPU 计算重叠。
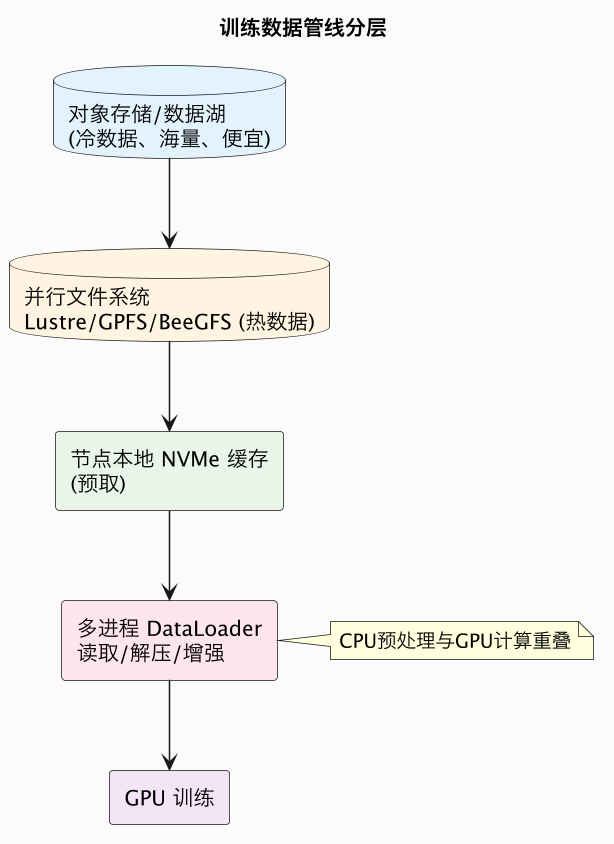
一、存储层次分工
| 层 | 技术 | 擅长 | 在训练中的角色 |
|---|---|---|---|
| 对象/数据湖 | S3 兼容、湖仓 | 容量大、成本低、EB 级 | 原始数据、长期留存 |
| 并行文件系统 | Lustre/GPFS/BeeGFS | 共享高带宽、多客户端并发 | 训练共享数据集、checkpoint |
| 块/本地存储 | NVMe SSD、NVMe-oF | 低延迟、高 IOPS | 本地缓存、热点随机读 |
| 内存缓存 | burst buffer | 极快但贵 | 元数据、超热数据 |
二、checkpoint:最容易被低估的写风暴
万卡训练每隔一段时间要把全部模型/优化器状态写盘,以防故障。模型越大、频率越高,瞬时写入带宽越夸张:
- 若存储写带宽不足,保存 checkpoint 会造成明显停顿;
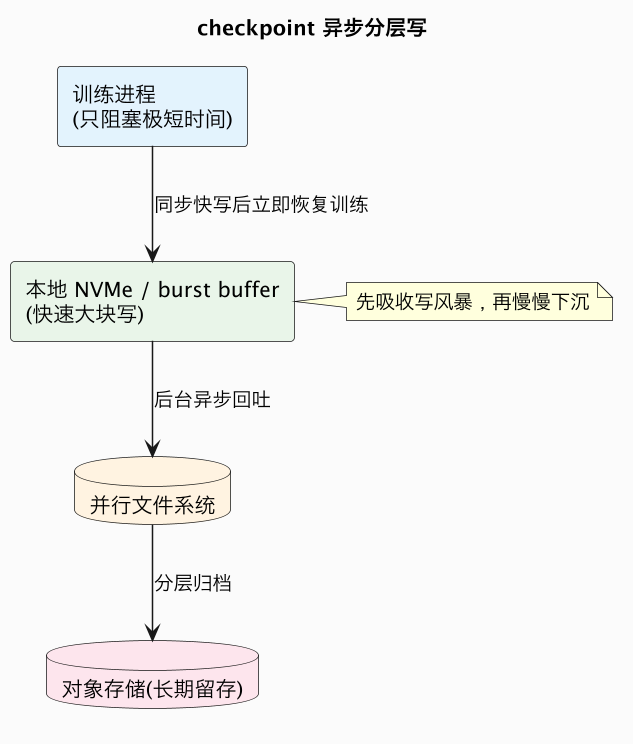
- 实践用异步/分层 checkpoint、增量保存、先写本地 burst buffer 再后台回吐到并行文件系统/对象存储;
- checkpoint 恢复速度还决定故障停机时间。
三、读数据:随机小 IO 与元数据风暴
图像、语音、文本训练常涉及海量小文件随机读取:
- 瓶颈往往不是总带宽,而是 IOPS 和元数据操作(open/stat 大量小文件);
- 对策:把海量小文件打包成大分片(如 shard/sequence file)、顺序读+本地展开,减少元数据往返;
- 并行文件系统要支撑成百上千训练客户端同时打开目录,元数据服务器设计很关键。
四、DataLoader:CPU 别拖 GPU 后腿
即使存储够快,节点内的数据准备也可能卡顿:
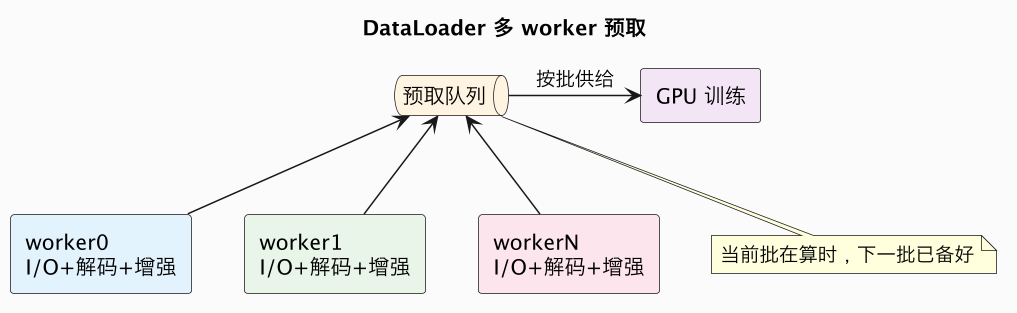
- 用多 worker 进程并行 I/O、解码(JPEG 解压)、数据增强(裁剪/翻转/归一化);
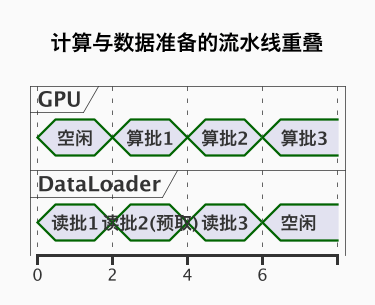
- 设预取队列(prefetch),让下一批数据在 GPU 算当前批时已在后台准备好;
- 必要时把部分增强放到 GPU 上(DALI 等)减少 CPU 瓶颈;
- 若 CPU 核数、内存或本地盘不足,workers 越多反而争抢更严重。
五、AI 存储 vs 传统 HPC 存储
| 维度 | 传统 HPC | AI 训练 |
|---|---|---|
| 典型 IO | 大块、规整 | 海量随机小文件 + 大 checkpoint 并存 |
| 元数据压力 | 中 | 高 |
| 写特征 | 周期性结果 | 高频巨大 checkpoint |
| 客户端规模 | 中 | 数千 GPU 同时挂载 |
| 新增需求 | — | 数据版本、与数据湖/MLOps 集成 |
六、常见优化清单
- 小文件打包成大分片、顺序读;
- 热数据集缓存到本地 NVMe / burst buffer;
- checkpoint 异步分层(本地先写、后台回吐);
- 存储与计算网分离或 QoS 隔离,避免 checkpoint 抢占读带宽;
- DataLoader 多 worker + 预取,监控每阶段等待时间;
- 用 GPU 利用率/输入等待指标反推瓶颈在哪一环。
七、深度专题:一次 checkpoint 的“写风暴”全解剖
在所有 AI 存储问题里,checkpoint 最能体现“存储直接拖慢训练”。要理解它,需要把一次保存动作里到底发生了什么拆开。
1. 一次 checkpoint 要写多少东西
训练状态远不止模型权重,还包括优化器状态。以常见 Adam 类优化器为例,除了参数本身,还要保存一阶矩、二阶矩等,总状态量可能是模型权重的数倍。万亿参数模型一次完整 checkpoint 的数据量可达数百 GB 到 TB 量级,而万卡集群要在很短时间窗口内把这些状态从显存/内存搬到存储。
2. 同步保存为什么会造成“停顿”
若采用最简单的同步方式:所有 GPU 在某个 step 同时停下、把状态写到共享并行文件系统、确认写完再继续训练,则会出现:
- 数千客户端同时发起巨量写,瞬时打满存储和网络带宽;
- 并行文件系统的元数据和数据服务器出现排队;
- 昂贵的 GPU 在写入期间整体空转,训练曲线出现周期性“卡顿”。
3. 工程上的三层解法
- 本地/近 GPU 先写(burst buffer):先把 checkpoint 高速写到节点本地 NVMe 或专用缓冲层,GPU 快速解套恢复训练,再由后台异步把数据回吐到并行文件系统/对象存储;
- 分层与增量:高频保存“轻量状态”,低频才存完整快照;对部分框架采用分片/增量,减少每次写入量;
- 错峰与 QoS 隔离:将 checkpoint 流量与训练读数据集的流量隔离(独立存储网或服务质量限制),避免写风暴抢占读带宽。
4. checkpoint 还决定“故障恢复时间”
万卡集群几乎每天都可能遇到坏卡、网络或节点故障,恢复时要从最近 checkpoint 重新加载。读取带宽不足、检查点太旧,都会拉长停机时间、浪费算力。因此成熟团队同时优化“写得快、存得稳、恢复得更快”,并据此选择 checkpoint 频率——频率太高浪费写带宽,太低则故障时重算过多。
八、数据格式工程:海量小文件为什么是“元数据灾难”
与 checkpoint 的大块写相反,训练样本读取常是另一极端:海量小文件、高随机、强元数据。
1. 小文件的瓶颈不在带宽
- 读取一个样本往往要先做
open/stat/seek等多次元数据往返,真正的数据字节反而很小; - 当成百上千个训练进程同时遍历海量目录,元数据服务器(而非数据服务器)先成为瓶颈;
- 表现为:存储标称带宽没用满,GPU 却在等数据。
2. 打包成大分片是标准做法
把成千上万小样本按规则打包成数量少、体积大的分片文件(如 shard/record 格式),训练时顺序读取大块、在内存里展开成样本:
- 元数据操作从“每文件一次”降为“每分片一次”;
- 顺序读充分发挥磁盘/并行文件系统吞吐;
- 配合本地缓存,热门分片只从共享存储读一遍。
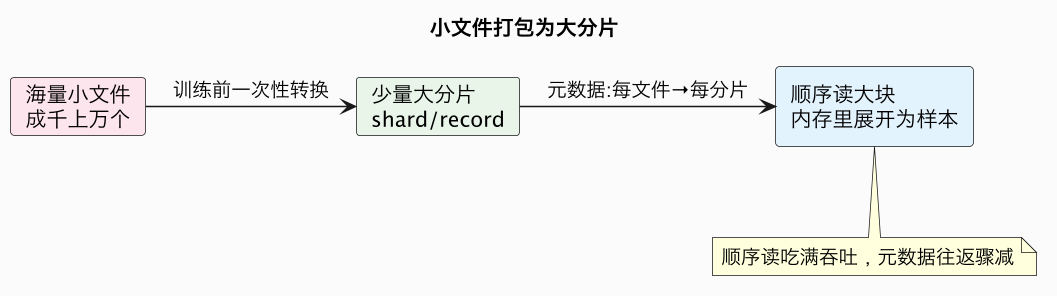
这要求数据工程在训练前就完成“原始数据→分片→版本化数据集”的转换,而非让训练作业直接面对原始小文件。
九、端到端调优:把整条数据管线当成一个系统
单看某一层(只换更快的存储、或只加 DataLoader worker)往往收效有限,因为瓶颈会在层间转移。系统级方法是先建立分段计时与监控,再针对最慢的一环动手。
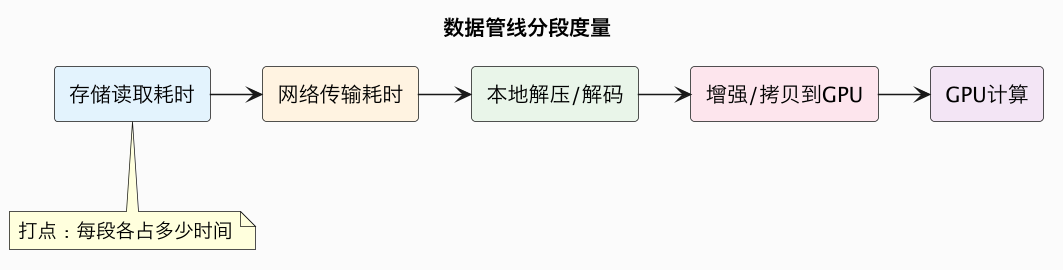
| 症状 | 更可能的瓶颈 | 对策 |
|---|---|---|
| 存储带宽没满、GPU 等待 | 元数据/小文件 | 打包分片、元数据优化 |
| 周期性卡顿 | checkpoint 写 | 异步分层、错峰 |
| 网络打满 | 传输/缺本地缓存 | 预取到本地 NVMe |
| CPU 跑满、GPU 抖动 | 解码/增强 | 多 worker、GPU 加速(DALI) |
| worker 增多反而更慢 | CPU/内存/本地盘争抢 | 控制并发、加资源 |
核心原则是让流水线充分重叠:数据准备(I/O、解码、增强)与 GPU 计算并行,用预取队列保证“下一批在算当前批时已备好”,最终用 GPU 的输入等待时间和 MFU 来判断整条管线是否真正喂饱了算力。
十、并行文件系统内部:Lustre/GPFS 的架构直觉
要做存储选型和优化,需要知道并行文件系统凭什么能让数千客户端高速共享数据。它们的核心思想是把“数据”和“元数据”分离、并在大量服务器上并行分布。
1. 数据与元数据分离
- 元数据操作(文件名、目录、权限、位置、属性)交给专门的元数据服务器(MDS/MDT);
- 实际数据分散在大量对象存储目标(OSS/OST)上,多个客户端可同时从不同目标并行读写,聚合带宽随服务器数量扩展;
- 这种分离使“遍历海量小文件”和“大块顺序读”可以分别扩展、分别调优。
2. 三种主流系统的定位
| 系统 | 出身/生态 | 典型场景 | 特点 |
|---|---|---|---|
| Lustre | 开源、HPC 血统 | 超算、大规模训练 | 极致并行扩展、规模大 |
| GPFS/Spectrum Scale | IBM | 企业 HPC、混合负载 | 强一致性、企业特性丰富 |
| BeeGFS | 相对轻量易用 | 中小 HPC、AI 集群 | 部署简单、起步友好 |
选型不仅看峰值带宽,还要看团队运维能力、与现有数据湖/云的集成、客户端规模以及对元数据密集型负载的表现。
十一、数据湖与 AI 存储的融合趋势
现代 AI 平台越来越少依赖单一存储,而是把“湖、仓、文件、缓存”打通,形成分层且数据可流动的体系:
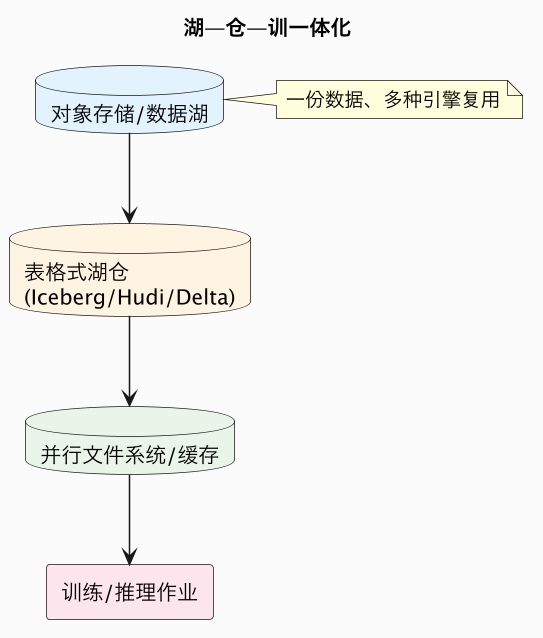
- 冷数据统一放对象存储,用开放表格式管理,避免被单一格式锁定;
- 训练前通过缓存/并行文件系统按需预热到靠近 GPU 的层;
- 数据版本、血缘与特征管理与训练实验打通,保证“用哪版数据、训出哪个模型”可追溯。
这种“一份数据、多引擎复用、按需向算力流动”的架构,正在取代过去“每上一个项目就拷一份数据”的烟囱式做法,既降成本也让数据管线更可治理。对企业而言,AI 存储竞争的制高点不只是带宽,而是数据在各层之间的流动效率、版本治理和端到端可观测性。
十二、给读者的判断框架
- 排查训练慢,先区分是“算不动”还是“喂不饱”:用 GPU 输入等待时间和分段打点定位,多数大规模瓶颈在数据侧。
- 设计存储,把“大块 checkpoint 写”和“海量随机样本读”当两类负载分别优化,并做流量隔离。
- 建数据平台,追求“一份数据、按需向算力流动、全程可版本追溯”,避免烟囱式拷贝。
- 衡量成效,最终落到 MFU 与单位算力产出,而非存储的标称峰值带宽。
并行存储与数据管线常被当作“基础设施配角”,但在万卡时代它直接决定昂贵算力的兑现率——把数据供给做成系统工程,是把 GPU 投入转化为真实训练效率的前提。
常见误区
- 只盯 GPU 算力,忽视输入饥饿:数据管线常是 MFU 真正短板。
- 用总带宽判断存储够不够:随机小 IO 场景要看 IOPS/元数据。
- checkpoint 同步写:会造成周期性训练停顿。
- DataLoader worker 越多越好:受 CPU/内存/本地盘约束。
- 冷数据直接让万卡读对象存储:缺少预热层会卡顿。
总结
GPU 训练的数据供给是“对象存储→并行文件系统→本地 NVMe→DataLoader→GPU”的端到端流水线,大 checkpoint 考大块写带宽、海量小文件考 IOPS 与元数据;靠分层缓存、数据打包、异步检查点、存储计算隔离和多 worker 预取让“数据等 GPU”,才能把昂贵算力真正转化为高 MFU,而非空等输入。