AI 监管与主权地缘
先说结论
- 监管从“管内容”扩展到“管能力与算力”:除了内容安全、隐私、版权,高能力模型、训练算力和芯片本身也成为政策对象。
- 三大法域路径不同:欧盟走统一风险分级立法(AI Act);美国偏行政命令+行业自律+强力出口管制;中国以生成式服务备案、算法治理与产业政策并重。
- AI 与国家战略深度绑定:芯片、HBM、先进制造、开源权重和数据中心都被视为战略资产,催生“主权 AI”、本土算力与数据本地化。
- 企业挑战是“多法域同时合规”:要把风险评估、内容标识、数据治理、模型与供应商管理嵌入产品全生命周期。
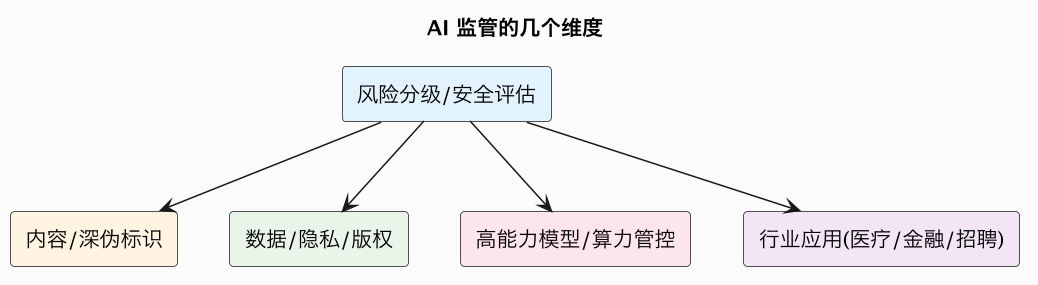
一、主要法域对比
| 法域 | 代表工具 | 风格 | 关注点 |
|---|---|---|---|
| 欧盟 | AI Act | 统一立法、风险分级、重处罚 | 基本权利、透明度、高风险义务 |
| 美国 | 行政令、机构规则、出口管制 | 分散+自律+国家安全 | 安全测试、芯片/算力管制 |
| 中国 | 生成式 AI 办法、算法备案、产业政策 | 发展与安全并重、强执行 | 内容安全、备案、自主可控 |
| 其他多国 | 主权 AI、本地数据/算力 | 追赶+保护 | 不被少数平台/国家主导 |
二、为什么“算力”成地缘焦点
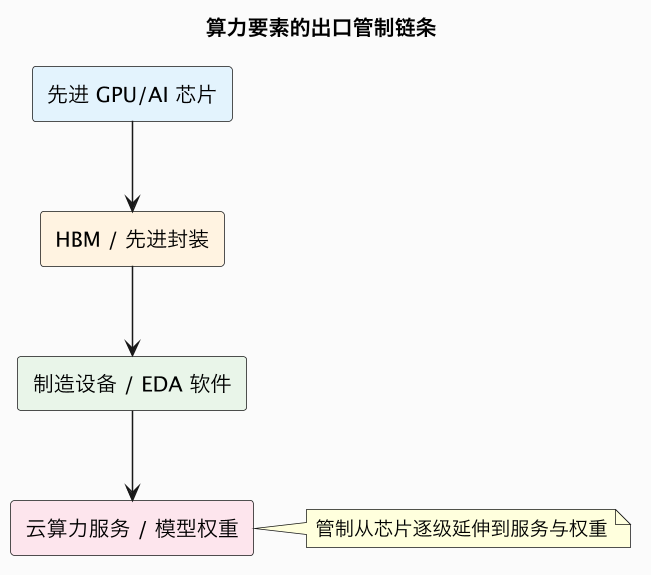
- 先进 AI 能力高度依赖 GPU、HBM、先进封装和电力,控制这些要素≈影响他国 AI 发展;
- 出口管制从芯片延伸到制造设备、软件(EDA)、云算力服务和权重;
- 被限制方加速国产替代与本土生态,形成两套供应链的风险。
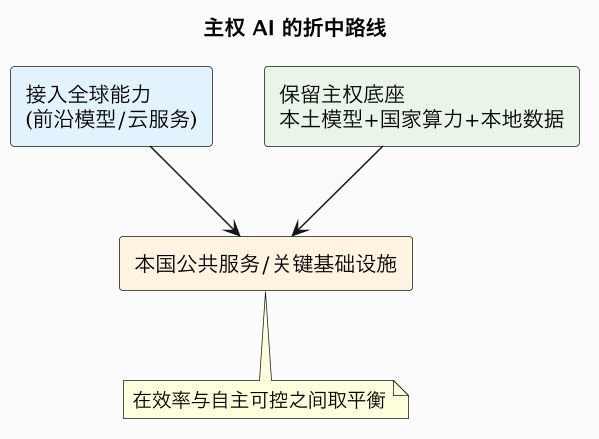
三、主权 AI:为什么各国都要“自己的模型/算力”
- 担心关键基础设施与公共服务依赖少数外国平台,存在断供、数据外流与价值导向风险;
- 推动本土大模型、国家/区域算力中心、数据本地化与开源生态;
- 现实约束:算力成本、人才与生态规模,使多数国家只能在“接入全球能力 + 保留主权底座”之间折中。
四、开源:监管的新难题
- 开放权重扩散了能力,也使“如何管制高能力模型”更难——一旦公开就难以收回;
- 支持者认为开放利于创新、分散风险与主权自主;
- 监管者关注高能力权重的发布门槛、滥用与责任归属,规则仍在博弈。
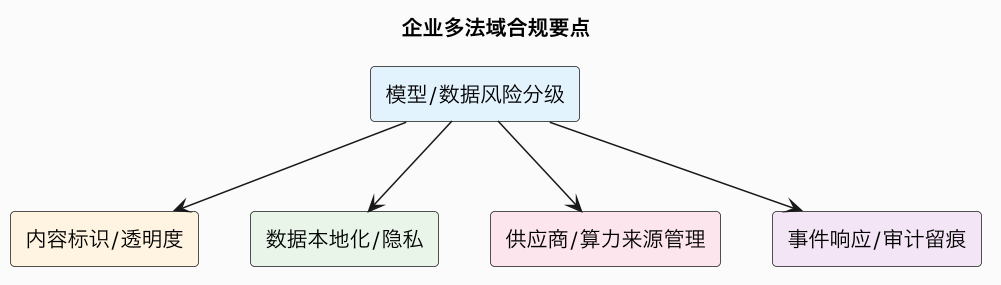
五、对企业的含义
- 把合规“左移”到设计阶段,而非上线前补救;
- 建立数据与模型台账,清楚数据在哪、模型来自谁、算力在何法域;
- 为内容生成与深伪提供标识与溯源;
- 关注供应链:芯片/云/开源模型的管制变化可能突然影响业务;
- 在不同区域采用差异化部署与数据策略。
六、深度专题:监管为何从“管内容”走向“管能力与算力”
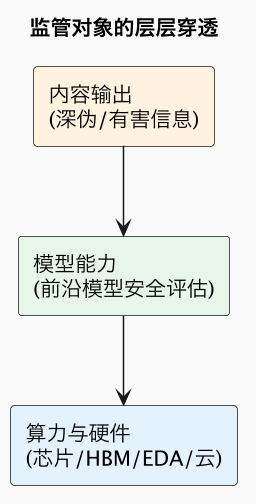
理解 AI 治理的演进,关键是看清监管对象的两次扩展:从最初的内容输出,扩展到模型能力,再延伸到支撑能力的算力与芯片。每一次扩展都对应着风险认知的变化。
1. 第一代:管内容与算法
早期生成式 AI 治理聚焦“它对公众说了什么”:有害信息、虚假内容、深度伪造、个人隐私、版权侵权。监管手段是内容审核、标识、算法备案与平台责任——本质上沿用了对互联网内容平台的治理框架。
2. 第二代:管模型能力本身
随着模型在推理、代码、自主行动上变强,监管者意识到风险不只在输出,还在底层能力:一个足够强的模型即使没有恶意引导,也可能被用于网络攻击、生化辅助、大规模操纵。于是出现对“高能力/前沿模型”的安全测试、风险评估、训练算力报告等要求——监管开始穿透到模型层。
3. 第三代:管算力与硬件
既然能力由算力规模驱动,控制算力就成为影响 AI 发展的杠杆:
- 出口管制从先进芯片扩展到 HBM、制造设备、EDA、甚至云算力服务和模型权重;
- 数据中心、电力、超大集群被纳入战略与安全视野;
- 这使 AI 治理与产业政策、贸易、国防彻底交织。
七、三大法域的治理哲学
| 法域 | 哲学 | 优势 | 争议 |
|---|---|---|---|
| 欧盟 | 统一立法、风险分级、普适合规 | 规则清晰、权利保障强 | 成本高、或抑制创新 |
| 美国 | 行政令+分散监管+行业自律+强出口管制 | 灵活、产业发展快 | 规则不统一、碎片化 |
| 中国 | 发展与安全并重、备案+产业政策、强执行 | 落地快、推动自主可控 | 合规义务与备案要求细 |
差异背后是不同的价值排序:欧盟优先基本权利与确定性,美国优先创新与国家安全,中国在推动产业发展的同时高度重视内容安全与自主可控。企业不能指望“一次合规全球通行”。
八、主权 AI 与开源的两难
- 主权 AI 兴起:各国担心关键能力与基础设施受制于少数外国平台,推动本土模型、国家算力中心、数据本地化;但算力、人才与生态成本高企,多数只能采取“接入全球能力 + 保留主权底座”的折中。
- 开源悖论:开放权重利于创新、分散风险、支持主权自主,但也让高能力一旦发布便难以收回,给“管制能力”和防滥用带来难题,责任归属仍在博弈。
九、企业的多法域合规框架
- 合规左移:在设计阶段做风险分级,而非上线前补救;
- 建立台账:清楚数据位置、模型来源、算力所在法域与供应链;
- 内容标识与溯源:为生成内容/深伪提供可识别标记;
- 供应链韧性:芯片、云、开源模型的管制可能突变,需备选方案;
- 区域化部署:不同法域采用差异化数据与部署策略,并保留审计留痕与事件响应机制。
中立判断:监管不是 AI 的对立面,但其节奏、尺度和地缘化程度会深刻决定企业可用的技术栈与市场范围。在全球化效率与主权合规之间持续平衡,将是所有 AI 企业长期的必修课。
十、AI 对就业结构与劳动市场的中长期影响
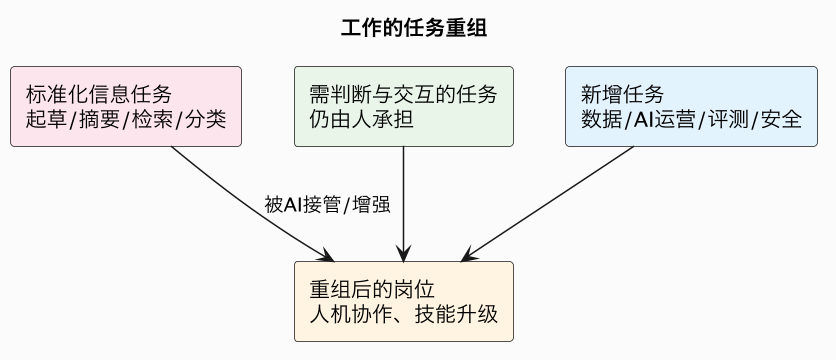
监管与 AI 讨论中绕不开一个社会议题:它如何改变就业。更准确的框架不是“AI 取代多少岗位”,而是任务层面的重组——一份工作由许多任务构成,AI 接管其中一部分,工作的内容、技能要求和人机分工随之改变。
1. 任务重组而非整体替代
- 最先被改变的是工作中可数字化、有明确规则、信息处理密集的任务:起草、摘要、检索、分类、初步分析、客服应答、代码样板;
- 同一份职业往往一部分任务被增强、另一部分仍需人,因此更常见的是“岗位技能要求变化”而非岗位立刻消失;
- 历史上技术革命更多是重塑分工、创造新角色,但过渡期的成本分配并不均匀。
2. 谁受益、谁承压
- 高技能且善于用 AI 杠杆的人,产出被放大,出现“能力溢价”;
- 从事高度标准化信息任务、又不易转向新技能的群体,议价能力承压;
- 同时催生新需求:数据、AI 运营、提示与流程设计、评测、安全、行业落地等岗位。
3. 为什么这进入政策视野
就业与收入分配关系社会稳定,因此即使 AI 提高了总生产率,政策也要面对转型成本、再培训、社会保障。这也是各法域在“促进创新”和“防控冲击”之间权衡的重要内容。负责任的产业讨论应同时承认效率收益与分配现实,而非只取一端。
十一、全球治理协作的可能与障碍
AI 风险(如大模型滥用、深伪跨境传播)天然跨国界,理论上需要国际协作,但现实障碍明显:
| 维度 | 协作的难点 |
|---|---|
| 战略竞争 | AI 被视为国力竞赛,难以真正互信 |
| 价值差异 | 对言论、权利、国家角色理解不同 |
| 技术节奏 | 规则还没成形,技术已迭代数代 |
| 执行能力 | 各国监管与执法水平不一 |
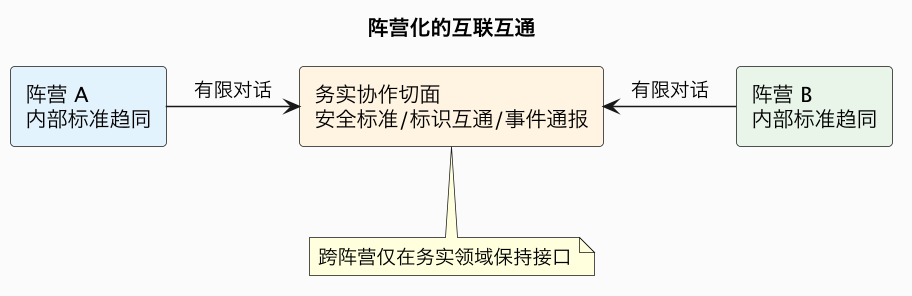
可能的协作切入点是相对务实的领域:前沿模型安全测试标准、深伪标识互通、重大风险事件通报、科研合作与开放标准。总体趋势是“阵营化的互联互通”——价值观与利益相近的群体内部标准趋同,跨阵营则保持有限对话。对跨国企业,这意味着要为一个规则分化、偶发脱钩的世界做长期架构准备,而不能假设技术与数据全球无缝流动。
十二、给读者的判断框架
- 理解监管演进,记住对象正从“内容”穿透到“模型能力”再到“算力硬件”,合规视野要同步前移。
- 做多法域合规,放弃“全球统一规则”的假设,按区域差异化设计数据、模型与供应链。
- 看待主权 AI 与开源,理解二者都内含“自主 vs 依赖、开放 vs 可控”的真实两难。
- 关注社会维度,把就业任务重组与转型成本纳入判断,避免只谈效率不谈分配。
AI 监管与主权之争,是技术能力、产业利益与国家安全交织的长期博弈;对所有参与者,与其幻想一个无缝全球市场,不如尽早建立在分化世界中保持韧性与合规的能力。
常见误区
- 把 AI 监管理解为只关乎内容审核:已扩展到模型能力与算力/芯片。
- 认为有一个全球统一规则:各法域分化,合规必须本地化。
- 忽视开源权重的监管与滥用风险:开放不等于无责任。
- 把主权 AI 当纯技术问题:本质是产业政策与国家安全。
- 低估供应链突变:出口管制可迅速改变可用技术栈。
总结
AI 治理已从内容、隐私、版权延伸到高能力模型与算力芯片本身,欧盟重立法、美国强管制与自律、中国发展安全并重;围绕芯片、HBM、开源权重和数据中心形成新的地缘博弈,推动主权 AI 与本土化。企业需要在设计阶段就做多法域风险分级、数据与供应链管理,在全球化效率与主权合规之间持续平衡。