多模态大军备:文本之外,图像、视频与语音模型的算力和生意
最后更新:2026-09-20|数据截止 2026 年中:视频生成模型迭代极快、能力与成本每季度都在变,本文讲技术结构与成本逻辑,不引用未经核实的具体生成时长、分辨率和价格数字;产品能力以官方最新发布为准。
本文是产业观察,回答三个问题:为什么模型公司集体从「会打字」冲向「会看、会听、会做视频」;视频生成为何贵到能重新定义算力需求;这场军备竞赛最后谁更有底气。 推理模型与测试时算力 讲「想得久」带来的算力账,本文讲「看得见、动起来」带来的另一本更重的账;它和 训练数据墙(视频数据稀缺)、云三巨头资本开支(算力谁买单)、端侧 AI(多模态往终端走)咬合。
先说结论
- 多模态不是给文本模型「加个图片输入」的小升级,而是让模型直接从像素、声音里学习世界规律。 前沿判断认为,只在文本上压缩知识存在天花板,而视频、图像、语音携带了大量文本无法表达的物理直觉与因果信息,「原生多模态」是走向更强通用能力的必经路。
- 视频生成是当前最贵的 AI 任务,没有之一。 视频是「每秒几十帧、每帧百万像素」的高维数据,训练数据量、生成时的逐步去噪/预测、序列长度都把算力和显存消耗放大一个数量级以上,生成几秒高质量视频的成本远高于生成几万字文本。
- 成本曲线决定了商业化节奏:图像先赚钱、语音紧随、视频先烧钱。 图像生成已渗透营销、设计、电商;语音在客服和陪伴落地;视频还处在「demo 惊艳、规模化盈利艰难」的阶段,谁能把成本快速打下来,谁就打开电影、广告、游戏、仿真这些大市场。
- 军备竞赛的底气 = 数据 + 算力 + 场景三者的乘积。 拥有海量视频/图文数据、自研芯片与云资本开支、以及能把多模态塞进搜索/社交/办公/手机的分发场景的公司,胜算更大——这让多模态进一步向少数巨头集中,但也给垂直数据和应用留了缝隙。
一句话:文本是 AI 理解人类语言的起点,而图像、语音、视频是它理解真实世界的入口;视频生成把「智能的成本」从文字尺度拉到了像素尺度,谁能驯服这笔呈数量级膨胀的算力与数据开销,谁就拿到下一阶段内容产业和「世界模型」的门票。
一、为什么非要走出文本不可
过去几轮大模型的突破主要发生在文本上,这给人一种错觉:语言是智能的全部载体。但稍微想想就知道,人类认识世界绝大部分不通过文字——婴儿是通过看、摸、听来理解「东西往下掉」「杯子摔碎」「人脸表情变化」的。文本是对世界的高度压缩描述,压缩过程中丢掉了海量的物理常识、空间关系和因果细节。
前沿实验室因此押注一个判断:只在文本上做下一 token 预测,迟早遇到知识和 grounding(接地,即符号与真实世界对应)的天花板,而多模态数据是绕开天花板的路。
| 信息形态 | 携带的信息 | 文本能否替代 | 典型任务 |
|---|---|---|---|
| 文本 | 语言知识、抽象概念、推理 | 本体 | 问答、写作、代码 |
| 图像 | 空间、外观、图表、细粒度视觉 | 大量不能 | 识图、OCR、文生图、医疗影像 |
| 语音 | 语气、情感、说话人、实时性 | 部分 | 语音助手、会议、陪伴、口译 |
| 视频 | 时序、运动、物理因果、事件过程 | 基本不能 | 文生视频、动作理解、机器人/自动驾驶 |
这里要区分两种「多模态」的做法,它们的技术野心差很多:
- 拼接式(适配层路线):在一个成熟文本模型外挂图像/语音编码器,用适配层把不同模态投影到文本的表示空间。优点是快、省、能迅速上线「看图说话」;缺点是各模态只是「翻译」给文本大脑,理解深度受限于文本表征。
- 原生多模态(early fusion / 统一表示):从一开始就用统一的表示和目标函数,在文本、图像、音频、视频混合数据上从头(或从早期层)联合训练。更难、更贵,但被认为更可能让模型真正「看懂」世界,也是前沿大厂的主攻方向。
这和 训练数据墙 的争论直接相关:高质量文本是有限的,而互联网上未被充分利用的视频、图像是更广阔(也更难处理)的数据矿。多模态既是能力升级,也是对「文本数据见底」的一种突围。
二、视频生成为什么这么贵:把账拆开
理解多模态的产业格局,关键是理解成本。图像已经相对便宜,语音更便宜,视频之所以还在烧钱阶段,要从数据的维度和生成的机制两笔账看。
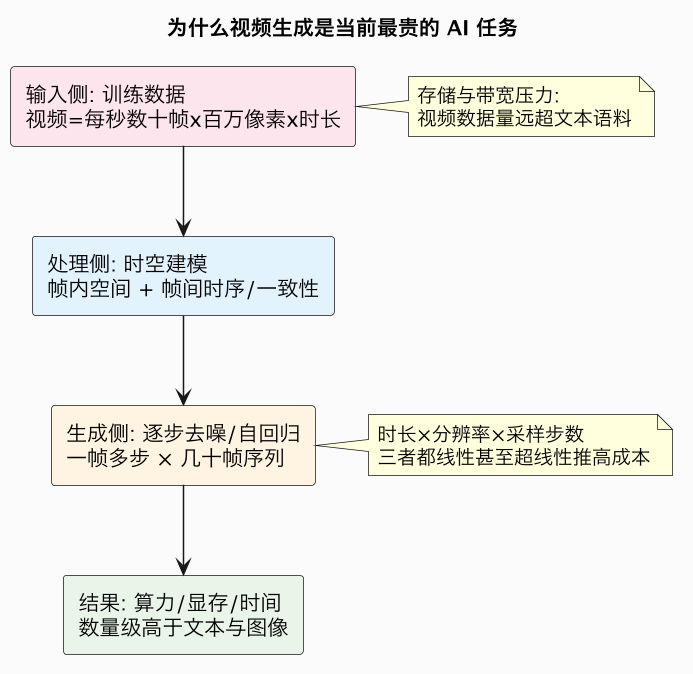
第一笔,数据维度。 一段视频的信息量 = 分辨率(每帧像素)× 帧率(每秒帧数)× 时长(秒数)× 通道,再乘上整个数据集的视频条数。相对文本 token,视频是高维稠密信号,训练时要解码、抽帧、对齐音频和字幕,存储和 I/O 压力巨大。视频数据本身还更稀缺、更脏、版权更复杂(见 数据版权之争 与数据墙系列)。
第二笔,生成机制。 主流高质量视频生成多基于扩散类模型(diffusion)或扩散式 Transformer:不是一次吐出结果,而是从一片噪声出发,经过几十步去噪逐步「雕刻」出画面,而且要对序列中每一帧都做这件事,同时保证帧与帧之间不闪烁、物体不形变、运动符合物理(时空一致性)。成本大致随「帧数 × 每帧去噪步数 × 分辨率」增长,任何一项翻倍,开销都显著上升。自回归视频路线则把帧当 token 序列预测,长序列同样吃显存和 KV Cache(KV Cache 经济性 里的带宽账在这里更夸张)。
把它和其他任务放在一张成本梯度上看,商业化先后顺序就很好理解了:
| 任务 | 单任务算力/成本 | 时序一致性难度 | 商业化阶段 |
|---|---|---|---|
| 文本生成 | 低 | 无 | 成熟、价格战(API 商品化) |
| 语音合成/识别 | 低~中 | 连续但维度低 | 规模落地 |
| 图像生成 | 中 | 无(单帧) | 已盈利(营销/设计/电商) |
| 视频生成(短视频) | 高 | 高 | demo 惊艳、成本快速下降中 |
| 长视频/高分辨率/可控 | 极高 | 极高 | 前沿探索、尚未规模化盈利 |
所以视频赛道的核心竞争,一半是「效果谁更惊艳」,另一半是「谁能用更好的模型架构、蒸馏、量化(推理降本)和专用推理芯片,把每秒视频的成本快速打下去」。成本曲线每往下走一截,可用市场就从「短广告片」扩到「剧集预览、游戏过场、教育仿真、机器人与自动驾驶的合成数据」——后者尤其关键,视频生成若能产出物理可信的画面,就可能成为 具身智能 和自动驾驶的「世界模拟器」与合成数据来源,价值远不止影视。
三、军备竞赛:数据、算力、场景的乘法
多模态不是有钱就能赢,它同时考验三种资源,且三者是乘法关系——任何一项是短板,总分都上不去。
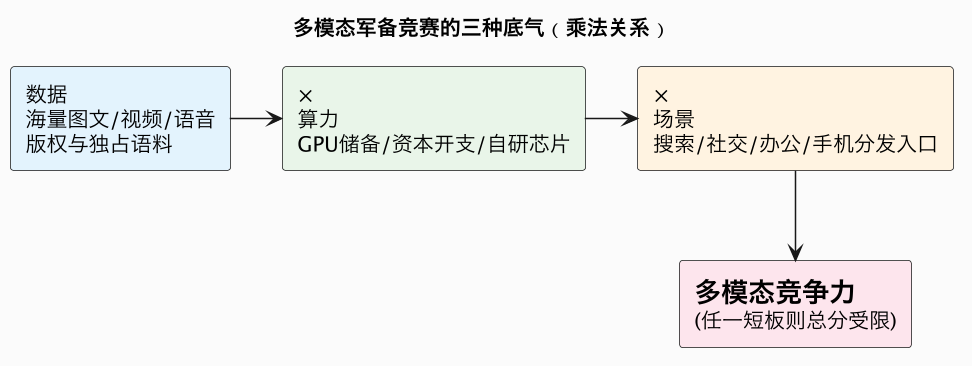
- 数据:谁拥有大量带标签或天然配对的图文、视频、语音,谁就占优。社交平台、视频网站、搜索公司、手机厂商掌握着海量真实用户产生的多模态数据和使用反馈;但视频版权、创作者分成、数据合规也是绕不过的成本(数据标注与 RLHF 里讲过高质量反馈的价值)。独占、私域、实时的数据比公开爬取的更有壁垒。
- 算力:视频训练与推理的高成本,让这场竞赛直接挂靠在 云三巨头资本开支 的总水龙头上。能锁定大批 GPU、甚至用 自研 ASIC 摊薄成本的公司,才玩得起长时间、高频率的视频模型迭代。
- 场景:同样一个视频模型,放进搜索(答案直接带视频)、社交(用户自传播)、办公/创作套件(生产力付费)、手机系统(端云协同,见 端侧 AI)的分发效率天差地别。没有高频入口的纯模型公司,容易沦为给有场景的巨头打工(API 商品化 的老问题在多模态重演)。
这三者叠加的结果是进一步向既有巨头集中:同时握有数据、算力、入口的玩家屈指可数。但缝隙依然存在——在垂直领域(医疗影像、工业质检、影视特效、游戏资产、专业配音),专有数据和工作流深度仍然能养活专精公司;提供视频生成的工具链、推理优化、版权结算等「卖铲」环节,也有独立机会。
四、语音与图像:更安静、但更早赚钱的两兄弟
视频吸走了眼球,但从产业和现金流角度,图像与语音反而更值得算细账,因为它们已经在大规模赚钱。
图像生成是生成式 AI 里商业化最顺的模态之一。营销素材、电商商品图、广告创意、游戏美术、建筑效果图、自媒体配图……这些场景对「快速、便宜、可商用」的需求远大于对「艺术独创性」的执念。工作流从「文生图」走向「图生图、局部重绘、风格统一、批量出图 + 人工精修」,价值点从模型本身转向可控性、版权安全和与设计软件的集成。纯模型 API 迅速同质化、价格下 跌,能嵌入客户工作流、保证可商用版权、提供企业级管控的厂商才能留住预算。
语音则在两个相反方向同时渗透:一边是降本,客服、呼叫中心、会议纪要、有声书用语音识别与合成替换人力;另一边是体验和陪伴,实时对话、情感语音、AI 伴侣、游戏 NPC 对自然口语的要求越来越高(与 AI 陪伴/内容 同属 C 端先变现的赛道)。实时、低延迟、有情感表现力的语音模型把算力推到了端侧和边缘,和端侧 AI、推理芯片 的故事相连。语音还常是多模态助手的「入口」——能自然对话,才谈得上无处不在的 AI 助理。
值得提醒:图像、语音、视频都绕不开真实性与版权这两道社会关卡。AI 生成内容的标识、换脸换声滥用、训练数据的创作者授权,正在成为监管重点(深伪与 AI 安全 专门展开)。多模态能力越强,这道合规成本越高,某种程度上也更利好有能力做溯源、确权和内容审核的大平台。
五、变量与置信度判断
| 变量 | 作用方向 | 时间窗 | 置信度 |
|---|---|---|---|
| 模型从拼接式走向原生多模态 | 视觉/语音理解深度提升 | 已发生、延续 | 高 |
| 视频生成单位成本快速下降 | 商用市场从广告扩向影视/仿真 | 2~5 年 | 中高 |
| 多模态推高训练与推理算力 | 利好 GPU/自研 ASIC/资本开支 | 已发生 | 高 |
| 数据+算力+场景向巨头集中 | 纯模型创业公司被挤压 | 已显现 | 高 |
| 视频成为世界模型/合成数据来源 | 外溢到机器人、自动驾驶 | 3~7 年 | 中 |
| 长视频的强物理一致性被攻克 | 决定影视级市场能否打开 | 3~8 年 | 中 |
- 未来 1~2 年(高置信度):原生多模态成为头部旗舰模型的标配而非卖点,图像和语音在营销、客服、办公、手机场景规模变现;视频继续在短视频、广告、预览类场景渗透,单次生成成本持续快速下降,但长时长、强逻辑一致仍是短板。
- 未来 3~5 年(中高置信度):视频生成进入游戏、影视预览、教育仿真和合成数据管线,成本和可控性决定渗透速度;多模态算力成为资本开支的重要增量,巨头凭数据+算力+入口集中度进一步提高,垂直公司靠专有数据和工作流守住细分市场。
- 未来 5 年以上(中置信度):若视频模型能稳定生成物理可信、长时长一致的画面,它会从「内容工具」升级为机器人/自动驾驶的「世界模拟器」,价值逻辑从文娱扩展到具身智能训练,成为多模态最大的想象空间。
六、对不同角色,这意味着什么
- 对模型公司:纯文本能力趋同后,多模态是差异化主战场,但要算清视频的成本账——把单位生成成本打下去的工程能力,和把效果做惊艳的研究能力同等重要;没有分发场景的团队应尽早绑定高频入口或深耕垂直数据。
- 对内容/营销/影视行业:图像已到「工作流重构」阶段,视频先从预可视化、广告、短内容切入,把 AI 当「可批量迭代的生产要素 + 人工精修」比追求一次成片更现实;同时尽早建立 AI 素材的版权与标识合规流程。
- 对硬件与云厂商:多模态尤其视频是推理算力的新增量,视频编解码、时空注意力、长序列对显存带宽和专用加速提出新需求,自研 ASIC 和推理优化有明确买单场景。
- 对投资者:警惕「demo 惊艳=能盈利」的错觉,重点看单位成本下降斜率、可商用版权与工作流粘性、是否握有独占数据和分发入口;「世界模型/合成数据外溢」是长期期权而非短期现金流。
结语:从读懂语言到看懂世界
文本让 AI 学会了人类说了什么,多模态则逼着它去看、去听、去理解世界本来的样子——这是一条更贵、更难,却被认为通向更强通用智能的路。视频生成站在这条路最陡峭的一段:它把智能的成本从「一 token」拉到了「一帧像素、一秒运动」,用数量级膨胀的算力和数据,去换模型对物理世界的直觉。短期内,图像和语音会安静地渗透进每一条生产线和每一个入口,视频则继续在惊艳与昂贵之间快速降价;长期看,真正的大奖或许不是又一支炫酷短片,而是一个能模拟世界、从而喂养机器人和自动驾驶的模型。看懂多模态,就看懂了为什么算力军备竞赛远没有到头——当机器开始认真「看世界」,要算的东西才刚刚开始。
数据口径与延伸
- 数据口径:拼接式与原生多模态路线、视频数据高维成本、扩散/自回归视频生成的算力机制、文本<语音<图像<视频的成本梯度、数据+算力+场景的竞争结构、图像/语音已规模化变现而视频仍在降本、视频作为世界模型/合成数据的长期方向,来自前沿实验室公开资料、厂商发布与行业研究的常见口径。具体生成时长、分辨率、成本与产品能力迭代极快,本文统一用结构与量级表述,不引用未核实数字,以官方最新发布为准。数据截止 2026 年中。
- 相关产业观察:训练数据墙(多模态数据矿与稀缺)、推理模型与测试时算力(另一本算力账)、KV Cache 经济性(长序列推理成本)、云三巨头资本开支、云厂自研 ASIC、端侧 AI、人形机器人与具身智能。
- 同批待写延伸:小模型与端侧(F7)、模型评测产业(F8)、机器人芯片与传感器(J3)、AI 制药(J4)。
一句话总结:多模态是模型从「读懂语言」走向「看懂世界」的必经路,原生多模态直接从像素和声音里学习文本无法表达的物理与因果;视频生成因「每秒数十帧×百万像素×逐步去噪」把训练推理成本抬到文本的数量级以上,使行业按「图像语音先赚钱、视频先烧钱」梯次落地,竞争胜负取决于数据、算力、场景三者的乘积并进一步向巨头集中——长期最大的想象空间不是一支短片,而是能产出物理可信画面、为机器人和自动驾驶供给合成数据的「世界模型」。