AI 芯片层枢纽
数据截止 2026-09。返回 AI 产业链总览。 本页是「分层枢纽页(Layer Hub)」样板:把本层每个节点压成一行,统一展示关键技术 / 主要玩家 / 成熟度 / 后续预期,点标题进入深度文。 阅读建议:先看下方矩阵横向比较各节点的身位与预期,再读「逐节点解读」理解格局成因,最后按标题进入感兴趣的深度文。
本层在产业链中的位置
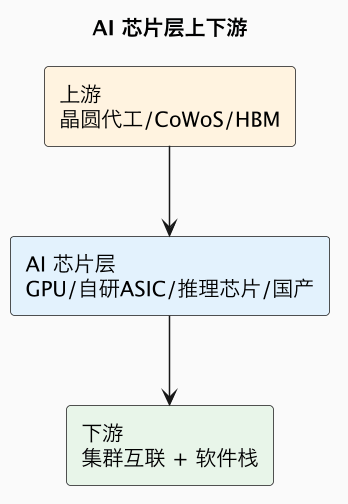
AI 芯片位于「半导体制造与先进封装之上、集群互联与软件栈之下」:封装好的 HBM 与裸片在这里组成算力载体,单卡再经 NVLink/网络连成集群,由 CUDA 与框架激活。它是过去十年价值最集中、也是地缘博弈最激烈的一层。
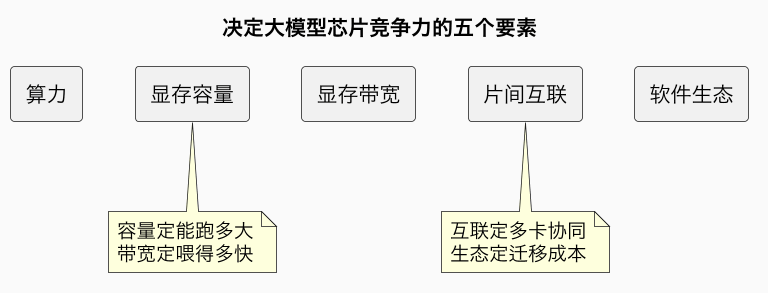
需要先厘清一个常见误解:AI 芯片的性能并不只由「制程几纳米」决定。真正决定一颗大模型芯片竞争力的,是算力、显存容量、显存带宽、片间互联和软件生态五个要素的组合。大模型的权重和 KV Cache 都要放进显存,因此显存容量决定「能跑多大的模型」,带宽决定「喂数据给计算单元有多快」,片间互联决定「多张卡能不能像一张卡一样协同」,而软件生态(CUDA)决定「开发者愿不愿意、能不能低成本地把程序跑起来」。制程影响功耗与频率,但无法单独决定胜负——这也是一些后发者即使拿到同代制程、仍要在带宽、互联和软件上长期补课的原因。
节点矩阵:技术 × 玩家 × 成熟度 × 预期
| 节点(深度文) | 关键技术(TRL) | 主要玩家 | 关键卡点(B-,缓解窗) | 成熟度 | 后续预期(置信度) |
|---|---|---|---|---|---|
| 英伟达 GPU 产品矩阵 | Hopper/Blackwell 架构、Transformer Engine、FP8/FP4(TRL-4) | 英伟达(绝对领先) | B-产能:CoWoS/HBM 配额限交付(18M 缓解,中) | TRL-4 | 6M:B 系列放量(高);18M:下一代 Rubin(中);36M:系统级锁定延续(中) |
| NVLink 整柜战略 | NVLink/NVSwitch、NVL72 整柜、机架即计算机(TRL-4) | 英伟达 | B-生态:整柜锁定与开放总线之争(36M,中) | TRL-4 | 6M:NVL72 成为大单标配(高);18M:开放总线分流(中) |
| CUDA 护城河 | 编程模型、算子库、生态锁定(TRL-5) | 英伟达 vs ROCm/oneAPI | B-生态:迁移成本高,训练侧尤甚(36M 缓慢松动,中) | TRL-5 | 6M:训练侧护城河稳固(高);36M:推理侧被编译器/ASIC 缓慢侵蚀(中) |
| AMD 反攻 | CDNA 架构、大容量 HBM、ROCm(TRL-3~4) | AMD(并跑/追赶) | B-生态:ROCm 成熟度与客户信心(18M 改善,中) | TRL-3 | 6M:MI300 系列上量(中);18M:MI350 抢推理份额(中);36M:份额温和提升(中) |
| 云厂商自研 ASIC | TPU/Trainium/MTIA、内部 workload 定制(TRL-4) | 谷歌/亚马逊/Meta | B-产能:先进制程/封装排期受挤压(18M,中) | TRL-4 | 6M:自研占内部负载比例上升(高);36M:与外采英伟达长期并存(中) |
| 推理芯片新赢家 | 推理专用 ASIC、小芯片、存算一体(TRL-2~3) | 多家创业/云厂 | B-资金 + B-生态:缺大客户绑定、软件栈弱(18M 见分晓,低) | TRL-2~3 | 6M:细分场景卡位(中);18M:性价比窗口期(中);36M:格局未定(低) |
| 国产 AI 芯片盘点 | 昇腾/寒武纪/海光等、制程受限、软件栈补课(TRL-2~3) | 华为/寒武纪/海光/燧原/摩尔线程 | B-监管 + B-生态:制程/HBM/设备受限,生态四关(36M,中) | TRL-2~3 | 6M:管制下国产替代提速(高);18M:本土生态成形(中);36M:两套供应链并存(中) |
逐节点解读
英伟达 GPU:从卖卡到卖系统
英伟达是本层唯一处于「绝对领先」位置的玩家,但它的领先早已不只是单颗芯片。Hopper 与 Blackwell 两代架构的关键,不只是把晶体管堆得更多,而是围绕 Transformer 这类工作负载做了系统级优化:专用的 Transformer Engine、对 FP8/FP4 等低精度格式的支持,以及与 HBM 高带宽显存、NVLink 互联的紧耦合。真正抬高竞争门槛的是「整套系统」——从单卡到 NVL72 整柜,再到上层的 CUDA 软件,客户买到的不是一个零件而是一台开箱即用的算力机器。这种「机架即计算机」的打法,把竞争单位从芯片抬升到系统,让只做单卡的对手很难在大单里正面竞争。
NVLink 与整柜:为什么互联成了主战场
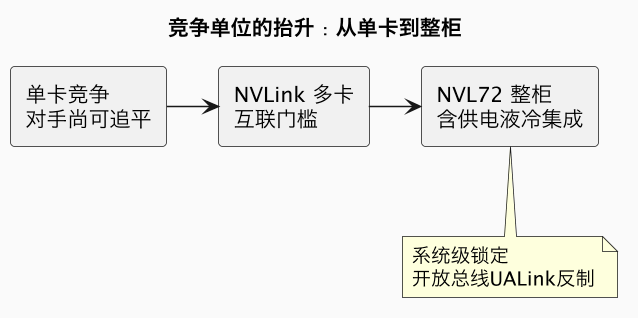
当单卡算力逼近极限,决定大模型训练效率的越来越多是「卡与卡之间能多快交换数据」。NVLink 是英伟达的高速片间互联,NVSwitch 则让几十张卡像一张大卡一样全互联。NVL72 把 72 张卡连同网络、供电、液冷打包成一个整柜交付,客户不必自己做复杂的系统集成。这一战略的深意在于:它把最难、也最容易出错的集群集成环节标准化、私有化,进一步增强锁定。正因如此,行业才推出 UALink 等开放总线试图打破「机柜级垄断」,这是本层未来几年的一个关键博弈点(开放标准的进展见网络层枢纽)。
CUDA:看不见却最难逾越的护城河
如果说硬件还能追赶,CUDA 这套软件生态才是英伟达最深的壁垒。它是一套被全球开发者用了十几年的编程模型,加上海量的算子库、调优经验和现成代码。把一个成熟项目从 CUDA 迁到其他平台,意味着重写、重测、重新踩坑,迁移成本和不确定性都很高。需要注意的是,CUDA 的护城河在不同场景深浅不一:需要极致灵活性和最前沿支持的训练侧几乎离不开它;而负载相对固定、只追求单位 token 成本的推理侧,正被推理引擎、AI 编译器和专用 ASIC 缓慢绕开。这并不意味着 CUDA 会被迅速取代,而是它的不可替代性会随推理规模化而边际下降。
AMD:最现实的第二供应商
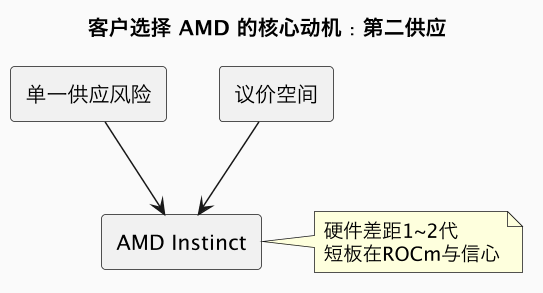
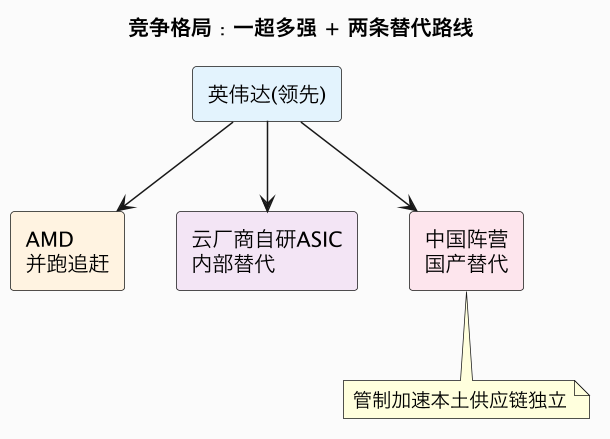
AMD 是英伟达之外唯一能提供完整高端 GPU 产品线的厂商。它的 Instinct 系列走 CDNA 架构路线,常以更大的显存容量作为差异化卖点,软件侧依托 ROCm。AMD 当前的身位是「并跑但仍在追赶」:硬件代际差距已经缩小到一两代,真正的短板仍在软件成熟度和客户信心。对很多客户来说,选择 AMD 的首要动机往往不是它更快,而是「需要一个第二供应商」以降低对单一厂商的依赖、获得议价空间。这使得 AMD 在推理和对生态依赖较低的客户中更容易切入,份额大概率是温和提升而非颠覆式反超。
云厂商自研 ASIC:把固定负载做便宜
谷歌的 TPU 是这一路线的鼻祖,亚马逊的 Trainium、Meta 的 MTIA 紧随其后。它们的共同逻辑是:云厂商内部存在海量且相对固定的负载(搜索、推荐、自家模型推理),用为这些负载量身定制的 ASIC,比用通用 GPU 更省电、更便宜,也更不受外部供货周期和价格的牵制。自研 ASIC 成熟度已相当高,但它不是为了对外取代英伟达,而是优化自身成本结构。前沿训练、需求多变的负载仍会选择通用 GPU;稳定可预测的负载则迁移到自研芯片。两条路线长期并存,自研占内部负载的比例会持续上升。
推理芯片:窗口期里的新玩家
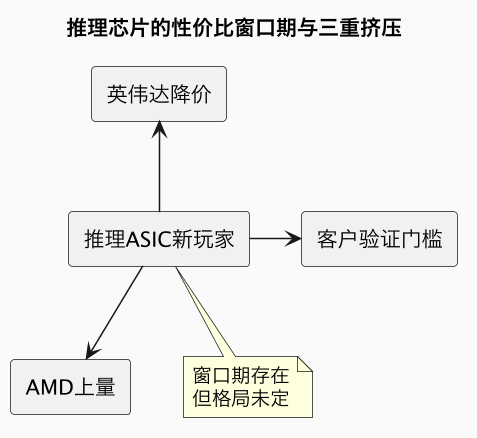
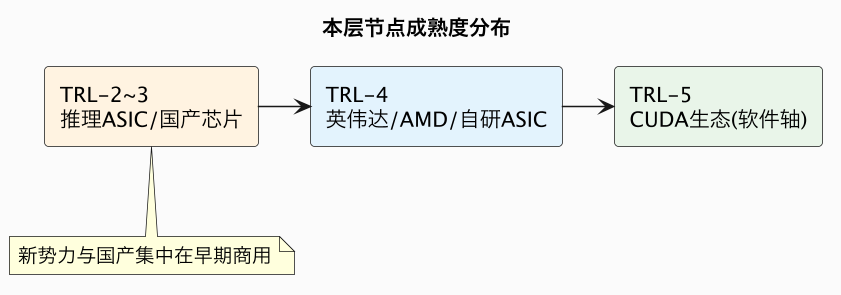
随着行业重心从训练转向大规模推理,一类专门为推理设计的芯片开始涌现,卖点集中在能效和单位 token 成本,技术上常借助小芯片、Chiplet 乃至存算一体等方案降低数据搬运的开销。这是本层成熟度最低、不确定性也最大的节点:大多数公司还处于早期商用,能否跑出来取决于能否拿到稳定的大客户、软件栈是否好用,以及能否在英伟达降价和 AMD 上量的夹缝中保持性价比。可以把它理解为一个「窗口期机会」——推理评价标准的变化打开了缺口,但最终格局远未确定,不宜对任何单一家公司下高置信度判断。
中国阵营:约束在制造,竞争在生态
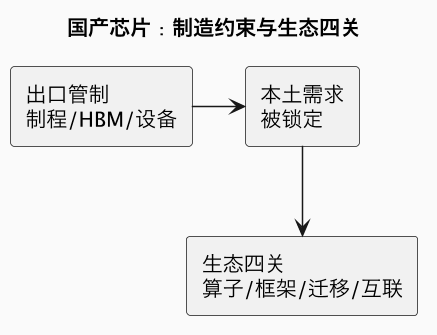
国产 AI 芯片(华为昇腾、寒武纪、海光以及一批新兴公司)面对的核心约束在制造端:先进制程、HBM 和设备都受到出口管制。但管制也客观上为本土产品锁定了需求,国产替代正在加速。当前的主要矛盾已经发生变化——不再是「有没有能用的芯片」,而是「软件栈和生态能不能支撑规模化使用」:算子是否完备、与主流框架适配得好不好、客户迁移成本高不高、集群互联稳不稳,这些决定了渗透速度。最可能的中期结果是两套并行的供应链与生态体系,各自在本土市场内完成迭代,而不是重新收敛为一套全球统一体系。
| 等级 | 含义 |
|---|---|
| TRL-1 | R&D 实验 |
| TRL-2 | 工程验证 |
| TRL-3 | 早期商用 |
| TRL-4 | 规模商用 |
| TRL-5 | 成熟红海 |
预期统一按 6 / 18 / 36 个月三档,置信度 高 / 中 / 低。完整标尺见 AI 产业链总览。
本层的三条判断主线
第一,训练与推理是两本账,芯片格局也因此分化。 训练侧追求极致的互联带宽、大规模并行和长时间稳定运行,生态门槛最高,英伟达的 CUDA + NVLink 组合在这一侧护城河最深;推理侧的 workload 更注重单位 token 成本、延迟和能效,对最尖端互联的依赖相对较弱,这给 AMD、云厂商自研 ASIC 和专用推理芯片留出了更现实的切入点。这也是为什么「推理时代会换一批赢家」成为被反复讨论的命题——不是说英伟达会输,而是推理市场的评价标准更偏向性价比,后来者的机会窗口比训练侧大。
第二,自研 ASIC 不是要取代外采,而是优化内部成本结构。 谷歌、亚马逊、Meta 自研芯片的核心逻辑,是把自己庞大且相对固定的内部负载(搜索推荐、内部模型推理)用定制硬件做得更便宜、更不受外部供货节奏制约。自研与外采英伟达会长期并存:前沿训练和需要灵活性的负载仍倾向通用 GPU,稳定、可预测的内部负载则迁移到自研 ASIC。
第三,中国阵营的核心约束在制造端,但替代正在本土生态内加速。 出口管制把先进 GPU、HBM、制造设备和 EDA 都纳入限制,客观上迫使中国市场转向本土方案。国产芯片当前的主要矛盾已从「有没有能用的算力」逐渐转向「软件栈和生态好不好用、能不能规模用」——算子完备度、框架适配、迁移成本和集群互联是决定渗透速度的关键。大概率的中期结果不是一套全球统一供应链,而是两套并行的技术与生态体系,在各自市场内完成迭代。
还需要补充一点关于「价格」的判断,因为它正成为本层竞争的核心变量。过去 GPU 严重供不应求,定价权完全在卖方;随着 Blackwell 大量交付、AMD 上量、自研 ASIC 分流以及推理需求转向性价比,市场正在从「抢得到」转向「算得清」。客户越来越习惯用每百万 token 的推理成本、每瓦算力这样的单位经济学指标来比较方案,而不是只看峰值算力。这一变化对后来者整体有利:当评价标准从「谁最先进」变成「谁最划算」,多条技术路线就有了各自的生存空间。但反过来,一旦英伟达凭借规模和整柜优势主动打价格战,单靠「便宜」立足、没有大客户绑定的新玩家也最容易被挤出。因此判断这一层的胜负,不能只看技术参数,更要看成本曲线、客户结构和生态锁定三者的叠加。
本层补完节点(2026-09-28 成稿)
原先的四个缺口节点已全部成稿,可按下表继续深入:
| 节点 | 深度文 | 一句话角度 |
|---|---|---|
| 光计算 / 硅光算力芯片 | 光计算芯片 | 用光子做矩阵乘法的算力路线,与硅光互连(CPO)划清界限 |
| CPU 在 AI 推理与编排中的角色 | CPU 的 AI 角色 | GPU 背后的总调度,小模型与推荐场景 CPU-only 推理仍经济 |
| AI 板卡 / 模组 | AI 加速卡与模组 | PCIe 卡 / OAM / SXM 三形态,芯片变算力的中间层 |
| 国产与新兴玩家专篇 | 国产 AI 芯片创业公司深读 | 第二梯队商业化深水区:IPO、收入结构与生态差距 |
整机 ODM 环节已有专篇 服务器 ODM 格局;更长远期排期见内部 roadmap
private/ops/ai-industry-roadmap.md。
总结
AI 芯片竞争力由算力、显存容量、显存带宽、片间互联和软件生态五要素组合决定,而非只看制程;训练侧 CUDA+NVLink 护城河最深,推理转向单位 token 成本/每瓦算力的性价比评价,给 AMD、云厂自研 ASIC(为优化内部成本、非取代外采)和推理芯片打开窗口,国产阵营约束在制造端、竞争在生态,中期大概率是两套并行供应链。