GPU Kernel 工程师
先说结论
- 算力的“最后一公里”是人:模型算子最终要变成在成千上万个核心上并行执行的 Kernel,写得好不好,性能可能差数倍甚至数十倍。
- 门槛高、供给少、需求多方争抢:既要懂并行计算和体系结构,又要懂显存层级与硬件细节,成长靠大量实战,培养周期长;模型公司、云厂、芯片/软件栈厂都在抢。
- 分工清晰:算法工程师定义“算什么”,编译器工程师做“自动优化与生成”,Kernel 工程师负责“对关键热点手写极致实现 + 与硬件对齐”。
- Triton 等高层语言降低门槛但不消灭专家:常见算子可用高层语言快速写,但极致性能、新硬件特性和复杂融合仍需底层专家。
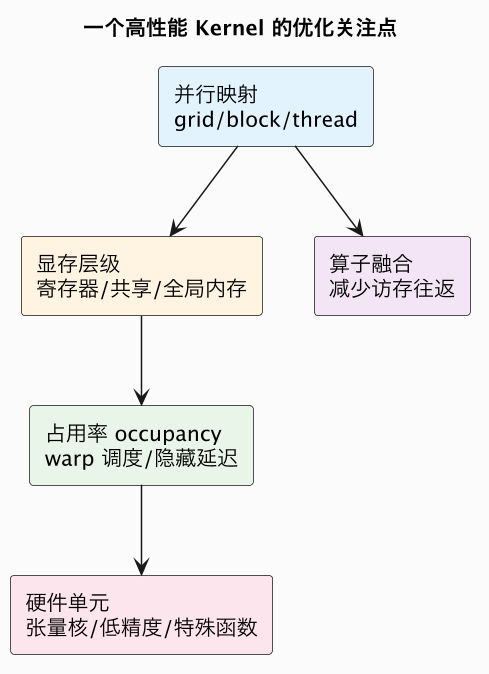
一、Kernel 工程师到底优化什么
| 关注点 | 核心问题 |
|---|---|
| 并行分解 | 线程块/网格怎么映射到数据,负载是否均衡 |
| 内存访问 | 是否合并访问(coalesced)、共享内存复用、减少全局访存 |
| 占用率 | 活跃 warp 是否足够隐藏访存延迟 |
| 数据类型 | 是否用 FP8/FP16/张量核,而非高价高精度 |
| 融合 | 把多个算子合成一个 Kernel,省掉中间结果回写显存 |
| 同步/竞争 | bank conflict、原子操作、死锁与竞态 |
二、为什么“越上层繁荣,底层越缺”
- 模型与应用爆发 → 新算子、新数据格式、新芯片层出不穷 → 对底层优化的需求上升;
- 但底层人才培养慢、难度高,无法随资本快速扩张;
- 芯片厂商要为新硬件写库、云厂要压推理 TCO、模型厂要做训练/推理加速,需求高度叠加,溢价显著。
三、三类工程师的分工
| 角色 | 关心 | 产出 |
|---|---|---|
| AI 算法/模型工程师 | 模型结构、训练、效果 | 模型与训练逻辑 |
| 编译器工程师 | 图优化、自动代码生成、跨硬件 | 编译器/后端、通用加速 |
| GPU Kernel 工程师 | 热点算子手写极致实现 | 高性能算子库/融合 kernel |
三者协作:编译器覆盖“面”的自动优化,Kernel 专家解决“点”的极限性能。
四、能力如何形成
- 扎实的计算机体系结构与并行计算基础;
- 对显存层级、指令调度、硬件代际差异的直觉;
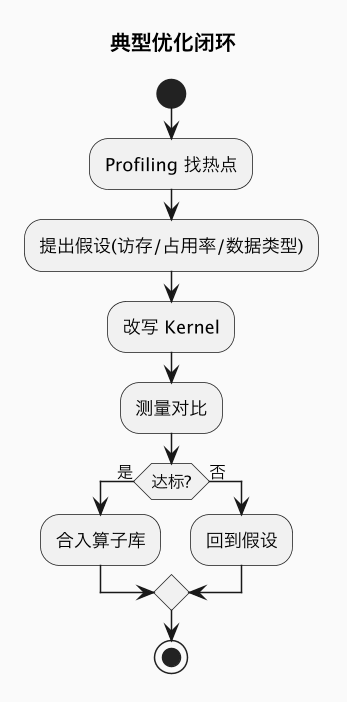
- 大量 profiling(用工具定位瓶颈,而非凭感觉)与反复实验;
- 能读懂硬件文档、跟得上新架构(新张量核、新互联、新数据类型)。
这种“经验+手感”难速成,是岗位溢价的根本原因。
五、Triton / 编译器会取代他们吗
- 会改变工作内容,不会消灭需求:高层 DSL 让普通融合算子写得更快,专家从“手写大量样板”中解放;
- 但逼近硬件极限、调试复杂性能问题、为全新芯片设计算子、处理特殊内存层级仍需底层专家;
- 编译器生成代码与手写极致实现之间,在关键热点上仍可能有差距;
- 趋势是“编译器普及中层、专家集中在最高价值难点”。
六、对个人与产业的建议
- 个人:算法背景者补体系结构与 CUDA 实战,可获得稀缺溢价;避免只停留在调框架 API;
- 企业:把底层性能视为成本与产品竞争力,建设 profiling 文化,别让“模型能跑”掩盖“跑不满”;
- 芯片/云厂:算子库与开发者体验是硬件被采用的前提,Kernel 人才是关键投入。
七、深度专题:为什么“跑满一颗 GPU”这么难
Kernel 工程师的稀缺性,根源在于这件事本身的难度反直觉:硬件峰值算力极高,但把它变成真实 MFU 需要跨越一长串层层嵌套的约束。 这里把这些约束从硬件底层向上逐层拆开。
1. GPU 是“海量简单核心”的机器
与 CPU 少量强核不同,GPU 用成千上万个相对简单的核心追求高吞吐,其性能模型围绕“大量线程、隐藏延迟”构建:
- 线程以 warp(一组锁定步进的线程)为调度单位;
- 当一组 warp 因访存等待时,调度器立即切换到另一组就绪 warp,用并行度“盖住”延迟;
- 因此性能高度依赖是否有足够多随时可跑的 warp(occupancy)。
2. 内存层级:快慢差几个数量级
GPU 的内存从快到慢分层极陡:寄存器 → 共享内存/L1 → L2 → 全局显存(HBM)。相邻层带宽和延迟可差一个数量级以上。绝大多数 Kernel 的性能瓶颈不是算力,而是数据搬运:
- 全局访问是否被相邻线程合并(coalesced);
- 是否把重复使用的数据放进共享内存复用;
- 是否有 bank conflict 让共享内存访问串行化;
- 是否用算子融合,避免把中间结果写回全局显存又读回。
3. 占用率与硬件单元的精细匹配
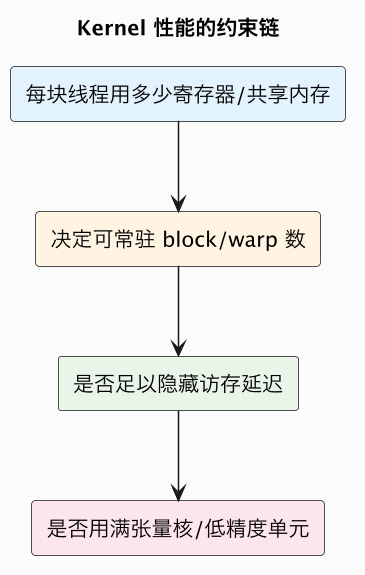
- 寄存器/共享内存用得太多 → 能常驻的 warp 减少 → 占用率下降 → 无法隐藏延迟;
- 但盲目压低资源占用又可能限制每线程计算效率,需要精细平衡;
- 张量核要求特定数据布局/形状对齐,矩阵分块若不匹配,即使低精度也喂不饱专用单元。
4. 为什么经验无法速成
这些约束相互耦合、且随硬件代际变化(新的张量核、新内存容量、新互联、新数据类型),没有一个通用公式。一个优化在旧架构成立、在新架构可能反效果。专家的价值正是建立在“profiling + 跨代硬件直觉 + 大量试错”之上,这也是岗位无法靠短期培训规模化产出的根本原因。
八、需求结构:为什么底层岗位会“越来越缺”
AI 越繁荣,大众直觉以为“框架越强大、越不需要底层人才”,但现实相反,原因在于需求结构的变化:
| 需求来源 | 为什么需要 Kernel 人才 |
|---|---|
| 前沿模型公司 | 新算子/注意力变体、训练推理极致加速 |
| 云与 MaaS | 压低每 token 推理 TCO,直接影响毛利 |
| 芯片厂商 | 新硬件必须配套高性能算子库才能被采用 |
| 开源/框架生态 | 热点算子融合、后端代码生成质量 |
| 垂直行业 | 定制算子、特殊数据类型与实时性 |
这些需求在 AI 爆发后同时上升,而人才供给受学习周期刚性约束,于是形成长期卖方市场:底层工程师往往同时被多家高薪争抢,且他们的产出(性能几个百分点)在超大规模下对应金额极大,企业愿意为之支付高溢价。
九、Triton/编译器与 Kernel 工程师的未来分工
一个常见疑问是:Triton 这类高层 DSL 和 AI 编译器越来越强,会不会让手写 Kernel 的人失业?答案是工作内容上移而非需求消失。
- 被自动化的部分:规则化的融合算子、标准矩阵/归约等,开发者用 Triton 几十行就能获得不错性能,无需手写大量样板和寄存器分配;
- 仍需专家的部分:逼近硬件极限的热点、跨内存层级的复杂调度、为全新芯片设计/调试算子、定位反直觉的性能问题、以及编译器本身的构建;
- 新的协作结构:编译器/DSL 覆盖“面”的 80~90%,Kernel 专家集中在“点”的最高价值 10%,并参与构建让普通开发者受益的工具链。
对个人的启示:最优策略不是“只学上层 API”,也不是“只钻裸 CUDA”,而是上下打通——理解模型与算法需求,又能下沉到体系结构和 profiling,在工具与硬件之间自由切换,这种复合度才是未来最稀缺的位置。
十、一次真实优化的推演:从现象到根因
为了把能力讲具体,这里用一个示意案例还原 Kernel 工程师如何定位问题(数字为示意,重点是方法论)。
现象
某注意力相关 Kernel 在新 GPU 上理论应更快,但实测吞吐只达预期的一半,GPU 利用率却显示很高。
排查路径
- 先 profiling,不猜:发现计算单元占用不低,但内存吞吐接近上限,且存在大量非合并访问;
- 定位访存模式:线程对全局显存的读取未对齐,相邻线程访问了不连续地址,导致多次内存事务;
- 检查融合与中间张量:两个相邻算子各自把中间结果写回显存又读回,产生冗余往返;
- 看占用率与张量核:寄存器占用过高压低了常驻 warp,且矩阵分块形状未匹配张量核,专用单元没喂满。
优化动作与验证
- 重排数据布局让访存合并、用共享内存复用;
- 融合两算子消除中间张量;
- 调整分块与寄存器使用提升占用率、对齐张量核;
- 每次只改一项并测量,最终吞吐显著提升。
这个过程说明:瓶颈常反直觉、且多为数据搬运而非算力,专家的核心技能是用工具把黑盒拆成可验证的假设,而非“写更快的代码”这种模糊目标。
十一、跨硬件移植:为什么换芯片是硬工程
Kernel 与具体硬件强绑定,当模型要跑在不同厂商的 GPU/加速器上时,CUDA Kernel 不能直接复用,这正是软件护城河与人才需求的交汇点。
| 移植路径 | 方式 | 代价 |
|---|---|---|
| 直接移植 | 用目标硬件底层语言重写 | 成本最高、需对应专家 |
| 编译器/中间层 | 经 MLIR/Vulkan/厂商编译 | 性能或有差距、需调优 |
| 高层 DSL | Triton 等多后端 | 覆盖面有限 |
- 对芯片新进入者:算子库成熟度与移植成本直接决定能不能被客户采用,因此都要养或挖一批底层人才;
- 对模型公司:多硬件策略意味着持续的算子适配与验证投入;
- 对个人:能在“一套算法需求 ↔ 多种硬件后端”之间做性能移植与权衡,是极难被替代的能力。
Kernel 人才因此不仅服务英伟达生态,也在国产与多供应商硬件崛起中获得更大舞台——硬件越多元,对“能把不同芯片都跑满”的底层工程师的需求越旺盛。
十二、给读者的判断框架
- 判断性能问题,永远先 profiling,瓶颈多在数据搬运而非算力。
- 看待职业价值,理解“面(编译器/DSL)+ 点(专家极限优化)”的分工,最稀缺的是上下打通的复合能力。
- 评估人才需求,记住硬件越多元、规模越大,底层优化的需求越旺盛而非消失。
- 做职业规划,在“算法需求 ↔ 体系结构 ↔ 多种硬件后端”之间建立迁移与权衡能力,最难被替代。
GPU Kernel 工程师是 AI 算力红利里少有的“硬手艺”岗位:其稀缺由门槛、培养周期和多方刚性需求共同决定,工具进步会改变其工作形态、抬高行业平均水平,但把不同芯片真正“跑满”的底层专家,仍将长期处于价值链的高端。
常见误区
- 认为会调 PyTorch 就等于懂 GPU 性能:底层是另一套能力体系。
- 以为高层语言让底层专家失业:难点上移而非消失。
- 只看峰值算力不看 kernel 实际效率:真实 MFU 由软件决定。
- 凭直觉优化而不 profiling:多数性能瓶颈反直觉。
- 忽视多代硬件差异:一个优化不能通吃所有架构。
总结
GPU Kernel 工程师是把硬件峰值变成真实算力的关键一环,围绕并行映射、显存层级、占用率、张量核与算子融合做极致优化;因培养慢、门槛高且被模型/云/芯片多方争抢而长期稀缺。Triton 与 AI 编译器会承担大量通用工作、抬高行业平均水平,但最硬的性能与新硬件适配仍离不开底层专家,岗位价值会向更高难点集中而非消失。