InfiniBand 与以太网:AI 集群网络的两条路之争
最后更新:2026-09-19|数据截止 2026 年中:网络代际与产品以官方发布为准,本文讲技术与产业逻辑,不引用未经证实的份额数字。
本文是产业观察,回答:为什么万卡集群里,网络跟 GPU 一样重要,以及英伟达的 InfiniBand 和开放以太网之间这场仗怎么打。 万卡集群组网 讲了 Scale-Up 与 Scale-Out、胖树与 Rail 优化,光模块篇 讲了带宽怎么在光纤上跑;本文聚焦 Scale-Out 后端网络的两条技术路线之争:InfiniBand 对阵 RoCE/超以太网。
先说结论
- AI 训练对网络的要求是「又快、又不丢、规模还大」。 集合通信让网络反复成为瓶颈,任何丢包、拥塞都会拖垮上万张卡的整体利用率,因此后端网络普遍采用 RDMA(远程直接内存访问,绕过 CPU 搬数据)的低延迟无损技术。
- InfiniBand 赢在开箱即用、性能与规模,以太网赢在开放、成本与供应链。 IB 是为高性能互联设计的专有体系,调优简单、成熟;以太网(RoCE,基于聚合以太网的 RDMA)生态庞大、厂商多元、成本更优,但要靠无损配置和高级拥塞控制才能追平。
- 英伟达是这场仗的「两面庄家」。 它既靠收购 Mellanox 掌握 InfiniBand,又推出 Spectrum-X 高端以太网进攻超大规模客户;无论哪条路赢,它都卖网卡、交换机和光模块。
- 超大规模厂是开放以太网的主要推手。 出于反锁定、成本和自有网络能力,它们推动 RoCE 与超以太网联盟(UEC)成熟,让以太网在 AI 集群中持续抢份额。
一句话:这是一场「省心的专有高性能」与「开放多元的规模成本」之争——InfiniBand 在最吃紧的训练网络里仍是标杆,但以太网正靠 RoCE/Spectrum-X/超以太网快速逼近;英伟达两边下注,真正的变量是超大客户愿不愿意把网络命运掌握在自己手里。
一、为什么 AI 集群的网络这么难
大模型训练不是各卡各算,而是频繁同步梯度与中间状态(集合通信,如 All-Reduce)。在 万卡集群组网 中我们讲过:网络慢、有拥塞或丢包,GPU 就得空等,集群规模越大,等的代价越高,通信占比甚至成为决定有效算力(MFU)的关键。
AI 后端网络因此要同时满足三件普通数据中心网络不必极致追求的事:
- 极低延迟:RDMA 让一台机器直接读写另一台机器的内存,绕过操作系统和 CPU,减少拷贝与中断。
- 零/低丢包(无损网络):RDMA 对丢包极敏感,少量丢包就会大幅降速,需要 PFC(基于优先级的流控)、ECN(显式拥塞通知)等机制构造「无损以太」。
- 超大规模无阻塞:上万端点做无阻塞胖树,要求交换机、链路、路由和拥塞控制在大尺度下依然稳定。
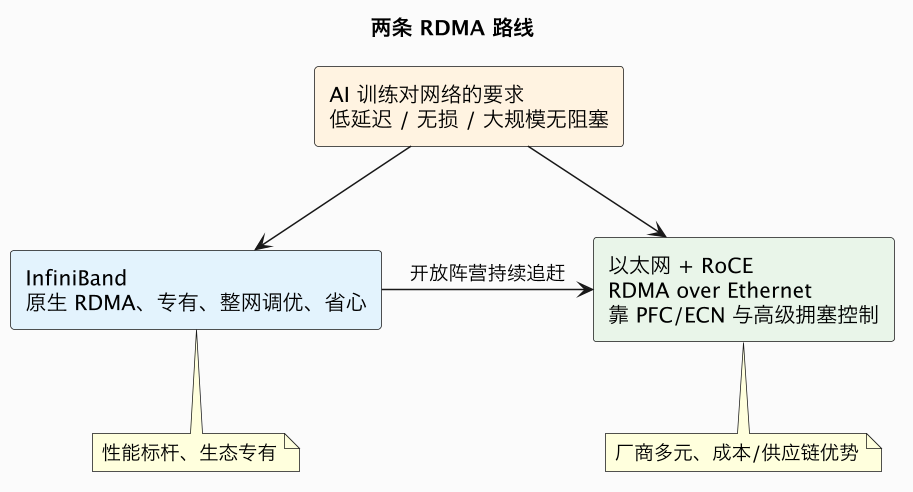
InfiniBand 与以太网(RoCE)是满足这些要求的两条路线。它们都承载 RDMA,区别在网络体系、生态归属和「要自己做多少调优」。
二、InfiniBand:省心的高性能标杆
InfiniBand 是专门为高性能计算和存储互联设计的网络体系,天然支持 RDMA,自带集中管理(子网管理器 Subnet Manager)、信用机制和在网计算(如 SHARP,在交换机里做归约)等特性。它的优势是整网一致性和开箱即用:从网卡(HCA)、交换机到软件栈由英伟达一体提供,配置和调优路径清晰,大规模训练下性能与稳定性经过长期验证。
代价也明确:
- 专有生态、供应商集中:英伟达(收购 Mellanox 后)是绝对主导,客户面临与 GPU 同源的锁定;
- 成本与采购:相比海量通用以太网,IB 设备与光模块通常更贵,供应链选择少;
- 与数据中心既有网络两套体系:运维、人员技能和备件要另起一套。
因此在最前沿、最吃网络性能的大规模训练里,IB 长期是默认标杆;但越往下走、规模越大、对成本和自主越敏感,开放以太网的吸引力越强。
三、以太网反攻:RoCE、Spectrum-X 与超以太网
以太网是数据中心的绝对主流,体量巨大、厂商众多、成本和供应链优势明显。让它承载 AI 的关键是 RoCE(RDMA over Converged Ethernet)——在以太网上跑 RDMA。早期 RoCE 需要复杂的无损配置,大规模下 PFC 死锁、拥塞扩散等问题让它在最难的训练场景里落后于 IB;但近年三件事改变了格局:
- 高级拥塞控制:新一代拥塞控制算法(基于时序/遥测、逐包负载均衡等)大幅提升大规模 RoCE 的稳定性与有效带宽,降低对 PFC 的依赖。
- 英伟达 Spectrum-X:英伟达亲自下场做「AI 优化以太网」,用高端网卡(BlueField)、交换机和拥塞控制把以太网性能拉到接近 IB,去抢偏爱开放以太的超大规模客户——这是它「IB + 以太两边下注」的战略。
- 超以太网联盟(UEC):博通、AMD、Arista、思科、英特尔及多家云厂等推动 Ultra Ethernet,针对 AI 集合通信改进传输、多点到多点、拥塞响应和在网功能,目标是提供开放、多供应商、性能对标甚至超越 IB 的下一代以太网。
以太网阵营的核心诉求与云厂自研 ASIC 完全一致(见 云厂自研 ASIC):不被单一供应商锁定、利用庞大供应链压成本、把网络核心能力握在自己手里。 超大规模厂有足够强的网络工程团队,能驾驭 RoCE 的调优复杂度,因此成为以太网反攻最坚定的推手。
| 维度 | InfiniBand | RoCE / 超以太网 |
|---|---|---|
| 性能与规模 | 标杆、开箱即用 | 快速逼近,依赖调优/新协议 |
| 生态归属 | 专有,英伟达主导 | 开放,多供应商 |
| 成本/供应链 | 较高、选择少 | 体量大、成本优 |
| 运维 | 独立体系 | 可复用现有以太团队 |
| 主要采用 | 前沿训练、求稳 | 超大规模、推理、成本敏感集群 |
四、Scale-Up 与 Scale-Out 要分开看
一个常被忽略的点:这两条路线之争主要发生在 Scale-Out(节点/机柜之间)后端网络;机柜内的 Scale-Up 域是另一个战场。
- Scale-Up(GPU 之间紧耦合、共享显存语义):英伟达靠 NVLink/NVSwitch 私有高带宽互连领先,开放阵营推 UALink 对抗(规划 D8),这部分更专有、带宽密度更高。
- Scale-Out(把多个 Scale-Up 域连成大集群):才是 InfiniBand 与以太网交锋的地方,跑的是 800G/1.6T 光模块和大规模胖树(见 光模块篇、组网拓扑)。
判断网络格局时把两层分清很重要:英伟达在 Scale-Up 的 NVLink 护城河比在 Scale-Out 的 IB 更深,而 UEC/UALink 分别针对这两层发起开放化攻势。Scale-Out 以太网化的进度会快于 Scale-Up,因为后者对带宽、延迟和软件一致性的要求更极致。
五、变量与置信度判断
| 变量 | 作用方向 | 时间窗 | 置信度 |
|---|---|---|---|
| 超大规模厂偏好开放以太 | 以太网抢份额 | 已发生 | 高 |
| UEC 标准与产品成熟 | 性能对标 IB | 2~5 年 | 中高 |
| Spectrum-X 放量 | 英伟达守住以太高端 | 已发生 | 高 |
| 高级拥塞控制普及 | 缩小 RoCE 与 IB 差距 | 1~3 年 | 高 |
| Scale-Up 开放(UALink) | 削弱 NVLink 锁定 | 3~5 年 | 中 |
- 未来 1~3 年(高置信度):InfiniBand 仍是最前沿、求稳训练集群的标杆,但 RoCE/Spectrum-X 在超大规模和推理集群快速放量,以太网在 AI 后端网络的份额持续上升。
- 未来 3~5 年(中高置信度):超以太网(UEC)标准与多供应商生态成熟,Scale-Out 层以太网成为多数大规模集群的默认选择,IB 退守最高性能/省心场景。
- 长期(中置信度):网络层整体走向开放多供应商,但英伟达凭 Spectrum-X、网卡和光模块仍能在以太生态里收钱;Scale-Up 的 NVLink 护城河更难被快速替代。
六、对不同角色,这意味着什么
- 对建集群的云厂/大模型公司:求稳、团队小可选 IB;有强网络团队、追求成本与反锁定,RoCE/Spectrum-X/超以太网越来越可行;决策要把 Scale-Up 与 Scale-Out 分开。
- 对网络设备商:开放以太网(交换机/网卡/DPC/光模块)受益于去专有化,但要能驾驭大规模拥塞控制才有高端门票。
- 对英伟达:IB 是利润高地,Spectrum-X 是「即使客户选以太也选我」的对冲,关键是别让开放网卡/交换机蚕食太多。
- 对运维团队:AI 网络(RDMA、无损、遥测、拥塞调优)成为稀缺技能,以太网背景的团队迁移路径更顺。
延伸观察:网络为什么成为 AI 集群的「第二张算力账单」
在评估 AI 基础设施成本时,很多人只盯着 GPU 单价,但在大规模训练集群里,网络正在变成仅次于算力的第二张账单,且增长速度更快。原因有三:第一,Scale-Out 要做到无阻塞胖树,越往上层,交换芯片、光模块和端口的数量越多,一个数万卡集群的网络设备与光互连成本可达两位数百分比甚至更高;第二,800G/1.6T 代际跃迁让单个光模块价值量大增(见 800G/1.6T 光模块),高速端口和光器件在整机成本中的占比持续抬升;第三,为追求有效算力利用率,集群普遍做超额订阅比很低的「贵网络」设计,宁可网络过供,也不让 GPU 因通信空等——网络多花的钱,要用省下的昂贵 GPU 空转时间来证明合理。
这就引出一个关键的工程经济学判断:网络是「投资」,不是「成本」。在万卡集群中,网络利用率和拥塞造成的有效算力损失,乘以数千张顶级 GPU 的小时成本,往往远超网络设备本身的溢价。一个调优良好的低拥塞网络,哪怕多花百分之十几的设备钱,只要把模型浮点利用率(MFU)提升几个百分点,就能在经济上跑赢。这解释了为什么最前沿的训练集群愿意为 InfiniBand 或高端以太网支付溢价——它们买的不是带宽参数,而是「数千张卡不空等」的确定性。
但网络账单也在催生成本结构的博弈。当 InfiniBand 的专有溢价过高,超大规模厂有强动力把内部工程能力投向 RoCE/超以太网,用更便宜、供应链更多元的以太网替代;英伟达的应对是 Spectrum-X,让客户即使选以太网也继续买它的网卡和交换机。对客户而言,真实的决策不是「IB 还是以太」的信仰之争,而是一道综合题:自有网络团队的能力有多强、集群规模有多大、对风险的容忍度如何、以及把网络运维内部化能省多少溢价。团队强、规模大、风险偏好高的超大厂倾向自建开放以太;中小客户和求稳的前沿实验室倾向开箱即用的专有方案。
网络还与电力和散热发生联动。高速光模块功耗显著,单模块随速率上升,集群中数以万计的光模块和交换芯片本身构成可观的用电与发热负荷,这让网络设备也成为供电和液冷设计的一部分(见 液冷产业图谱)。可插拔光模块向共封装光学(CPO)的演进,某种程度上也是为了在更高速率下控制功耗和信号完整性。于是「网络选型」不再孤立——它与机柜功率密度、供电架构、光纤/铜缆选择、机房制冷相互耦合,是一道系统级优化题。
对产业格局而言,网络是少数英伟达无法只靠 GPU 优势自动赢下的战场。以太网生态有庞大的交换机、网卡、芯片和运维力量,开放标准有买方强力推动,这使得 Scale-Out 层的长期格局比 Scale-Up 更分散。英伟达能靠 Spectrum-X 和网卡守住高端利润,但很难在以太网世界复制 InfiniBand 式的绝对主导。对建集群的人来说,这其实是好消息:网络层的多供应商竞争,是整个 AI 基础设施里少数能有效对冲「单一供应商风险」的环节,值得在架构设计早期就当作战略变量,而非等采购时才考虑的配件。
从技术演进细节看,以太网反攻能否成功,很大程度取决于拥塞控制这一个「看不见的战场」。RoCE 的传统痛点来自无损以太网对 PFC 的依赖:PFC 通过暂停发送来避免缓存溢出,但配置不当会引发拥塞反压扩散、PFC 死锁和不公平吞吐,在万卡规模下任何一个热点都可能波及大量链路。新一代方案用更精细的遥测和拥塞算法,尽量减少对逐跳暂停的依赖,转向端到端、基于精确时延或负载信息的快速调速,配合逐包喷流(packet spraying)和自适应路由,把流量均匀打散到所有可用路径,从而在同样的物理链路上榨出更高有效带宽。这些机制不性感,却决定了 RoCE 能否在最难的训练场景提供接近 InfiniBand 的尾延迟和有效吞吐——以太网阵营的真正进度,应该看这些底层算法在超大规模生产网络里的稳定性,而不是端口速率参数。
另一个值得关注的变量是共封装光学(CPO)和高速传输对网络架构的牵引。随着速率从 800G 迈向 1.6T 乃至更高,可插拔光模块在功耗和信号完整性上的压力越来越大,CPO 把光引擎移近交换芯片,被视为降低功耗和损耗的方向之一(见 光模块篇)。无论 InfiniBand 还是以太网都要面对同样的物理层挑战,这部分技术是相对中立的——真正的竞争更多发生在上层协议和生态。值得注意的是,网络速率和组网方式还与芯片侧的 Scale-Up 设计相互影响:机柜内域越大、对柜间带宽的需求模式就越特殊,超以太网也在针对 AI 集合通信(多对多、incast、在网归约)重新设计传输语义,而不只是把传统以太网跑快。这说明「以太 vs IB」不是静态的二选一,开放阵营在为 AI 重塑以太网本身。
对实际决策者,可以给出一个去神秘化的选型框架:不要问「哪个技术更先进」,而要问四个落地问题——第一,团队是否有能力驾驭大规模 RoCE 的调优和故障排查,还是更需要厂商一体负责的省心方案;第二,集群主要负载是最吃网络的前沿训练,还是推理和中等规模训练,后者对网络极限的要求宽松得多;第三,供应商锁定和成本在采购权重中占多大比重,是否愿意用早期集成成本换取长期多供应商灵活性;第四,未来是否计划混用多代、多厂商加速器,开放以太网在异构环境里的中立性更有价值。按这个框架,答案往往不是非此即彼,而是分层:最前沿、最求稳的训练域用最成熟的高性能方案,大规模推理和成本敏感域用开放以太网,并用统一的运维和可观测体系把两者管理起来。网络竞争的终局,大概率不是谁彻底消灭谁,而是开放标准在规模和成本驱动下持续抬高水位、专有方案退守最高性能和最强整合的细分市场。
结语:省心的专有,还是开放的规模
InfiniBand 与以太网之争,本质是两种哲学之争:前者用专有一体的体系换开箱即用的极致性能与省心,后者用开放多供应商的庞大生态换成本、规模与自主。AI 让网络成为与 GPU 同等重要的瓶颈,也把这场原本只在 HPC 圈的争论推到所有大模型公司面前。趋势正在向开放以太网倾斜——超大规模厂不愿把网络命运和 GPU 一起交给同一家公司,RoCE 的拥塞控制、英伟达自己的 Spectrum-X 和 UEC 超以太网正在填平性能差距。但在最吃紧的前沿训练、以及更深的 Scale-Up 互连层,专有方案的护城河还会存在很多年。网络的开放化,和云厂自研芯片是同一场反锁定运动的两条战线。
数据口径与延伸
- 数据口径:RDMA/RoCE、InfiniBand 特性、无损网络机制(PFC/ECN)、Spectrum-X 与超以太网联盟方向、Scale-Up/Scale-Out 区分,来自公开技术资料、标准组织与厂商发布。具体份额、代际产品以官方为准,本文不引用未经证实的数字。数据截止 2026 年中。
- 相关产业观察:万卡集群组网、800G/1.6T 光模块、云厂自研 ASIC、英伟达产品矩阵。
- 同批待写延伸:UALink(D8)、网络交换芯片国产化(D5)、DCI 光网络(D6)。
一句话总结:AI 训练的集合通信要求后端网络同时做到 RDMA 级低延迟、几乎无丢包和万卡级无阻塞,满足方式分成两派——InfiniBand 原生支持 RDMA、由英伟达一体提供、开箱即用且规模性能久经验证,是前沿训练的标杆,但专有、昂贵、供应链单一;以太网则借 RoCE 在以太网上跑 RDMA,凭借庞大生态、多供应商和成本优势反攻,过去受制于无损配置和大规模拥塞,近年靠高级拥塞控制、英伟达自己的 Spectrum-X 高端以太网和超以太网联盟 UEC 把性能快速拉到对标 IB;超大规模云厂出于与自研芯片同样的反锁定和降本逻辑,成为以太网最坚定推手;要注意这场仗主要发生在 Scale-Out 机柜间层,机柜内 Scale-Up 仍是 NVLink 更深的专有护城河(开放阵营以 UALink 回应)——因此趋势是 Scale-Out 加速以太网化、IB 退守最高性能省心场景,而英伟达通过同时掌握 IB 和 Spectrum-X 两边下注。