RAG 的地基:向量数据库、向量检索与 GraphRAG 的数据基础设施
数据截止 2026-09。承接企业 AI:PoC 到生产鸿沟、垂直 SaaS 的 AI 化、合成数据产业。
要让大模型基于企业私有知识回答、还不“一本正经地胡说”,业界主流方案是 RAG(Retrieval-Augmented Generation,检索增强生成):先从知识库里捞出相关材料,再让模型“看着材料作答”。很多人以为 RAG 的主角是大模型,实际工程经验恰恰相反——答案质量的上限,大半由“检索得准不准”决定。支撑检索的向量数据库、向量索引,以及补足关系推理的知识图谱(GraphRAG),构成了 AI 落地里需求最刚、竞争也最激烈的数据基础设施之一。
先说结论
- RAG 的质量瓶颈在检索而非生成:捞不到、捞不准、切块不当,再强的模型也救不回来。
- 核心机制是把文本 embedding 成向量,用向量数据库做近似最近邻(ANN)语义检索,HNSW/IVF 等索引在召回率、延迟、内存之间权衡。
- 竞争分两路:专用向量库 vs 传统数据库/搜索引擎内嵌向量能力,边界正在快速融合。
- 纯向量相似会漏掉实体关系与多跳推理,GraphRAG 用知识图谱补足,擅长“需要串联”和全局摘要类问题,但构建与维护更重。
- 生产级 RAG 是一条“切块→嵌入→入库→混合检索→重排→评测”的数据工程流水线,召回与成本要持续运营,而非一次性搭好。
节点速览:技术 / 玩家 / 成熟度 / 预期
数据截止 2026-09。标尺说明见 AI 产业链总览。
| 象限 | 要点 |
|---|---|
| 关键技术 | ① embedding 向量化(TRL-5)② ANN 索引 HNSW/IVF/DiskANN(TRL-4~5)③ 混合检索(向量+关键词)与重排 rerank(TRL-4)④ 向量+元数据过滤/多租户(TRL-4)⑤ GraphRAG 知识图谱多跳检索(TRL-2~3) |
| 主要玩家 | 专用:Pinecone、Weaviate、Milvus(Zilliz)、Qdrant、Chroma;内嵌:PostgreSQL(pgvector)、Elastic、各类云向量服务;图谱:微软 GraphRAG 及图谱数据库阵营;中国:Milvus 为代表及云厂商向量服务 |
| 做到什么程度 | 向量检索已规模商用、是企业知识库标配;混合检索+重排成为生产常态;GraphRAG 在复杂关系场景试点、成本与时效仍是门槛 |
| 后续预期 | 6 个月:向量能力进一步融入主流数据库(置信度高);18 个月:GraphRAG/混合架构在企业落地增多(置信度中);36 个月:检索与 Agent 长期记忆深度整合(置信度中) |
一、先看懂 RAG 的流水线
RAG 不是一个模型,而是一条把“原始知识”变成“可被模型引用的证据”的数据流水线。
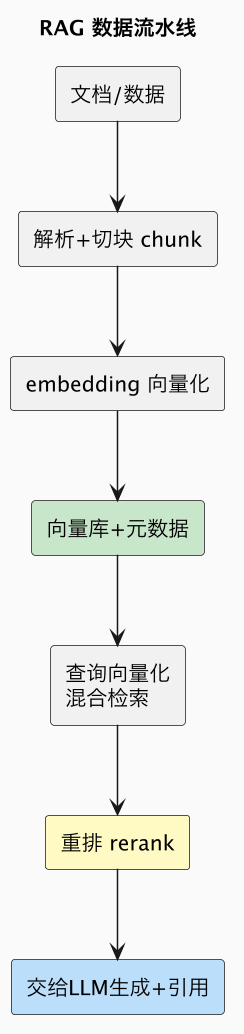
离线侧,文档被解析、清洗、切成合适大小的 chunk(切块粒度直接影响命中与上下文完整性),再由 embedding 模型转成高维向量、连同元数据(来源、时间、权限)入库。在线侧,用户问题同样向量化,去库里检索语义最相近的若干 chunk,常与关键词检索混合(兼顾“语义相近”与“精确术语命中”),再用 rerank 模型精排,把最相关证据交给大模型生成并附引用。任何一环拉胯——切块太碎丢上下文、embedding 模型不匹配、只取 top-k 不足、缺少权限过滤——都会让回答失真。
二、向量数据库:在亿万个点里找“最近”
embedding 把语义编码为向量,语义相近的文本在向量空间中距离更近。向量检索的任务,是在海量(常达千万~数十亿)向量中,快速找到与查询向量距离最近的若干个。 精确计算要和所有向量比距离,规模一大算不起,于是用近似最近邻(ANN),以可控的精度损失换取数量级的加速。
| 索引/方法 | 思路 | 权衡 |
|---|---|---|
| 暴力(flat) | 全量精确比对 | 准但慢,适合小数据 |
| IVF | 先聚类、只搜近邻簇 | 快,召回依赖聚类与探查数 |
| HNSW | 分层小世界图、贪心近邻跳转 | 召回高、延迟低,但吃内存 |
| DiskANN/量化 | 借助磁盘/向量压缩降内存 | 省成本,速度/召回折中 |
工程上还要叠加元数据过滤(只在我有权限、某时间范围内的文档里搜)、标量量化(压缩向量省内存)、多租户隔离与高可用。选型并非“召回越高越好”,而是在召回率、查询延迟、内存/成本、更新实时性之间找最适合业务的点。
三、专用向量库 vs 数据库内嵌
这一赛道的格局在快速演化,核心争论是“向量检索该不该独立成库”。
- 专用向量数据库(Pinecone、Weaviate、Milvus/Zilliz、Qdrant 等):为向量而生,索引、规模、混合检索、托管运维做得专,上手快、生态活跃,适合向量是核心负载、规模大或要求 SaaS 化省心的团队。
- 传统数据库/搜索引擎内嵌(如 PostgreSQL + pgvector、Elastic/OpenSearch 向量能力、各大云的自研库):不必新增一套系统,向量与事务、权限、业务数据同库,join 与治理方便,适合向量只是整体数据架构一环、规模中等的团队。
趋势是边界融合:专用库补齐过滤、事务与混合检索,传统库持续提升向量性能与规模。开源力量(Milvus、pgvector、Qdrant 等)在此层尤为强势,企业“用开源自建 + 云托管”的选择很多,削弱了单一商业产品的溢价。
四、GraphRAG:当“相似”不够,需要“关系”
纯向量检索有个结构性短板:它擅长找到“语义相近的片段”,却不天然理解“实体之间的关系”。回答“X 公司和 Y 机构通过哪些中间人产生关联?”“把整个语料里各方立场做个综合”这类需要多跳推理或全局摘要的问题时,零散的相似片段往往拼不出答案。
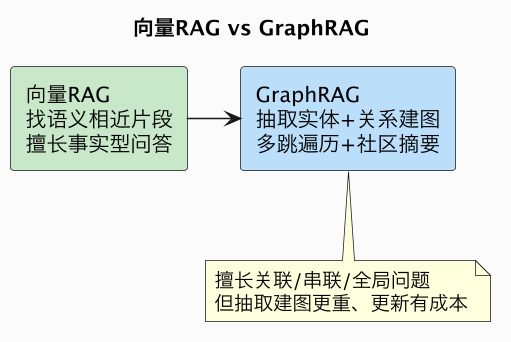
GraphRAG 先用模型从语料中抽取实体与关系、构建知识图谱,再在检索时沿图做多跳遍历,并可对“社区/子图”预生成摘要以回答全局问题。它显著提升了需要“串联线索”和“跨文档综合”的能力,但代价明显:图谱抽取耗 token、构建与更新复杂、时效性与维护成本高。因此现实多为混合:常规事实问答走向量,关系密集任务才调用图谱,用编排层按问题类型路由。
五、生产化:评测、成本与长期记忆
RAG 从 demo 到生产的鸿沟(见PoC 到生产),很大程度是数据运营问题。其一,评测要可量化:建立检索召回/命中、答案忠实度、引用正确率等指标与回归集,否则“感觉变好了”无法验证,可与 LLM 评测基准的方法论结合。其二,成本要算清:embedding 与 rerank 的模型调用、向量内存、GraphRAG 的抽取开销,随语料与查询量线性增长。其三,持续更新与治理:新知识增量嵌入、过期内容下线、权限随组织变化同步。往更远看,检索系统正与 Agent 的长期记忆融合——向量库存储“经历”、图谱存储“关系”,让 Agent 能跨会话检索与推理,这也是横向使能层长期价值所在。
常见误区
- 误区:RAG 的关键是换更强的大模型。 检索召回往往才是瓶颈,强模型也无法基于没捞到的证据作答。
- 误区:切块随便切、top-k 调大就行。 切块策略与混合检索+重排对质量影响更大。
- 误区:向量库一定要专用。 中等规模用现有数据库加向量扩展常更省事。
- 误区:GraphRAG 全面优于向量 RAG。 它更重、更贵,只在关系/全局类问题上值得。
- 误区:RAG 搭一次就完。 它是需要评测、更新与成本治理的长期数据工程。
总结
RAG 的答案上限由检索决定:文本经 embedding 向量化后,向量数据库用 HNSW/IVF 等近似最近邻索引在召回、延迟与内存间权衡,专用向量库与传统数据库内嵌路线正快速融合;纯向量相似搞不定实体关系与多跳推理,GraphRAG 以知识图谱补足却更重更贵,生产中多按问题类型混合路由;真正的 RAG 是一条‘切块—嵌入—混合检索—重排—评测—持续更新’的数据工程流水线,未来还将与 Agent 的长期记忆深度整合。
相关与延伸
- 落地鸿沟:企业 AI:PoC 到生产鸿沟
- 应用侧改造:垂直 SaaS 的 AI 化
- 质量评测方法:LLM 评测基准产业
- 数据来源之一:合成数据产业