AMD 的 AI 反攻:MI 系列追赶英伟达的真实身位
最后更新:2026-09-19|数据截止 2026 年中:具体产品规格以 AMD 官方发布为准,本文分析产品路线与竞争逻辑,不引用未经证实的跑分与份额。
本文是产业观察,回答:英伟达统治之下,AMD 的 AI 芯片到底追到哪一步、靠什么赢、又差在哪。 英伟达 AI GPU 产品矩阵 画了领跑者的牌面,CUDA 护城河 讲了生态壁垒,推理芯片专题 覆盖了 ASIC 路线;本文专讲最像「正面对位」的追赶者 AMD:它的硬件身位、ROCm 生态与「第二供应商」价值。
先说结论
- 硬件身位逐代拉近,差距主要在软件与规模。 AMD Instinct MI 系列在显存容量、HBM 带宽、互连和机架级方案上不断逼近同代英伟达,性价比常是卖点;真正的鸿沟在 CUDA 生态成熟度、全栈工具和超大规模部署经验。
- AMD 的天然优势是「必须存在的第二供应商」。 云厂和大客户不愿被单一供应商锁死,出于议价、供应安全和谈判筹码,需要一个有竞争力的第二来源,这给 AMD 提供了需求底盘,哪怕软件体验尚不及。
- ROCm 是关键变量。 硬件可追、软件难追,AMD 持续投入开放软件栈、与主流框架和推理引擎兼容、争取大客户共建,生态从「能用」走向「好用」需要时间与规模。
- 机架级与定制化是新战场。 竞争从单卡扩展到整机柜、互连和与超大规模客户的深度定制,AMD 正试图在系统层缩小差距,同时守住开放标准牌。
一句话:AMD 是英伟达之外最有资格打「正面战争」的通用 GPU 选手——硬件已能在多场景提供有竞争力的性价比,又握有大客户需要的「第二供应商」门票;它的天花板不取决于单张芯片,而取决于 ROCm 生态和系统级部署能否越过「非用英伟达不可」的临界点。
一、产品路线:从单卡到机架的追赶
AMD Instinct 产品线沿数据中心 AI 加速演进,近年的主线非常清晰:堆 HBM 容量与带宽、用小芯片(Chiplet)做大封装、强化多卡互连带宽,并从「卖卡」走向「卖整机柜」。
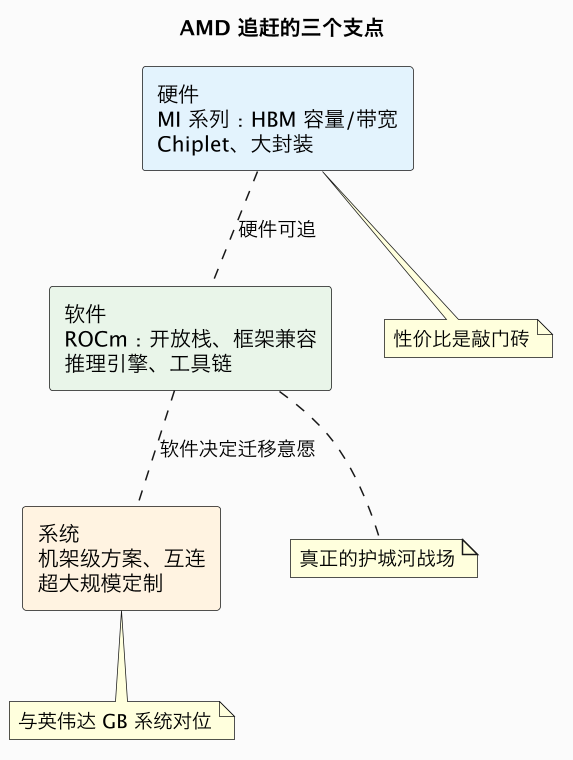
对位逻辑可以对照英伟达产品矩阵理解:当领跑者把竞争单元从单颗 GPU 提升到「整柜 + Scale-Up 互连 + 系统软件」(见 英伟达 AI GPU 产品矩阵 与 Scale-Up 网络),AMD 也必须拿出机架级参考设计与高带宽域内互连,否则只赢单卡参数也拿不下大模型训练订单。AMD 的特点是善用 Chiplet 与封装能力在成本和良率上做文章——这和它在 CPU 市场翻身的手法一脉相承。
二、第二供应商:一个「不需要你赢、但需要你存在」的生态位
理解 AMD 的需求,不能只看产品力,还要看买方结构。超大规模云厂和大型 AI 买家有强动机维持多供应商:
- 议价与供应安全:单一供应商意味着价格、配额和路线图都受制于人,存在第二来源本身就是谈判筹码(参见 CoWoS 产能配额 如何被头部客户争夺)。
- 成本敏感的推理:推理比训练更看单 token 成本,给了「同等够用、价格更好」的方案更多机会(推理经济学见 推理芯片专题 与 KV Cache 篇)。
- 开放生态偏好:部分客户对开放、可移植、避免锁定的技术路线有战略偏好,ROCm 的开放叙事正对此诉求。
但「第二供应商」也有残酷一面:它意味着客户把最难、最前沿、生态依赖最重的前沿训练仍优先给英伟达,AMD 更多从推理、特定大客户、混合部署和成本优化场景切入,需要靠一次次成功交付把份额一点点抬高。
三、ROCm:追赶真正的战场
英伟达最深的护城河不是芯片,而是 CUDA 积累多年的软件、库、工具和开发者习惯(详见 CUDA 护城河与可移植性成本)。AMD 的答案是 ROCm——一个开源、开放的 GPU 计算软件栈。
| 维度 | 英伟达 CUDA | AMD ROCm |
|---|---|---|
| 生态成熟度 | 最成熟、库与工具齐全 | 持续补齐、覆盖主流框架 |
| 开发者习惯 | 事实标准、人才与代码资产庞大 | 迁移成本是主要障碍 |
| 开放性 | 专有 | 开源开放,主打可移植 |
| 大客户共建 | 长期深度绑定 | 与超大规模客户联合优化 |
AMD 的打法不是重造一个封闭生态,而是尽量降低迁移摩擦:
- 框架层无感:让 PyTorch 等主流框架在 ROCm 上原生/良好运行,使大多数上层用户不必直接碰底层;
- 拥抱可移植中间层:与 Triton、MLIR、各类推理引擎(vLLM 等)和开放标准协同,让代码不被绑死在单一厂商(AI 编译器与开放栈逻辑见规划 E5/E1);
- 大客户优先:先集中资源把少数超大规模客户的关键工作负载做深做透,用灯塔项目证明稳定性和性价比,再向更广泛市场扩散。
软件生态的难点是「鸡与蛋」:用户少→投入回报低→生态弱→用户更少。AMD 靠第二供应商需求、推理成本敏感场景和开放标准,正在尝试打破这个循环,但越过「非用英伟达不可」的临界点需要时间和规模。
四、优势、短板与系统级战场
综合看,AMD 的机会与约束都很清晰。
优势
- CPU(EPYC)时代积累的高性能计算与数据中心客户关系,可与 GPU 打包;
- Chiplet/封装与 HBM 集成能力强,硬件迭代节奏稳;
- 开放软件叙事契合部分客户的反锁定战略;
- 「第二供应商」刚需提供了稳定的进场机会。
短板
- CUDA 生态与开发者惯性仍是最大壁垒,迁移有真实工程成本;
- 超大规模前沿训练的部署验证、工具链和标杆案例积累不及对手;
- 顶级系统软件、域内互连与整机柜生态仍在追赶;
- 高端 HBM、CoWoS 产能同样受限(见 HBM3E 到 HBM4、CoWoS)。
系统级战场:竞争焦点上移到整机柜和 Scale-Up 网络。AMD 需要在机架设计、供电液冷(见 液冷产业图谱)、域内互连、多机柜组网(万卡集群组网)上提供与英伟达对标的整体方案,同时借开放标准(UALink 等,规划 D8)争取不愿被私有生态锁定的客户。
五、变量与置信度判断
| 变量 | 作用方向 | 时间窗 | 置信度 |
|---|---|---|---|
| ROCm 与框架/推理引擎兼容改善 | 降低迁移成本 | 持续 | 高 |
| 大客户第二供应商需求 | 提供需求底盘 | 已发生 | 高 |
| 机架级与互连方案成熟 | 争取大训练订单 | 1~3 年 | 中高 |
| 开放标准(UALink 等)成势 | 削弱私有生态优势 | 3~5 年 | 中 |
| CUDA 网络效应 | 维持领跑壁垒 | 持续 | 高 |
- 未来 1~2 年(高置信度):AMD 在推理、成本敏感与特定大客户场景稳步放量,硬件性价比被认可,ROCm 对主流框架与推理引擎的兼容性继续改善。
- 未来 2~4 年(中高置信度):随机架级系统和大客户共建成熟,AMD 在更多训练项目中成为实质选项,但英伟达仍主导最前沿训练与最大规模部署。
- 长期(中置信度):AMD 的份额上限取决于软件生态网络效应是否被开放标准和客户多供战略削弱;更可能的格局是「一超一强 + ASIC 分流」,而非英伟达被全面反超。
六、对不同角色,这意味着什么
- 对模型/算力买家:把 AMD 作为第二供应商纳入组合是理性选择,尤其在推理与成本敏感负载;但要把迁移、工具链和验证成本计入总拥有成本。
- 对软件与平台团队:优先用框架层与可移植中间层(Triton 等)开发,保留多后端能力,降低对单一 GPU 软件栈的锁定。
- 对 AMD 与生态伙伴:胜负手在 ROCm 的开发者体验和大客户灯塔案例,而非单卡参数。
- 对投资者:关注 MI 系列实际放量、超大规模客户采用与机架级系统落地,而非发布跑分。
延伸观察:第二供应商的经济学与 AMD 的「非对称战场」
「第二供应商」的价值,常常被只用市场份额来衡量 AMD 的人低估。在一个供给高度紧张、且产品深度嵌入客户战略的市场里,第二来源的存在本身就有期权价值和议价价值,哪怕它短期份额不高。对超大规模买家而言,把一部分订单给 AMD,至少换三样东西:一是价格谈判的筹码,避免所有筹码压在一家供应商的报价上;二是供给安全,在 HBM、CoWoS 和整机柜全面配额制时多一条供货通道;三是技术路线保险,防止单一供应商的架构或生态选择把自己的长期产品路线锁死。这种「为了竞争本身而维持竞争」的采购逻辑,是 AMD 即使在生态落后时仍能持续获得大客户订单的结构性原因。
但 AMD 面对的也是一个非对称战场:它不需要在每个维度都赢,只需要在客户最在意的几个点上「足够好且更划算」,就能拿到份额;而领跑者英伟达哪怕只在少数关键场景被追平,也可能被迫在价格和条款上让步。这对追赶者是机会,也是陷阱——机会在于竞争被限定在性价比和特定工作负载上时,差距比想象中小;陷阱在于一旦把资源摊薄到和对手全面对标,反而会失去聚焦。理性的策略是选择最能发挥性价比和开放生态的战场(推理、成本敏感的训练、特定大客户与超大规模集群),在这些点上做到不可忽视,而不是在对手最强的前沿生态里硬碰硬。
AMD 手里还有一张被低估的牌:CPU 时代建立的数据中心信任关系。EPYC 在服务器 CPU 市场的翻身,让它重新进入了几乎所有大型数据中心的采购和认证体系,积累了路板设计、电源散热、固件、服务器 ODM 和企业支持的完整协同经验。GPU/加速器销售不是孤立的板卡生意,而是要和 CPU、主板、机架、软件栈打包交付的系统生意,AMD 能用「CPU+GPU+开放软件」的组合提案,在已经信任其数据中心能力的客户里降低决策摩擦。这种系统信任是纯初创加速器公司很难短期复制的。
与此同时,也要看清 AMD 与云厂自研 ASIC 之间微妙的既竞争又同向关系。云厂自研芯片分流的是整个第三方加速器市场,AMD 同样承压;但 AMD 又是开放生态(ROCm、UALink 等)的核心推动者,和不愿被英伟达锁定的云厂在「反锁定」目标上一致。于是 AMD 可能同时扮演两种角色:对没有自研芯片的云厂和企业,它是直接供应商;对有自研芯片的超大厂,它是开放标准生态里的同盟和补充采购对象。这要求它在商业上灵活处理「客户也是竞争对手」的关系。
从更长的时间尺度看,AMD 的意义或许不在于它会不会成为第一,而在于它维持了市场的可竞争性。一个有强大第二供应商的市场,价格更合理、客户有选择、技术路线更不容易因垄断而僵化;当开放软件栈(ROCm、Triton、各种推理引擎)和开放互连(UALink、超以太网)逐渐成熟,迁移成本下降,AMD 的竞争力会随整个开放生态的成熟而水涨船高。它的增长曲线,本质上是「多供应商开放栈」整体成熟度的一条镜像曲线。
从产品和路线图角度,还可以更细致地看 AMD 追赶的「节奏术」。面对一个每年快速迭代、软硬一体的领跑者,追赶者最忌讳的是被拖入对手定义的竞赛节奏;AMD 的现实选择,是在保持架构代际跟进的同时,把竞争引向自己有结构性优势的维度。其一是内存容量——很多大模型推理和部分训练场景,真正的约束是装不装得下模型和 KV(见 KV Cache 经济性),用更大显存或更优封装拿到「能跑更大模型」的差异化,比单纯拼峰值算力更容易被客户感知。其二是开放生态,把「不被锁定」「可多供应商」「可与自有/其他加速器混合组网」做成卖点,吸引对供应商风险敏感的超大客户。其三是系统打包,用机架级参考设计、与 ODM 的成熟合作和 CPU+GPU 组合降低客户的整体集成成本,把竞争从单卡跑分拉回到总拥有成本和交付确定性。
同时要客观评估 ROCm 生态的真实进展与短板。经过多年投入,ROCm 对主流框架(PyTorch 等)的支持、对大模型推理常用内核和通信库的覆盖已经显著改善,多数「标准训练/推理流程」可以较低成本迁移,这是它能不断拿到大客户试点的基础。但在长尾上差距依旧真实:最前沿模型发布第一天往往针对 CUDA 做深度优化,AMD 平台的适配和性能调优存在时滞;大量研究代码、自定义算子和小众库默认只支持 CUDA;企业内部积累多年的 CUDA 代码和工程经验是沉没资产。因此 AMD 的生态策略必须务实——不追求让所有 CUDA 代码无感迁移,而是抓住「框架层之下、主流模型与推理引擎之上」这个价值最大的腰部,让 80% 的主流工作负载顺畅运行,并集中资源服务头部大客户的关键场景。生态的胜负不在覆盖 100%,而在能否让决定采购的那批主流负载足够省心。
对整个行业,AMD 的存在还有一层「价格与创新的锚」意义。寡头或垄断市场里,领先者缺乏压价和快速让利的动力;一个有威胁的第二供应商会持续约束价格、合同条款和产能分配,并刺激双方在开放标准、系统设计和软件体验上加码创新。即便某些客户最终仍主要采购英伟达,AMD 的存在也改善了它们的谈判地位。因此观察 AI 加速器市场健康度,AMD(以及云厂自研 ASIC)的份额不只是一家公司的业绩,更是整个行业是否保持竞争性、客户是否保有选择权的指标。一个「一超一强加自研分流」的结构,对生态繁荣和用户成本,长期而言比单一垄断更有利。
最后,值得给竞争结局一个更克制、也更贴近产业规律的预期。在高度标准化、生态网络效应极强的技术市场,后发者「全面替代」领跑者的案例很少,更多见的是市场结构从单极走向多极:领跑者守住最前沿和最深生态,追赶者凭借性价比、开放路线和特定客户群站稳一个稳固份额,再随着技术成熟度和客户多供需求慢慢扩大。AMD 在 CPU 市场的翻身已经演示过一次这种路径——不是靠某代产品单点爆发,而是靠多年稳定的产品迭代、可信的供货和生态重建,逐步改变客户「默认只买一家」的采购习惯。AI 加速器的生态壁垒比 CPU 更深(CUDA 网络效应更强),因此这个过程大概率更慢、更依赖开放软件栈和开放互连标准的整体成熟。对行业而言,这种「一超一强 + 自研分流」的多极结构可能是长期均衡而非过渡状态;对 AMD,现实的胜利定义不是某一年份额登顶,而是持续成为客户无法忽视、必须纳入组合、且在特定场景更优的那一个「强有力的第二选择」——只要这个位置稳固,它就能在不断扩大的 AI 算力总盘子里,分享远高于硬件单价差别的长期价值。
结语:赢不赢不重要,存在且变强就已改变格局
AMD 是唯一有资格和英伟达打「正面通用 GPU 战争」的选手。它用 Chiplet 和 HBM 集成把硬件身位逐代拉近,用开放的 ROCm 回应 CUDA 锁定,更重要的是握着一张结构性门票——大客户出于议价和供应安全,必须养一个有竞争力的第二供应商。它的天花板不写在单张芯片的参数表里,而在 ROCm 生态何时越过「非用英伟达不可」的临界点、以及机架级系统能否承接最前沿训练。更可能的未来不是 AMD 反超,而是它与英伟达、以及各家 ASIC 一起,把一个被单一生态定义的市场,重新拉回到多供应商竞争的常态。
数据口径与延伸
- 数据口径:AMD Instinct 产品路线、ROCm 开放软件栈、第二供应商逻辑与机架级竞争,来自 AMD 公开信息、行业研究与公开产业分析。具体规格、跑分、份额以 AMD 官方与客户披露为准,本文不引用未经证实的精确数字。数据截止 2026 年中。
- 相关产业观察:英伟达 AI GPU 产品矩阵、CUDA 护城河、推理芯片专题、万卡集群组网、液冷产业图谱。
- 同批待写延伸:云厂商自研 ASIC(C4)、UALink(D8)、AI 编译器(E5)。
一句话总结:AMD Instinct MI 系列在 HBM 容量带宽、Chiplet 封装和机架级方案上已把硬件身位拉近同代英伟达、以性价比为敲门砖,其真正且持久的优势是手握「第二供应商」这张结构性门票——超大规模客户出于议价和供应安全必须养一个有竞争力的第二 GPU 来源,尤其在成本敏感的推理场景;但决定天花板的不是单卡而是软件:CUDA 的网络效应、库工具和规模部署经验构成最大壁垒,AMD 只能靠开放的 ROCm 与主流框架/推理引擎深度兼容、绑定大客户做灯塔项目、并在机架级互连(含 UALink 等开放标准)上对标英伟达整机柜体系,逐步打破「用户少—投入低—生态弱」的循环;更可能的终局是「一超一强 + ASIC 分流」的多供应商常态,而非全面反超。