追踪 AI 产业要问的关键问题
数据截止 2026-09。返回 AI 产业链总览,方法总纲见如何读懂 AI 产业链。
一、一句话回答
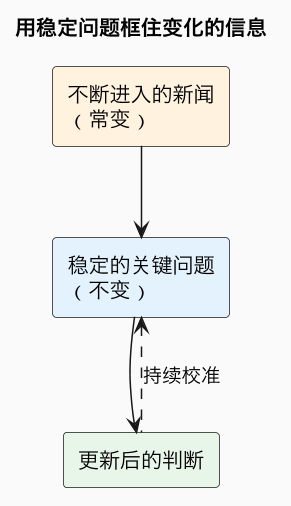
信息永远看不完,但真正决定 AI 产业走向的只有一组稳定的关键问题:需求是不是真实付费、能力能不能持续提升、算力供需处在周期哪一段、利润被谁捕获、护城河和被平台吞并的风险、能源与地缘的硬约束、监管与安全、终端和具身的节奏。把这组问题当成一张持续更新的清单,遇到新闻就往里归类、用信号作答,而不是被每条热点牵着走——判断力来自始终追问同一组好问题。
为什么用「问题清单」而不是「结论清单」。产业天天在变,任何结论都会过期,但好问题相对稳定。一个成熟观察者与信息搬运者的区别在于:前者手里始终握着同一组问题,用不断进来的新证据更新答案;后者只是被动追逐一条条结论,热点一换就推倒重来。这篇把该长期追问的问题一次列全,并说明每个问题为什么重要、看什么信号。它是一份「活清单」,会随产业演进增补。
二、需求与商业化
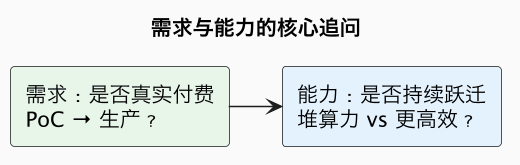
- 真实付费需求有多大,还是停留在试点? 企业 AI 预算是从「PoC(概念验证)」转向「生产环境」,还是尝鲜后撤回?这是区分产业与泡沫的第一问,看续约率、付费深度和预算科目(创新预算 vs 核心 IT 预算)。
- AI 解决的是「锦上添花」还是「非用不可」? 能不能进入核心工作流、停用后明显受损,决定留存和定价权。
- 降本是否可量化? 客户能否算出省了多少人力/时间/钱,算不清的价值很难持续付费。
三、能力与技术
- 模型能力还在持续跃迁,还是进入边际递减? 下一代相比上一代,是解锁新能力还是只小幅提升;这决定整个故事的天花板。
- 进步来自「堆算力」还是「更高效」? 像 DeepSeek 这类效率路线会改变成本和地缘格局;要关注算力效率(单位算力产出)而非只看规模。
- 训练和推理的瓶颈分别在哪? 训练看互联与稳定性,推理看显存带宽、KV Cache 和单位 token 成本。
四、算力、周期与利润
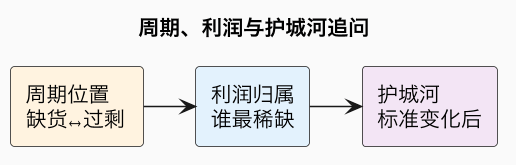
- 现在处于算力周期哪一段? GPU 是抢不到还是现货降价、云厂商 capex 在上调还是谨慎——决定该顺周期还是防反转。
- 供给会不会过剩? 大规模数据中心集中投产,需求能否接棒,利用率会不会下降。
- 利润被谁拿走,会不会迁移? 谁掌握最稀缺供给谁赚最厚(英伟达、缺货期部件);推理切换和纵向整合会让利润池移动。
- 单位经济成立吗? 每 token 成本、毛利、设备回本周期,而非增长叙事。
五、护城河、平台与竞争
- 护城河是生态、数据还是规模,标准变了还在不在? CUDA 类转换成本在训练侧最深;开放标准(UALink/UEC/MCP)可能削弱锁定。
- 有没有被平台吞并的风险? 当模型/云把热门功能做进基础能力,独立应用靠什么独有数据或工作流存活。
- 自研芯片会分流多少? 云厂商自研是优化内部成本,长期与外采并存,要看分流速度。
六、硬约束:能源、地缘与安全
- 电力和散热跟得上吗? 接电容量、变压器交期、液冷渗透率是最长约束,决定算力扩张的真实速度。
- 地缘和出口管制如何重塑供应链? 管制会不会进一步收紧、催生几套并行体系,对中国节点尤其关键。
- 安全、版权与监管怎么演化? 提示注入、数据外泄、版权诉讼、内容溯源(C2PA)和各国监管节奏,会改变成本与准入。
- 终端与具身推进到哪一步? 自动驾驶、人形机器人受数据、硬件成本和真实场景验证制约,要分清演示与可规模部署。
七、如何使用这张清单
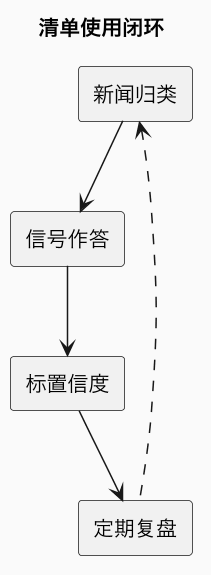
- 归类:每条新闻先判断它回答的是上面哪个问题。
- 找信号:用清单里提示的可观察指标(续约率、租金、capex、利用率、政策)作答,而非用情绪。
- 标置信度:区分事实、推断和立场,远期判断标低置信度。
- 定期复盘:每隔一段时间重答一遍,观察答案往哪个方向漂移——答案的变化方向,往往比单个答案更说明问题。
常见误区
- 追结论而不握问题:热点一换判断就清零,无法积累认知。
- 用单一问题(如算力)概括全局:需求、能源、监管任一环节都可能成为真正瓶颈。
- 问过却不跟踪信号:没有可观察指标的问题只会停留在空泛争论。
- 把清单当一成不变:技术和边界在变,问题清单本身也要随产业增补。
总结
追踪 AI 产业靠一组稳定的关键问题——需求是否真实付费、能力能否持续、算力周期与利润归属、护城河与平台风险、能源地缘与安全、终端具身节奏;把它们当活清单,用可观察信号持续作答并标置信度,判断力便来自始终追问同一组好问题,而非追逐每一条新结论。