AI FinOps
一、一句话回答
AI FinOps 管的是 GPU 这笔最大的钱:用“卡时(GPU·小时)”和“每 token/每千请求成本”做统一计量,把支出分摊到团队和模型,先做可见性(利用率、空转、排队),再针对显存浪费、低利用率推理、重复训练等源头优化——提高利用率、spot/预留混部、量化、缓存和自动伸缩。目标不是单纯砍预算,而是让每块钱 GPU 都对应可衡量的业务产出。
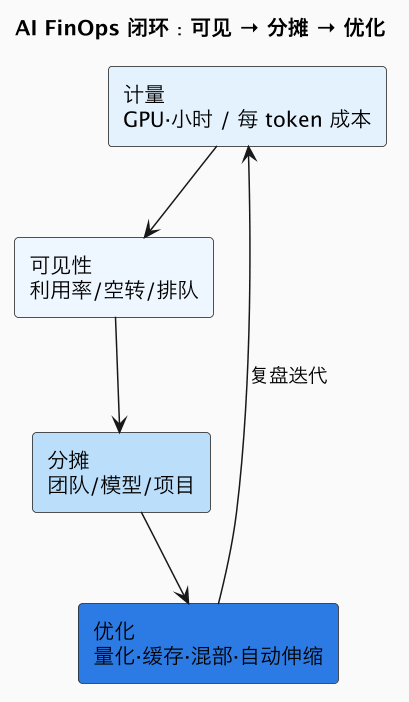
AI FinOps 是一条「先可见、再分摊、后优化」的闭环:计量口径统一之后,浪费才看得见,优化杠杆才有的放矢。它和传统云 FinOps 的关键区别在于计价单位——通用云按 vCPU·小时、GB·月计费,浪费通常是「虚机开太大、买了没用」;AI 工作负载的支出大头是按GPU·小时计的稀缺加速卡,一张 H100 级别的卡按需价可达 2~4 美元/小时,而且瓶颈常常是显存而非算力,导致「卡还在、算力闲」这种更隐蔽的浪费。因此 AI FinOps 必须同时盯住算力利用率、显存占用、排队与空转三个维度,不能只看一个笼统的「CPU 使用率」。
为什么这件事在 2026 年突然变成硬需求:过去两年 GPU 供给紧张、卡价高企,企业 AI 预算里基础设施占比迅速攀升,但模型团队的 KPI 是「把模型做出来」,几乎不感知一张卡空转一晚意味着多少钱。等账单汇总到财务,只看得到总额、看不到是哪次实验、哪个推理服务烧的,于是出现典型的「预算黑箱」——花钱的人不计数,计数的人不知道花在哪。AI FinOps 要补的正是这层「把每一次 GPU 消耗映射回团队、模型与业务价值」的计量和归因能力。
二、成本从哪来
| 浪费源 | 表现 | 对策 |
|---|---|---|
| 空转 | 分配了 GPU 但没跑任务 | 自动回收、配额 |
| 低利用率 | 推理实例稀疏、显存占满算力闲 | 动态批处理、多实例共卡 |
| 显存不足 | 被迫用更多卡 | 量化、重计算、KV 优化 |
| 重复劳动 | 多团队训相似模型 | 模型/特征共享 |
| 计价方式 | 全按需最贵 | 预留+spot 组合 |
这几类浪费里,训练侧和推理侧的形态很不一样,值得分开看。
训练侧最大的隐性成本是「占着卡等」和「重复劳动」。 一次分布式训练常常要占几张甚至几十张卡跑几小时到几天,但其中真正在做有效计算的比例往往不高:数据加载跟不上导致 GPU 等数据(data starvation)、节点间通信(all-reduce)时算力空闲、checkpoint 写盘停顿、以及因为环境/配置错误跑了半天才发现要重来。多团队各自训练能力相近的模型(比如每个业务线都微调一个自己的通用对话模型)则是另一头——这些本可以共享一个基座模型加各自的轻量适配层。重复劳动之所以普遍,是因为组织内缺少「模型与特征资产目录」,团队不知道隔壁已经训过。
推理侧的浪费集中在「实例利用率低」和「显存被占满、算力却闲着」。 在线推理为了保证延迟和峰值,往往按高峰流量预留实例,低谷时段大量实例只有零星请求却照样占着整张卡;而一个加载了大模型的实例即使不处理请求,模型权重和 KV Cache 也持续占着显存,无法把卡让给别的负载。长上下文请求会让 KV Cache 显存急剧膨胀,为了不 OOM 只能减少每卡并发或加卡,进一步拉低单位算力产出。下表把几类浪费的「可观测信号」和「通常的优化空间」对应起来,便于先做体检:
| 浪费类型 | 监控里长什么样 | 典型可回收空间 |
|---|---|---|
| GPU 空转 | 已分配但 SM 利用率长期 <5%,无活跃进程 | 直接回收,省 100% |
| 算力闲 / 显存满 | 显存占用 >85% 但算力 <20% | 提并发/量化,省 30~60% |
| 数据等待 | GPU 利用率呈周期性掉到 0 | 预取/缓存,省 10~25% |
| 峰值过配 | 高峰 CPU 也 <40%,长期低负载 | 自动伸缩,省 40%+ |
| 重复训练 | 多团队相似基座、数据高度重叠 | 共享基座,省一张整卡起 |
三、关键指标
- GPU 利用率(算力 + 显存两个维度);
- 每 token / 每千次请求成本;
- 排队时间与闲置率;
- 项目级分摊成本与对应业务收入/价值。
这些指标要真正可操作,需要把口径定义清楚,否则团队会各报各的数:
- GPU 利用率要分两个数:SM(流处理器)实际活跃比例代表「算力用没用上」,显存占用比例代表「卡还能不能再塞任务」。只报一个「利用率 90%」却不说是显存 90%,会掩盖算力其实只跑了 20% 的事实。健康的推理集群目标是在满足延迟 SLA 前提下让算力利用率尽量高(常见目标 50~70%,留尖峰余量),而不是让显存占满、算力闲置。
- 每 token / 每千次请求成本是把推理开销与业务量挂钩的单位经济指标:用该服务一段时间的总 GPU·小时成本,除以同期产出的 token 数或请求数得到。它对模型大小、量化精度、上下文长度都敏感,是比较「换更小模型 / 做量化 / 加缓存」哪个更划算的统一标尺。
- **MFU / HFU(模型算力利用率)**用于训练侧:实际有效算力占理论峰值的比例,是判断训练管线(数据、通信、并行配置)效率的核心指标。
- 排队时间与空转率反映调度质量:作业排队太久说明资源不足或配额僵化,空转率高说明回收和复用机制缺失。
- 项目级分摊则是把上述消耗按标签(team / model / env)归集,形成「谁花了多少、对应什么产出」的账单。
三点五、成本如何与业务价值挂钩
只做到「看见并分摊成本」还停留在省钱层面,AI FinOps 真正的难点和价值在于把单位成本翻译成业务语言,让管理层能判断哪些 AI 投入值得加码、哪些该收缩。做法是为不同类型的负载建立成本到价值的映射:
- 直接产生收入的负载(如对话产品、按调用收费的 API、嵌入到付费功能里的智能能力):用「每千次推理成本 vs 每千次带来的收入/毛利」算毛利率,成本上升只要毛利健康就不必紧张。
- 降本提效型负载(如客服机器人替代人工、代码助手提升工程师产出):用「AI 成本 vs 被替代的人力成本 / 多产出的产能」算回收期和节省额,这类负载往往 ROI 很高但容易被只看 GPU 账单误判为「烧钱」。
- 探索性负载(内部实验、预研):单独切一块预算池管理,设阶段性里程碑和止损线,而不是用生产负载的单位成本标准去要求它。
把负载这样分类后,财务和业务才能从「GPU 又花了多少钱」的焦虑,转向「这笔钱的回报是多少、边际上再加一块钱划不划算」的理性决策。这也是 AI FinOps 与传统 FinOps 在目标上的最大不同:传统 FinOps 偏成本控制,AI FinOps 由于技术路线(模型大小、量化、缓存、自研 vs 调用 API)对成本影响极大,更强调用单位经济指标指导技术选型与资源投放优先级,并据此动态调整投入结构——比如当自研模型的每千请求成本持续高于直接调用成熟 MaaS API、而效果又没有显著差异时,就该重新评估自建的必要性。
四、落地步骤
- 打标签、统一计量,把卡时映射到团队/模型;
- 建仪表盘,暴露空转与低利用率;
- 工程优化(量化、缓存、批处理、自动伸缩);
- 商务组合(基线预留、弹性按需/spot);
- 建立 FinOps 协作机制,工程+财务+业务持续复盘。
落地时这五步通常按「先不花钱也能见效、再动配置、最后动合同」的顺序推进:
第 1 步是埋点和打标(成本最低、收益最快)。 在调度平台和推理网关上统一注入标签——每个作业、每个推理服务都带 team、project、model、environment 字段,GPU 分配与使用数据按标签入库。没有标签,后面所有分摊和归因都无从谈起。这一步要先和平台团队约定标签是必填且校验,否则会出现大量空标签。
第 2 步建可见性仪表盘。 把算力/显存利用率、空转、排队、按团队的卡时消耗做成统一看板,让团队自己看得到自己烧了多少。很多组织发现,仅仅是「让浪费可见」就会驱动工程师主动回收空闲卡——空转率往往能在不强制的情况下明显下降。
第 3 步才上工程优化手段:训练侧加数据预取和缓存提升 MFU、清理重复实验;推理侧做动态批处理、连续批处理(continuous batching)、多实例共卡、量化和 KV Cache 优化、按负载自动伸缩。这些是把「已分配」变「高产出」的核心杠杆。
第 4 步优化采购组合:对稳定的长期基线负载签预留(reserved)或承诺用量拿折扣,用 spot/可中断实例承接可容错的训练和离线批处理,把最贵的全按需只留给真正突发、不可中断的部分。这一步必须建立在第 2 步看清负载曲线之后,否则预留可能买错型号或买过量。
第 5 步是组织机制:成立由平台工程、财务、业务方组成的 FinOps 复盘节奏(月度/季度),评审单位成本趋势、异常账单和优化项,并把成本责任写进团队目标,避免「运动式省钱」过后一切照旧。
常见误区
- 只砍预算不看价值:可能砍掉高回报负载。
- 只看算力利用率不看显存:显存往往是先到的瓶颈。
- spot 用在不能中断的任务:要有检查点与容错。
- 成本不分摊:团队没有省钱动机。
- 忽视每 token 成本随模型/上下文变化:要按真实账单结构分析。
再补几条实践中高频踩的坑:
- 用单一「利用率」数字做考核:如果只奖励「利用率高」,团队会倾向于把卡占满(甚至不释放),反而制造空转;应同时考核空转率和单位产出成本。
- 一上来就谈量化降本,却没有基线数据:量化会损失精度、可能影响业务,必须先用「每千请求成本 + 效果指标」量化收益与代价,而不是为省钱盲目降精度。
- 把缓存当万能:Prompt 缓存、前缀缓存对重复度高的请求收益巨大,但对高度长尾、一次性请求命中率低,投入产出要按真实复用率评估。
- 忽视延迟 SLA 的约束:一味提高并发和批大小来摊薄成本,会拉长单请求延迟、损害用户体验。成本优化必须在 SLA 边界内做,建议同时监控 P95/P99 延迟。
- 分摊规则过于复杂或引发争议:共享底座、共卡推理的成本如果按难以服众的规则切,团队会把精力耗在争执而非优化上。初期可用简单透明的规则(如按实际占用卡时),成熟后再细化。
- 把 FinOps 当一次性项目:负载、模型、价格都在变,单位成本需要持续监控和复盘,建完仪表盘不维护会很快失真。
总结
AI FinOps 以卡时和每 token 成本为统一货币,把 GPU 支出做可见、可分摊,再从空转、低利用率、显存浪费和重复训练等源头,用利用率提升、混部、量化缓存和计价组合优化;核心是让 GPU 支出与单位业务价值挂钩,由工程、财务与业务共同运营,而非简单压缩预算。