上线前先“演练”一万遍:AI 集群的网络数字孪生与仿真验证
数据截止 2026-09。承接万卡集群网络拓扑、大规模训练故障与可靠性、InfiniBand vs 以太网 UEC。
建一个万卡 AI 集群,网络是其中最贵、最难返工的部分之一:交换机层级、数万根线缆、路由与拥塞控制配置一旦落地,任何一个端口接错、一条策略配反、一处被忽视的拥塞热点,都可能让整批昂贵 GPU 在训练中互相等待、吞吐骤降,而排查可能要数天。网络数字孪生(Network Digital Twin, NDT)的思路是:在物理网络建成或配置变更生效之前,先在软件里建一个与真实网络“同拓扑、同路由、同拥塞行为”的虚拟副本,把布线、配置、故障、流量峰值都先在副本里“演练”,确认无误再推到生产。它把昂贵的“事后救火”前移为便宜的“事前彩排”。
先说结论
- AI 集群网络极贵且难返工,数字孪生把风险前移:在虚拟副本里做拓扑校验、配置预演、拥塞与故障仿真,再动真实网络。
- 数字孪生不只是“画拓扑图”,核心是让模型具备真实的转发、路由与拥塞动态,并与现网配置/遥测保持同步。
- 建模在精度与算力间权衡:包级仿真最准但慢且贵,流级/抽象仿真快但牺牲细节,常按问题分层混用。
- 最大价值场景是变更安全(change pre-check)、容量规划、故障演练与训练任务上线前的网络适配验证。
- 该领域工具分散、偏工程内化;云厂商与超大规模企业多自研,独立产品在验证(validation)、可观测与仿真方向切入。
节点速览:技术 / 玩家 / 成熟度 / 预期
数据截止 2026-09。标尺说明见 AI 产业链总览。
| 象限 | 要点 |
|---|---|
| 关键技术 | ① 拓扑/配置建模与形式化验证(TRL-3~4)② 包级网络仿真(TRL-3)③ 流级/混合抽象仿真(TRL-3)④ 与遥测/CMDB/配置系统同步闭环(TRL-3)⑤ 故障注入与 What-if(TRL-3) |
| 主要玩家 | 超大规模云/大型互联网(多为内部平台);网络设备商与仿真/可观测厂商;开源/学术仿真器社区;面向企业的网络验证与数字孪生创业公司 |
| 做到什么程度 | 拓扑与配置校验较成熟;动态拥塞/训练流量仿真仍偏专家工具;与生产闭环、自动比对的“高保真孪生”尚在早期 |
| 后续预期 | 6 个月:变更前校验在更多大厂常态化(置信度中);18 个月:训练流量建模保真度提升(置信度中);36 个月:孪生与可观测/自动化运维深度融合(置信度低) |
一、孪生和“画拓扑”“普通监控”有何不同
网络团队早就有拓扑图和监控,但它们回答的问题不同。拓扑图是静态结构、监控是“事后/实时看到现网状态”,而数字孪生要回答的是**“如果我这样改,会发生什么?”**——它必须在变更尚未发生时,预测转发路径、瓶颈与故障影响。
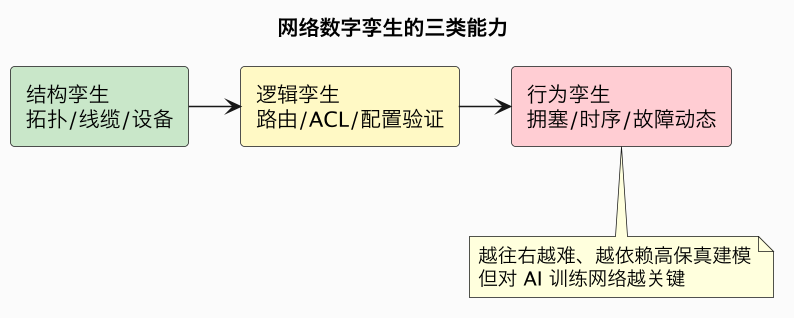
一个有用的孪生通常具备三层:结构孪生(谁连谁)、逻辑孪生(按真实配置计算可达性与策略,能发现路由环路、黑洞、ACL 误配)、行为孪生(模拟流量随时间的排队、拥塞与延迟)。AI 训练网络最需要、也最难的是行为孪生——因为 collective 通信(all-reduce 等)造成的是高度同步、周期性的“整体流量”,局部微拥塞就可能放大成全局减速(见大规模训练故障与可靠性)。
二、保真度与算力的权衡:包级 vs 流级
仿真不可能既百分百精确又算得飞快,必须按要回答的问题选择粒度。
| 建模粒度 | 做法 | 优点 | 局限 | 适用 |
|---|---|---|---|---|
| 包级仿真 | 逐个/抽样模拟数据包的排队、丢弃、ECMP | 最接近真实、能看微突发 | 计算量大、慢、参数标定难 | 关键拥塞/协议细节验证 |
| 流级仿真 | 把流量抽象为流,估算吞吐与时延 | 快、可跑大规模 What-if | 看不到微突发细节 | 容量规划、宏观比对 |
| 形式化/图验证 | 把配置建模为图与约束做数学验证 | 能严格证明可达/无环 | 不含性能动态 | 配置/策略变更前检查 |
实践中往往混用:用图验证快速拦截配置类硬错误,用流级仿真跑多种规模/故障组合做容量与风险筛查,只对少数关键设计用包级仿真精算。模型还需要用真实网络的遥测数据不断标定(calibration),否则“孪生”与现网行为会逐渐漂移,失去预测价值。
三、最值钱的场景:变更安全与故障演练
AI 集群网络的大部分事故不是“设计不出来”,而是“一次改动引发的连锁反应”:升级一个交换机固件、调整一条 ECMP/路由策略、增减一个 plane、把某个训练任务的通信模式换了。孪生把这些变更变成可回滚、可预演的操作。
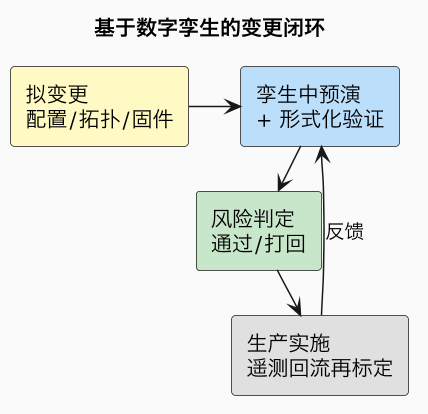
典型用法包括:
- 上线前拓扑/布线校验:与实际 LLDP/线缆清单比对,提前发现错连、漏连、端口速率不匹配。
- 变更前 What-if:路由、ACL、PFC/ECN、拥塞控制参数调整,先在孪生里跑,避免生产里触发拥塞扩散。
- 故障注入演练:断开一条链路、重启一台交换机、模拟一个 plane 降级,观察 collective 通信与训练吞吐的衰减和恢复,检验容错设计。
- 容量与规模规划:从 4k 卡扩到 8k/16k 卡时,预判哪些层级会先成瓶颈、要补多少交换机与光模块(与交换芯片、铜缆选型联动)。
四、玩家格局与落地方式
| 类型 | 代表 | 特点 |
|---|---|---|
| 超大规模云/头部互联网 | 多为内部仿真与验证平台 | 数据最全、场景最真实,成果较少外售 |
| 网络设备商 | 提供与自家设备配套的仿真/验证工具 | 与硬件/操作系统绑定,偏保障自身方案 |
| 独立软件/创业公司 | 网络验证、可观测、数字孪生方向 | 从配置校验或可观测切入,向动态孪生延伸 |
| 开源/学术 | 各类网络仿真器与研究框架 | 灵活、成本低,但工程化与保真需自建 |
整体看,这个领域工具分散、标准化程度低、强依赖内部工程能力:超大规模企业把它当“护城河”自研,中小企业往往从“配置形式化验证 + 监控”轻量起步,真正高保真、与生产自动闭环的行为孪生仍是稀缺能力。这也呼应了网络本身InfiniBand 与以太网在协议、拥塞控制上的复杂性——孪生的难度正是网络复杂度的镜像。
五、局限、风险与后续预期
- 保真度陷阱:仿真参数若未被真实数据标定,结论可能“看起来专业但其实不准”,反而给人虚假安全感。
- 维护成本:现网不断变化,孪生必须靠自动化同步配置与遥测,否则很快过期;手工维护不可持续。
- 算力与时间成本:包级仿真大规模网络很昂贵,如何在 CI/CD 变更流程中“跑得足够快又足够准”是工程难点。
- 6 个月:变更前校验在更多大型 AI 平台常态化(置信度中)。
- 18 个月:训练 collective 流量建模的保真度与速度提升、工具链更易用(置信度中)。
- 36 个月:孪生与可观测、自动化运维、AI 网络控制闭环深度融合,成为高端集群标配能力之一(置信度低)。
常见误区
- 把拓扑图当数字孪生:静态结构无法预测变更后的路由与拥塞后果。
- 迷信仿真精度:不做真实数据标定的高保真仿真可能偏差很大,关键决策仍需小范围灰度验证。
- 只在建设时用一次:孪生价值随每次变更复利,需要持续同步与维护。
- 忽视行为层:AI 训练的同步通信对微拥塞极敏感,仅做配置正确不等于性能安全。
总结
网络数字孪生是在万卡集群“真烧钱”之前先在软件里把网络演练一万遍——它用结构、逻辑到行为的三层虚拟副本,把错连、误配、拥塞与故障的代价从事后排爆前移为事前彩排,正在成为高端 AI 集群变更安全与容量规划的关键工程能力。