AI 产业链术语速查表
数据截止 2026-09。返回 AI 产业链总览,阅读方法见如何读懂 AI 产业链。 用法:按层分组速查,每个术语给全称 + 一句话解释,括号标所属层。术语口径与全专栏一致。
一、一句话回答
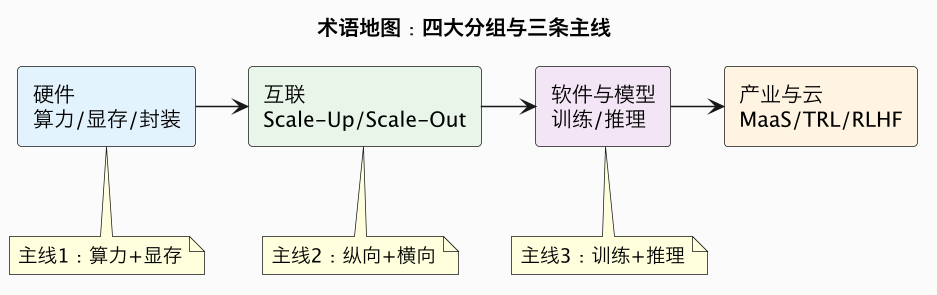
这张表把读 AI 文章最高频的术语按「硬件 → 互联 → 软件与模型 → 产业与云」四组串起来:记住三条主线即可——硬件看「算力、显存容量、显存带宽」三要素,集群看「Scale-Up 纵向扩展、Scale-Out 横向组网」两域,模型看「训练一次、推理反复用」两阶段;其余名词基本都是这三条主线上的具体部件。
二、硬件与算力(L1~L2)
| 术语 | 全称 / 含义 | 一句话解释 |
|---|---|---|
| GPU | Graphics Processing Unit,图形处理器 | 最初为图形并行计算设计,因擅长大规模并行矩阵运算成为 AI 训练和推理的主力芯片 |
| ASIC | Application-Specific Integrated Circuit,专用集成电路 | 为特定用途定制的芯片,AI ASIC(如 TPU)跑固定模型时比通用 GPU 更省电、更便宜,但不灵活 |
| HBM | High Bandwidth Memory,高带宽存储器 | 多层 DRAM 用 TSV 垂直堆叠、紧贴 GPU 的显存,带宽极高,是 AI 芯片最紧缺的部件之一 |
| DRAM | Dynamic Random Access Memory,动态随机存取存储器 | 主流内存颗粒,HBM 就是把多层 DRAM 先进封装堆叠而成 |
| 显存 | GPU 板载内存 | 存放模型权重和 KV Cache;容量决定能跑多大模型,带宽决定喂数据多快 |
| 显存带宽 | — | 显存与计算单元之间每秒传输的数据量(GB/s 或 TB/s 量级),是推理速度的关键瓶颈 |
| CoWoS | Chip-on-Wafer-on-Substrate | 台积电的 2.5D 先进封装技术,把 GPU 裸片和 HBM 集成在同一块中介层上,产能长期紧张 |
| Chiplet | 小芯片 | 把一颗大芯片拆成多个小裸片再封装到一起,降低制造难度、提高良率,是先进封装的主流思路 |
| 先进制程 | — | 通常指 7nm 及以下的半导体制造工艺,数字越小晶体管越密、能效越好 |
| TSV | Through-Silicon Via,硅通孔 | 垂直贯穿硅片的导电通道,是 HBM 三维堆叠的关键工艺 |
| 2.5D / 3D 封装 | — | 2.5D 把多颗裸片并排放在中介层上;3D 把裸片垂直堆叠,互连更短、密度更高 |
| TOPS / FLOPS | Tera Operations / Floating-point Operations Per Second | 衡量算力的单位,每秒万亿次运算;AI 常看低精度(FP8/FP4/INT8)下的峰值算力 |
| 算力精度(FP16/FP8/FP4/INT8) | Floating-Point / Integer | 精度越低,单位面积能做的运算越多、越省电,推理常可用低精度换取更高吞吐 |
| MFU | Model FLOPS Utilization,模型算力利用率 | 实际有效算力占理论峰值的比例,万卡集群常只有 30%~50%,是衡量集群效率的核心指标 |
| TDP | Thermal Design Power,热设计功耗 | 芯片标称的功耗与散热设计基准,AI 单卡已达数百瓦、单机柜上百千瓦 |
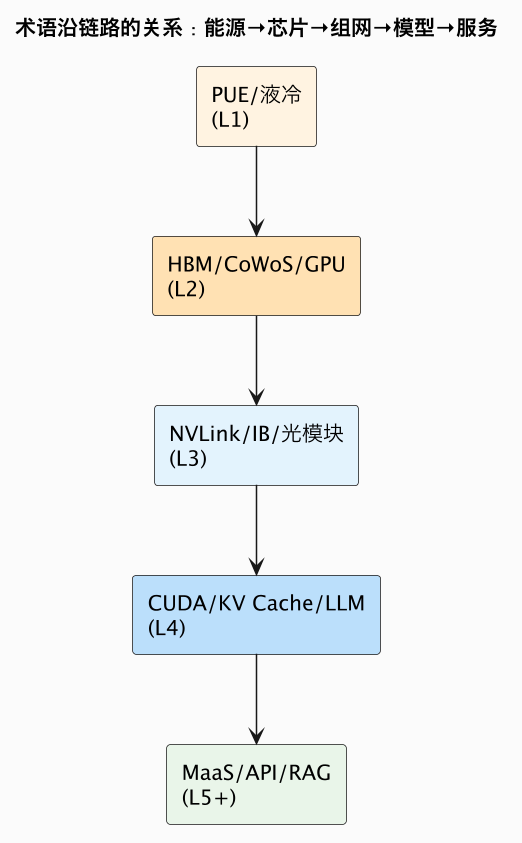
硬件侧记住三要素就够了:算力决定算得多快,显存容量决定能跑多大的模型,显存带宽决定喂数据给计算单元的速度。先进封装(CoWoS/HBM)则决定这些芯片能造出多少。
三、集群互联与网络(L3)
| 术语 | 全称 / 含义 | 一句话解释 |
|---|---|---|
| Scale-Up | 纵向扩展 | 用高速总线把多张卡在一个机柜内连成「一台超级计算机」,如 NVLink/NVSwitch |
| Scale-Out | 横向扩展 | 用网络把成千上万个节点连成集群,节点间靠 IB 或以太网通信 |
| NVLink / NVSwitch | — | 英伟达的高速片间互连总线及交换芯片,带宽远高于普通网卡,是其整柜战略的核心 |
| InfiniBand(IB) | — | 高带宽、低延迟的专用网络,长期是 HPC 和 AI 集群 Scale-Out 的主流 |
| 以太网 / Ethernet | — | 数据中心通用网络,随 UEC 等标准增强,正与 InfiniBand 在 AI 集群正面竞争 |
| UEC | Ultra Ethernet Consortium,超以太网联盟 | 推动以太网为 AI 优化的行业组织,目标是打破专用网络的锁定 |
| UALink | Ultra Accelerator Link,超加速器链路 | 多家厂商发起的开放 Scale-Up 总线标准,对标 NVLink |
| 胖树(Fat-Tree) | — | 多级无阻塞网络拓扑,越往上带宽越粗,是大规模 AI 集群最常见的组网方式 |
| Rail 优化拓扑 | — | 按「轨」组织网卡和交换机的组网方式,让多机通信负载均匀、节省高端口设备 |
| 光模块 | Optical Transceiver | 把电信号转成光信号的模块,速率从 800G 向 1.6T 演进,AI 网络需求爆发的部件 |
| 硅光 / CPO | Silicon Photonics / Co-Packaged Optics | 硅光把光学元件集成在硅芯片上;CPO 把光模块与交换芯片共封装,降功耗提密度,处早期商用 |
| DCI | Data Center Interconnect,数据中心互联 | 连接不同数据中心、园区之间的高速网络 |
互联侧分两域:Scale-Up 解决机柜内多卡协同(NVLink 这类超高速近距互连),Scale-Out 解决跨节点组网(IB/以太网、光模块和拓扑)。网络不行,MFU 就上不去。
四、软件、模型与推理(L4)
| 术语 | 全称 / 含义 | 一句话解释 |
|---|---|---|
| CUDA | Compute Unified Device Architecture | 英伟达的并行计算平台和编程生态,含大量算子库,是其最深的软件护城河 |
| Transformer | — | 2017 年提出、基于注意力机制的神经网络结构,是当今几乎所有大模型的底座 |
| LLM | Large Language Model,大语言模型 | 参数达数十亿到上万亿、在海量文本上训练的模型,能理解和生成语言 |
| Token | 词元 | 模型处理文本的最小单位,也是 API 的计价单位 |
| 参数(Parameters) | — | 模型中可学习的权重数量,常用 B(十亿)衡量,如 7B、70B |
| 训练 / 微调 | Training / Fine-Tuning | 训练是用海量数据从零学参数;微调是在基座模型上用少量领域数据继续训练 |
| 推理(Inference) | — | 训练好的模型对外生成回答的阶段,随用户量持续发生、是长期成本 |
| KV Cache | Key-Value Cache,键值缓存 | 推理时缓存已算的注意力中间结果避免重复计算,长上下文下大量占用显存 |
| 量化(Quantization) | — | 把参数从高精度转成低精度(INT8/FP8/FP4)以减小体积、降低推理成本 |
| 推理引擎 | Inference Engine | 优化模型上线运行的软件,如 vLLM、TensorRT-LLM,负责批处理和显存调度 |
| MoE | Mixture of Experts,混合专家 | 把模型分成多个专家子网络,每次推理只激活一部分,以较低计算量扩大参数规模 |
| 投机解码 | Speculative Decoding | 用小模型先草拟、大模型批量校验的推理加速技术 |
| 多模态 | Multimodal | 同时处理文本、图像、音频、视频等多种数据类型的能力 |
| 推理模型 | Reasoning Model | 用更长「思考」过程(测试时计算)换取更强逻辑推理能力的一类模型 |
| 开源 / 开放权重 | Open-Source / Open-Weights | 开放权重指参数可下载(许可可能限商用);严格开源还含数据和代码,业界常混用 |
| 上下文窗口 | Context Window | 模型一次能处理的最大 token 数,长上下文指能读入很长的文档或对话 |
软件模型侧分两阶段:训练是一次性投入巨大的「造模型」,推理是随用量持续花钱的「用模型」。推理优化(KV Cache、量化、引擎)是规模化后最受关注的工程领域。
五、产业、云与商业(L5 及横切)
| 术语 | 全称 / 含义 | 一句话解释 |
|---|---|---|
| TRL | Technology Readiness Level,技术成熟度 | 五级成熟度标尺,TRL-1 实验 → TRL-5 红海,详见标尺解读 |
| 置信度 | Confidence | 对判断把握程度的标注(高/中/低),与 6/18/36 个月预期配合 |
| MaaS | Model as a Service,模型即服务 | 云厂商通过 API 提供模型调用、按 token 计费,是算力 OpEx 化的主要形态 |
| API | Application Programming Interface,应用程序接口 | 应用调用模型能力的标准入口,API 价格战是大模型商品化的直接体现 |
| Neocloud | 新型云 | 专注 GPU 算力租赁的新兴云厂商(如 CoreWeave),区别于综合公有云 |
| Hyperscaler | 超大规模云厂商 | AWS、Azure、谷歌云、Meta 等拥有海量数据中心的巨头 |
| CapEx / OpEx | Capital / Operating Expenditure | 买服务器建数据中心是资本支出;租云、按 token 付费是运营支出,AI 推动支出由前者转向后者 |
| RLHF | Reinforcement Learning from Human Feedback | 用人类对回答好坏的标注训练模型,是 ChatGPT 类模型的关键技术 |
| 数据标注 | Data Labeling | 给原始数据打标签供模型学习,RLHF 标注是其中高价值环节 |
| RAG | Retrieval-Augmented Generation,检索增强生成 | 先从知识库检索资料、再让模型据此回答,企业落地最常见方案 |
| Agent | 智能体 | 能自主规划、调用工具、多步执行任务的 AI 形态,比单次问答更进一步 |
| MCP | Model Context Protocol,模型上下文协议 | 让模型标准化连接外部工具和数据源的开放协议,正在形成工具生态 |
| PUE | Power Usage Effectiveness,电能使用效率 | 数据中心总耗电与 IT 设备耗电之比,越接近 1 越节能 |
| 液冷 | Liquid Cooling | 用液体替代空气给高密度芯片散热,分冷板式和浸没式,高功率机柜的必然选择 |
| TAM/SAM/SOM | Total/Serviceable/Obtainable Market | 市场规模测算的三层口径,详见市场规模测算 |
常见误区
- 把开放权重等同于严格开源:多数「开源模型」只开放权重,数据和代码未必开放,商用还可能受许可证限制。
- 把 FLOPS 峰值当成实际性能:峰值要乘以 MFU 才是有效算力,而 MFU 受显存、网络、批处理多重制约。
- 混淆显存容量和显存带宽:容量决定能否装下模型,带宽决定生成速度,是两个独立瓶颈。
- 把 Scale-Up 和 Scale-Out 当一回事:前者是机柜内超高速互连(NVLink 域),后者是跨节点组网(IB/以太网域),瓶颈完全不同。
总结
术语虽多但只有三条主线:硬件看算力、显存容量与带宽三要素,集群分 Scale-Up 纵向与 Scale-Out 横向两域,模型分训练一次、推理反复用两阶段;其余名词都是这三条主线上的部件——先把全称和所属层对上号,再回总览顺链路读,概念就不会打架。