混合键合与 3D 堆叠
先说结论
- 微缩变慢变贵后,“第三维”成为密度的新来源:把芯片面对面叠起来,用更短、更密的互连替代在二维平面上狂奔。
- 混合键合是关键工艺跳变:它不靠焊料凸点,而是让铜焊盘与介质层在高温加压下直接融合,互连间距从几十微米压到个位数微米甚至更小,密度、带宽、功耗全面改善。
- 路线分野:AMD 用 3D V-Cache 叠缓存做游戏/服务器 CPU;台积电 SoIC、英特尔 Foveros 推进逻辑对逻辑的 3D;HBM 仍主要靠微凸点堆叠,但未来也在向混合键合演进。
- 真正的门槛是良率与热:两片都必须是已知良品(KGD),否则一片坏整片报废;叠层散热、翘曲、对准误差都是硬约束。
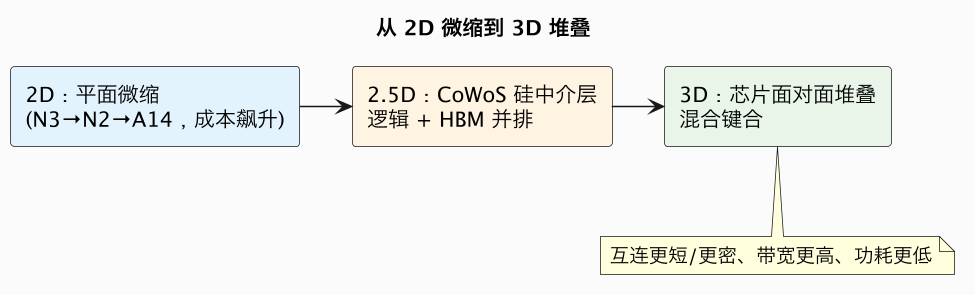
一、微凸点 vs 混合键合
| 维度 | 微凸点 microbump | 混合键合 hybrid bonding |
|---|---|---|
| 连接材料 | 焊料(锡银等) | 铜 + 介质直接键合 |
| 凸点间距 | 约数十微米 | 个位数微米及以下 |
| 互连密度 | 较低 | 数量级提升 |
| 寄生电容/功耗 | 较高 | 显著更低 |
| 工艺温度/难度 | 相对成熟 | 高,对洁净/对准极敏感 |
| 典型 | HBM、多数 2.5D/3D | 3D V-Cache、SoIC、未来 HBM |
二、为什么“短互连”这么值钱
芯片性能不只看晶体管,还看数据在单元之间搬运的代价。互连越短,RC 延迟越小、驱动功耗越低、单位带宽越高。把大容量 SRAM 直接叠在计算核心上方,等于给 CPU “头顶一片超大缓存”,游戏与对缓存敏感的负载收益立竿见影——这正是 3D V-Cache 的逻辑。
三、三种“往上叠”的形态
| 形态 | 叠什么 | 价值 | 代表 |
|---|---|---|---|
| 逻辑 + 缓存 | SRAM 叠在 CPU 上 | 大缓存、游戏/服务器提频提效 | AMD 3D V-Cache |
| 逻辑 + 逻辑 | 不同工艺裸片堆叠 | 各取最优工艺、缩短互连 | 台积电 SoIC、Intel Foveros |
| 逻辑 + 内存/多颗 DRAM | 存储贴近计算 | 带宽墙、近内存计算 | HBM 演进、3D DRAM 研究 |
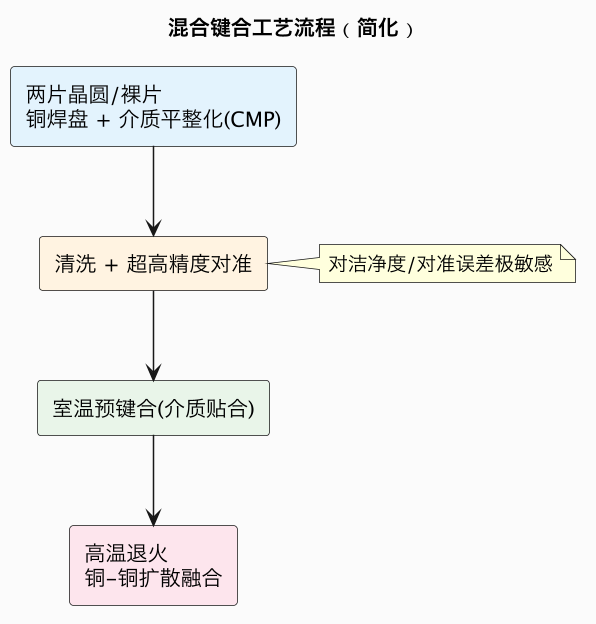
四、工艺要点(为什么难)
- 表面平整与洁净:铜要嵌在介质中并抛光到近乎原子级平整,任何微粒都会造成空洞;
- 对准精度:间距缩到微米级,两片的叠对误差必须极小;
- 退火与铜扩散:加热让铜原子互相扩散形成可靠连接,温度还要控制以免损伤器件;
- 翘曲与应力:不同材料热膨胀失配会导致翘曲,影响键合成片率;
- 晶圆对晶圆(W2W) vs 裸片对裸片(D2W):W2W 密度高但要求两片晶圆良率匹配,D2W 灵活、适合异构但对准更难。
五、良率与 KGD:3D 最硬的经济账
3D 堆叠是“乘法良率”:最终良率约等于各层良率相乘。因此每片在堆叠前都应是已知良品(KGD, Known Good Die),否则把坏片叠进昂贵的多层结构,等于浪费其余所有层。难点在于:
- 裸片级测试比封装后测试更难、更贵;
- 晶圆对晶圆时,整片良率不匹配会拖累整体;
- 层数越多,良率与成本压力越大。
这也解释了为什么商业化通常从两层、从“缓存叠逻辑”这种收益明确、风险可控的形态起步,再逐步增加复杂度。
六、热:3D 的天花板
叠层虽好,但热量更难散出:
- 多层逻辑发热集中、中间层远离散热面,热点温度上升;
- 高温导致漏电增加、性能下降、可靠性变差;
- 工程上要用更薄的裸片、热界面材料(TIM)、微流道/嵌入式液冷、以及热感知的布局与功耗管理;
- “能叠多少层”很多时候不是制造决定,而是散热决定。
七、与背面供电、先进工艺的协同
3D 堆叠不是孤立技术,它和背面供电网络(BSPDN/ buried power rail)、GAA 晶体管、先进封装协同:
- 背面供电把电源线挪到硅片背面,正面留给信号线,缓解布线拥塞、降低 IR drop;
- 3D 则在封装/系统维度增加密度;
- 二者共同构成“前道微缩 + 后道堆叠”的组合拳,延续系统级的性能/密度提升。
八、对产业格局的含义
- 代工厂把战线延伸到封装:台积电用 CoWoS/SoIC、Intel 用 EMIB/Foveros 把“前道—后道”打包成系统级方案,封测厂和设备材料厂格局随之调整;
- 设计公司获得新杠杆:不必死等新一代工艺,可用 3D 缓存/异构堆叠做产品差异化;
- 国产替代的窗口:在先进逻辑受限情况下,先进封装/混合键合成为“用封装补工艺”的重要路径,但设备(高精度键合机、CMP、量测)和材料仍是门槛。
九、深度专题:3D 堆叠如何反向重塑芯片架构
3D 堆叠带来的不只是“封装方式变了”,它正在反向改变架构师设计芯片的思路。传统 SoC 设计假设所有模块都铺在同一硅平面上,通过金属层互连;而在 3D 世界里,架构师第一次可以把“空间位置”当作一个可优化维度——让通信最频繁的两个单元在垂直方向上贴到最近。
1. 从“平面布局”到“垂直分区”
- 在 2D 布局里,缓存、计算核、I/O、电源要争抢同一平面的布线资源,关键总线不得不绕线,长度由布局拥挤程度决定;
- 在 3D 分区里,可以按“通信热度”分层:把大容量末级缓存整层叠在核心层正上方,让访存路径变成数百微米的垂直通孔,而不是横跨芯片的毫米级长线;
- 这等于把“近数据计算(near-data processing)”从口号变成物理现实,驱动大缓存、内存内/近内存计算架构的复兴。
2. 分区必须考虑“热-良率-带宽”三角
垂直分区不是越细越好,而要在三者间取舍:
- 带宽:分得越细、混合键合焊盘越密,层间带宽越高;
- 良率:密度提高对对准和表面质量更苛刻,且层数越多乘法良率越低;
- 热:高功耗逻辑层若夹在中间,热量被上下层封住,热点温度陡增。
成熟的设计往往把高发热的计算层放在靠近散热面的一侧,把相对“凉”的缓存/SRAM 层放在外侧或上方,甚至为中间层预留微流道——分区决策从第一版架构图就要和热仿真、可测性设计一起做。
3. 可测试性设计前移到架构阶段
因为 3D 是乘法良率,架构师必须在早期就规划:每一层在堆叠前如何自测、键合后如何定位是哪一层出问题、坏片如何在 D2W 流程里被提前剔除。这推动了 KGD 测试、边界扫描、堆叠中测试(known-good-stack) 成为架构级议题,而不只是后端测试部门的事。
十、产业链:混合键合撬动的设备与材料新需求
每一次封装工艺跃变,都会在设备与材料端制造新的需求高峰,混合键合尤其如此。它需要的不只是一台键合机,而是一整条全新工艺链:
| 环节 | 关键设备/材料 | 为什么是门槛 |
|---|---|---|
| 嵌铜与平坦化 | 电镀、CMP(化学机械抛光) | 表面要平坦到纳米级,余量极小 |
| 表面处理 | 清洗、活化(等离子等) | 任何残留/微粒都会造成键合空洞 |
| 对准与键合 | 高精度混合键合机 | 对准误差要压到微米/亚微米 |
| 退火 | 退火炉 | 铜扩散与器件耐受温度的平衡 |
| 量测检测 | 3D 量测、声学/电子检测 | 隐藏界面缺陷难查 |
| 载体与临时键合 | 临时键合胶、载板 | 超薄晶圆搬运支撑 |
从产业格局看,这条链的价值量正在从“传统焊料封装”向“高精度前道级设备”迁移——混合键合机的工艺洁净度和对准要求已接近晶圆制造设备,而不再是传统后道封测设备的量级。这也是为什么掌握高精度键合、CMP、量测能力,被视为先进封装竞赛的真正制高点;对国产链而言,混合键合设备、先进 CMP、专用材料既是短板也是最值得投入的替代窗口。
十一、路线图对比:三家巨头的异构集成哲学
虽然方向一致,但头部公司在“先做什么、怎么命名、押哪种互连”上差异明显,反映了各自的业务与制造禀赋:
- AMD / 3D V-Cache:选择收益最确定、风险最小的切入点——把额外 SRAM 用混合键合叠在 CCD 上方,直接做大缓存,游戏与对缓存敏感的工作负载立竿见影;优点是商业化快、验证清晰,属于“先用 3D 解决一个明确痛点”的务实路线。
- 台积电 / SoIC(System on Integrated Chips):依托代工制造能力,把混合键合作为前道的延伸,推进逻辑对逻辑的高密度 3D,再与 CoWoS 等 2.5D 封装组合成完整系统级方案;其优势是制造与封装一体化、客户无需自己掌握键合工艺。
- 英特尔 / Foveros:走 3D Face-to-Face 堆叠 + EMIB(2.5D)组合,强调把不同工艺的计算块与基础 die 叠合,用先进封装延续 x86 产品差异化;与自家代工路线绑定。
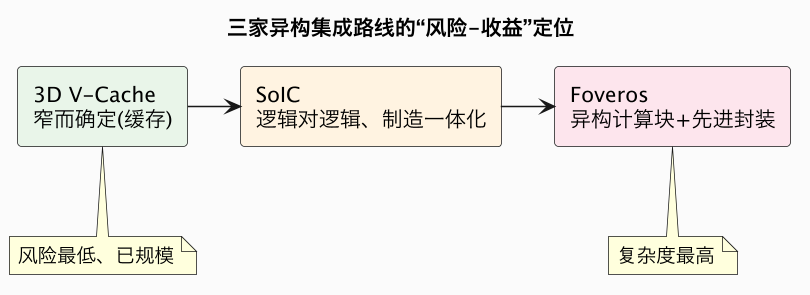
判断要点:评估这些路线时,不应只看发布的互连间距或带宽数字,而要看真实量产规模、良率、有多少产品在用——路线图发布与规模交付之间常有数年差距。
十二、成本曲线与商业化节奏:什么时候 3D 才“划算”
判断混合键合何时大规模普及,核心是一条成本曲线:当性能/密度收益足以覆盖更高的工艺与良率成本时,渗透才会加速。
1. 早期为何只在高价值场景用
混合键合对表面、对准、洁净和 KGD 的要求都更高,初期良率低、单位成本高,因此先在“收益明确且客户愿付溢价”的产品落地:高端 CPU 的大缓存、旗舰加速器的异构集成。普通产品用更便宜的微凸点/2.5D 即可,没必要承担额外成本。
2. 成本下降的三个来源
- 设备与工艺成熟:键合机吞吐提升、缺陷密度下降、CMP/清洗流程标准化;
- 规模效应:更多产品采用后,产线学习曲线压低单位成本;
- 良率提升:KGD 测试和过程控制改进,减少报废。
当“每提升一单位密度所付的边际成本”低于继续在二维微缩上的边际成本时,混合键合就会从旗舰走向主流。
3. 与摩尔经济学的关系
混合键合的兴起本身就是“微缩性价比恶化”的镜像:新一代逻辑工艺的晶圆价格不断抬高,厂商愿意把一部分预算转投封装与 3D,用系统级集成换性能。这使先进封装从“后道配套”升格为与前道工艺并列的战略投资,CoWoS、SoIC、Foveros 的产能争夺即是明证。
十三、给读者的判断框架
- 看到“XX 堆叠层数翻倍”的新闻,先问三件事:是否量产、良率多少、散热怎么解决;规格不等于产品。
- 评估国产先进封装进展,重点看设备(高精度键合机、CMP、量测)、材料与高良率集成能力,而非单点样品。
- 判断某产品是否真需要 3D:收益是否来自“短互连/大带宽”这一 3D 独特优势,还是只是营销标签。
混合键合与 3D 堆叠不会一蹴而就,但方向确定——在微缩变贵、算力需求暴涨的时代,它是少数能同时给出密度、带宽与功耗改善的路径。真正的分水岭,是良率与成本曲线何时让它从“旗舰专属”变成“主流可选”。
常见误区
- 把混合键合等同于普通 3D 封装:差别在无焊料、铜-介质直接融合与亚微米/微米级间距。
- 认为层数会很快堆到很多层:良率、KGD 与散热决定节奏是渐进的。
- 只看堆叠密度不看热:散热往往是真正天花板。
- 忽视良率相乘效应:层数越多对单层良率要求越苛刻。
- 以为 HBM 已全面转向混合键合:现阶段主流 HBM 仍以微凸点/TC-NCF 等为主,混合键合是后续演进方向。
总结
混合键合用铜-介质直接融合取代焊料凸点,把互连间距压到微米级,是 3D 堆叠兑现高密度、短互连、低功耗的关键工艺;形态从“缓存叠逻辑”(3D V-Cache)走向逻辑对逻辑(SoIC/Foveros)与未来的逻辑叠内存。真正的瓶颈不是“能不能叠”,而是表面/对准工艺、KGD 与乘法良率、以及多层散热,产业因此采取从两层高确定性形态起步、逐步加复杂度的路线。