合成数据产业
先说结论
- 真实高质量数据有上限,合成数据是主动“扩产”:用强模型、仿真器或规则生成带标签的样本,缓解稀缺、长尾和版权问题。
- 价值最明确的场景:自动驾驶/机器人的高保真仿真(危险与罕见场景)、长尾案例补齐、隐私脱敏后替代真实数据、以及不断翻新的评测题。
- 它不是免费午餐:纯靠模型输出再喂模型,可能放大偏差、导致分布塌缩(“近亲繁殖”);必须保留真实数据锚点、做严格验证与配比。
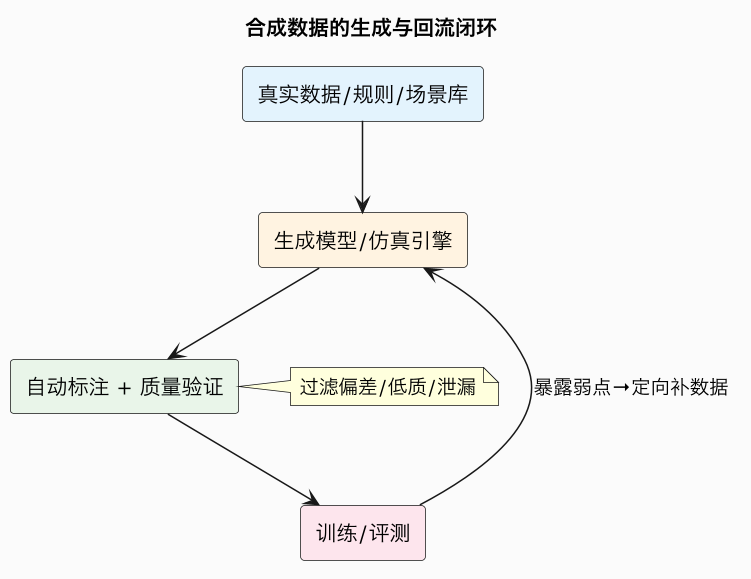
- 产业化在“生成—标注—验证—回流”闭环:合成平台、仿真引擎与数据服务商共同组成新的数据供给层。
一、合成数据的主要类型
| 类型 | 生成方式 | 典型用途 |
|---|---|---|
| 文本/多模态合成 | 强模型生成问答、摘要、图像 | 训练样本、蒸馏、增强 |
| 仿真环境数据 | 图形/物理引擎(带自动标注) | 自动驾驶、机器人 |
| 程序化/规则数据 | 模板、扰动、改写 | 结构化任务、长尾 |
| 隐私合成 | 对真实数据建模重采样 | 脱敏、合规共享 |
| 动态评测数据 | 实时生成新题 | 防刷榜、防污染 |
二、为什么现在火
- 数据墙:高质量网页文本增长见顶、获取成本和版权诉讼上升;
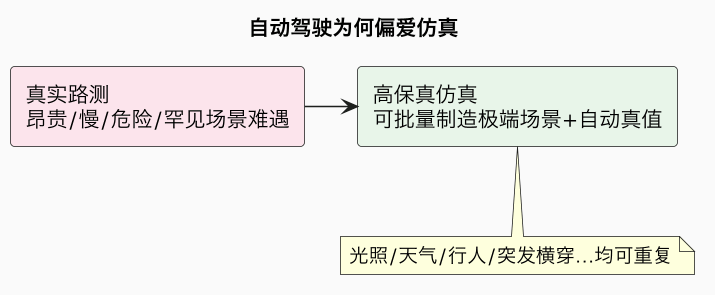
- 长尾昂贵:罕见危险场景在真实世界难以采集,仿真可批量制造;
- 标签便宜:仿真/生成天然知道正确答案,省去大量人工标注;
- 模型已足够强:生成质量高到可用于“教师→学生”的蒸馏。
三、风险:模型“近亲繁殖”
若用模型自身产出反复训练后继模型:
- 误差累积:教师的偏差被学生继承并放大;
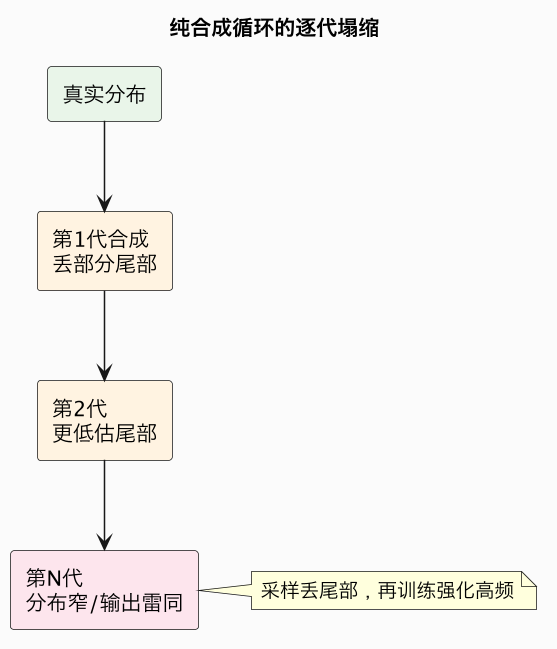
- 分布塌缩(model collapse):多样性逐代流失,输出趋于雷同、尾部消失;
- 现实感丢失:缺少真实世界分布作为锚点。
因此稳健做法是真实数据打底、合成数据增强,控制配比并持续在真实数据/人工偏好上评测。
四、质量管线:合成≠可直接用
- 针对短板定向生成(哪些场景模型最差就补哪些);
- 自动/人工双重验证标签正确性与多样性;
- 过滤泄漏(别把评测题造进训练集)、去重、控偏;
- 小流量试验后再规模化,监控是否过拟合合成分布。
五、产业玩家分层
| 层 | 提供 | 形态 |
|---|---|---|
| 生成平台 | 文本/图像/代码合成、蒸馏工具链 | SaaS / API |
| 仿真引擎 | 物理/图形仿真、传感器模拟 | 平台 + 工具 |
| 数据服务 | 合成+人工混合标注、验证外包 | 服务 |
| 云/大厂 | 算力与端到端数据工厂 | 云方案 |
六、与隐私、监管的关系
- 合成可在不暴露个体信息前提下保留数据统计特性,利于合规共享,但“再识别风险”仍需技术评估;
- 对合成内容的标识、来源与版权,监管框架正在成形;
- 用合成数据训练的模型责任归属仍有灰色地带。
七、深度专题:合成数据为何会导致“模型塌缩”
合成数据最大的风险——分布塌缩(model collapse),是一个反直觉但已有大量研究讨论的现象,值得专门讲清其机理,因为它直接决定合成数据“能不能大规模单独使用”。
1. 塌缩是怎样逐代发生的
设想用模型生成的数据再训练下一代模型,循环往复:
- 第一代合成数据大体复制了真实分布,但会丢失一部分低概率尾部(罕见样本本就很少被生成);
- 下一代模型主要见到这些数据,进一步低估尾部,生成时更偏向高频模式;
- 逐代累积,分布越来越窄、输出越来越雷同,模型逐渐“忘记”真实世界的多样性,甚至开始把自己早期的误差当成规律放大。
本质原因是:采样会丢尾部,再训练会强化高频——纯自反馈循环缺少把分布重新拉回真实世界的锚点。
2. 为什么这是“近亲繁殖”
和生物近亲繁殖类似:基因池(数据分布)不引入外部多样性,隐性缺陷(模型偏差)在代际间被放大。即使每一代单看质量不错,多代之后模型也会变得平庸、同质、对长尾失效。
3. 正确的配比与锚定
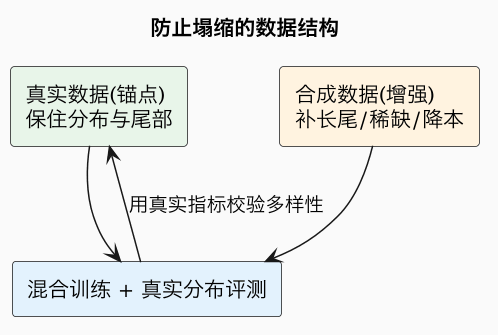
稳健实践是:真实数据打底、合成数据定向补充,持续在真实留出集/人类偏好上监控多样性与尾部表现,并限制“连续多代纯合成”的深度。合成数据的价值因此不是“替代”,而是“在真实锚点上做加法”。
八、合成数据的“质量工厂”:生成只是第一步
产业里真正的壁垒不在“能生成”,而在一套保证数据可用的质量工厂,其流水线类似传统软件的 CI:
| 阶段 | 关键动作 | 不做的后果 |
|---|---|---|
| 定向 | 针对模型最弱场景生成 | 数据量增、能力不增 |
| 标注 | 校验生成标签/真值 | 错误标签污染训练 |
| 多样性控制 | 去重、覆盖分布、控偏 | 重复过拟合、塌缩 |
| 防泄漏 | 隔离评测题 | 刷分、评测失效 |
| 验证 | 小批量训练看增益 | 规模化后才发现无效 |
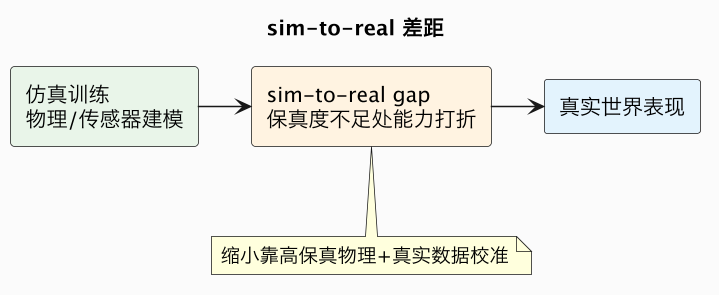
这解释了市场分化:人人都能调用强模型“造数据”,但只有建立严格生成—验证—回流闭环、能证明数据带来真实增益的公司,才能卖出溢价。对自动驾驶/机器人,还要额外跨越 sim-to-real gap——仿真物理保真度不足时,合成数据训练的能力迁移到真实世界会打折。
九、需求驱动:哪些力量在加速合成数据产业
- 数据墙与版权:高质量真实文本见顶、采集面临诉讼,合成可绕开部分限制;
- 长尾昂贵:自动驾驶危险场景、行业罕见案例靠真实采集几乎不可行;
- 蒸馏经济:强模型当“教师”批量造带标签样本,训练便宜的“学生”;
- 隐私合规:合成可在不暴露个体前提下保留统计特性(但仍需评估再识别风险);
- 评测军备:动态生成新题防止刷榜,让合成数据成为“裁判生产线”。
这些力量共同把合成数据从“研究技巧”推成独立产业层,玩家包括生成平台、仿真引擎、数据服务商与云的数据工厂方案;但其长期价值始终由质量管线和真实锚点决定,而非单纯生成规模。
十、评测即产业:合成数据在“裁判”环节的特殊价值
除了“当燃料”,合成数据还在模型评测环节形成一条快速增长的产业线,且逻辑与训练数据不同。
1. 为什么静态题库会失效
- 一旦评测题进入训练集(数据污染)或被刷榜机构反复研究,分数就不再反映真实能力;
- 现实任务不断变化,固定题库覆盖不了新场景;
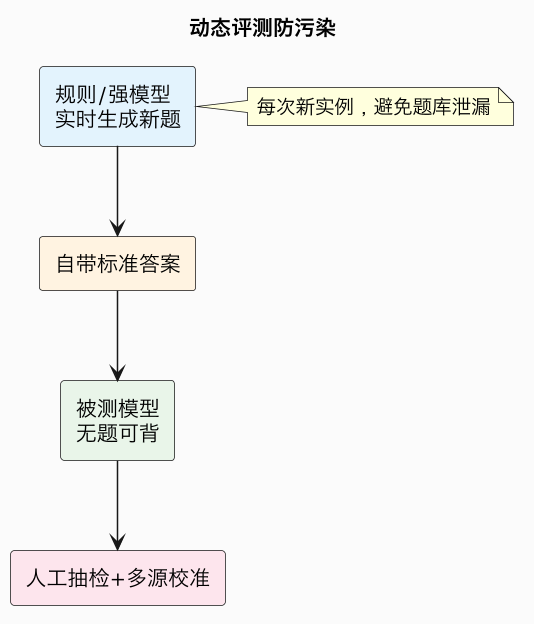
- 合成数据可以实时生成全新题目,让模型“没有题库可背”,更接近真实泛化测试。
2. 动态评测的设计要点
- 可控难度:按规则生成由易到难、覆盖特定能力(推理、长文档、工具调用)的题;
- 自带标准答案:程序化/强模型生成时就产出可判分的真值;
- 抗污染:每次生成新实例,避免题目泄漏;
- 仍需校准:生成题本身可能有偏,需人工抽检并用多来源交叉验证,防止“裁判偏置”。
十一、隐私合成与企业内部数据变现
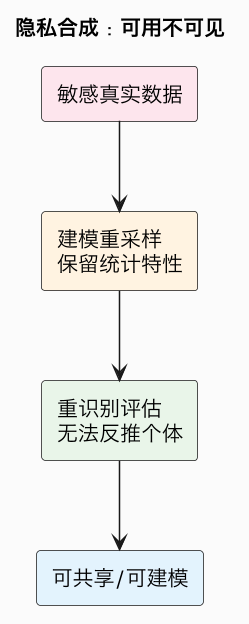
在强监管行业(金融、医疗、政务),合成数据还有一个独特价值:在不暴露真实个体的前提下,让数据可共享、可建模。
| 方式 | 做法 | 价值 | 残留风险 |
|---|---|---|---|
| 全合成 | 学习真实分布后重新采样 | 可对外/跨部门共享 | 统计失真、可能泄露 |
| 部分扰动 | 对敏感字段匿名/扰动 | 保留更多实用性 | 再识别风险较高 |
| 仿真 | 构建业务仿真环境 | 可自由试验策略 | 与真实差距 |
技术上必须做重识别(re-identification)评估,确认攻击者无法通过合成样本反推真实个体;合规上则要满足各地数据保护要求。对企业,这打开了“数据可用不可见”的协作空间——既能让模型受益于内部敏感数据,又不突破隐私红线,是合成数据在 B 端最务实的落地方向之一。
综合来看,合成数据产业的版图包含燃料(训练)、裁判(评测)、脱敏(合规共享)三条主线,它们共同的底层规律是:价值由质量、真实性锚点和可信验证决定,单纯“能生成”不构成壁垒。
十二、给读者的判断框架
- 判断合成数据价值,先看它是否带来真实可测的能力增益,而非生成规模。
- 设计方案,坚持“真实数据打底、合成数据增强”,用真实留出集守住分布与尾部,严防塌缩。
- 看待产业版图,区分燃料(训练)、裁判(评测)、脱敏(合规共享)三条主线,它们门槛与逻辑不同。
- 评估公司壁垒,重点看“生成—验证—回流”的质量工厂与 sim-to-real 能力,单纯会调用强模型不构成护城河。
合成数据是 AI 缓解数据墙、版权与长尾难题的关键供给,但其价值高度依赖质量管线和真实性锚点;它不会简单替代真实数据,而是在真实地基上做精准加法,这一认知决定了企业能否真正用好这条新兴产业。
常见误区
- 认为合成数据可完全替代真实数据:缺少真实锚点会导致塌缩。
- 生成即高质量:标签错误、偏差和重复都需过滤。
- 只看数量不看多样性:重复样本无益、反而过拟合。
- 忽视仿真到现实的差距(sim-to-real gap):物理保真度不足会使迁移打折。
- 把合成评测当绝对客观:生成器本身也可能带偏。
总结
合成数据用强模型与仿真引擎主动扩张数据供给,在长尾、仿真、隐私脱敏和动态评测上价值突出,是缓解真实数据墙与版权风险的关键产业;但纯合成循环会引发误差放大与分布塌缩,必须以真实数据为锚、严控生成质量与配比。行业正形成“生成—验证—回流”的数据工厂闭环,其成熟度取决于质量管线,而非单纯生成能力。