大模型训练系统:Megatron 与 3D 并行
一句话回答
万亿模型靠“3D 并行”摊到万卡上:数据并行在各卡分数据、张量并行把单层矩阵切到 NVLink 域内几卡、流水线并行按层分到不同卡并用 micro-batch 填气泡;Megatron-LM 把三者正交组合,再配序列并行、分片优化器(ZeRO)和专家并行。分层原则是通信最重的张量并行放在机柜内,流水线/数据并行向外扩展,而万卡真正的难点还包括频繁故障与 MFU(算力利用率)。
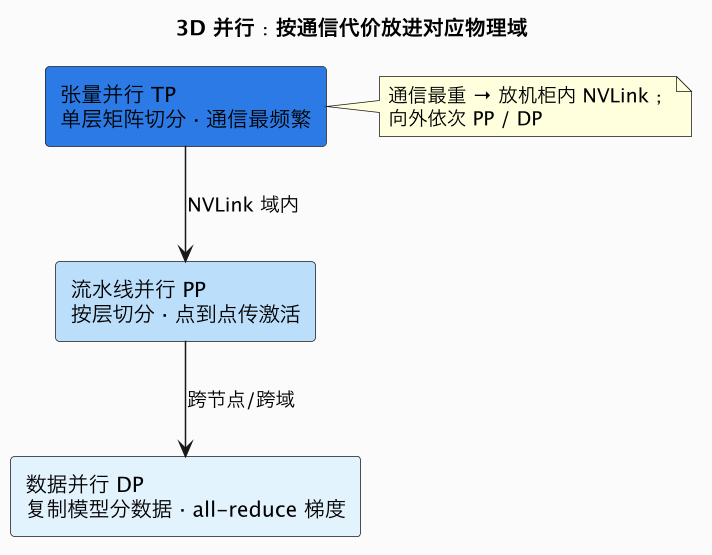
3D 并行的精髓,是把三种切法放到最匹配的物理层级——通信越重,越要紧靠 GPU:
一、三种并行
| 并行 | 切什么 | 通信 | 典型范围 |
|---|---|---|---|
| 数据并行 DP | 分数据,模型复制 | all-reduce 梯度 | 跨域 |
| 张量并行 TP | 单层权重矩阵 | all-reduce/all-gather,频繁 | 节点/机柜内(NVLink) |
| 流水线并行 PP | 按层切分 | 点到点传激活 | 跨节点 |
- TP 通信最频繁、量最大,必须放在高带宽低延迟的 NVLink 域,通常 2/4/8 卡;
- PP 把层分段,相邻段传激活,存在“流水线气泡”,用多个 micro-batch 交错填满。
这里展开讲清每种并行的代价。数据并行最直观:每张卡都持有完整模型副本、各吃一部分数据,算出各自梯度后,必须通过 all-reduce 把所有副本的梯度同步成一致,再各自更新。它的优点是实现简单、对模型结构无侵入,扩展方式就是加副本;瓶颈在于每卡都要装得下整个模型,且梯度同步通信随卡数增长。张量并行解决的是「单层都装不下」的问题:把某一层的大矩阵按行或列切成几块放到不同卡,一次前向/反向需要卡在 all-gather 和 reduce-scatter 之间频繁交换中间结果。这种切分的通信量极大、且发生在每层内部,因此对带宽和延迟极度敏感,必须限定在 NVLink/NVSwitch 这种高带宽域内,一旦跨普通网络,时间几乎全耗在通信上。流水线并行则是按层把模型纵向切段,不同段放不同卡,前一段的输出激活传给下一段;它通信量小(只需相邻段点到点传激活),但会产生「气泡」——某段在算时其他段在等,像流水线开工不足,标准解法是把一个 batch 再细分成多个 micro-batch,让它们交错进入流水线以填满空闲工位。
二、为什么是 3D
二维切到极限后某一维会过大(如纯 DP 要求每卡装下整个模型)。三维正交切分让每卡只持有模型的一小块,同时把通信限制在最适合的物理层级,从而线性扩展到上万卡。
这里的核心思想是「让切法与物理网络层级匹配」。通信最重、最频繁的张量并行紧贴 GPU 放进 NVLink 域(通常一个节点/机柜内的 2~8 卡);通信中等的流水线并行跨节点、按机柜或更大范围切段;通信相对规律、可用计算与通信重叠掩盖的数据并行则向最外层跨域复制。三种切法正交组合后,模型在三个维度上同时被缩小,单卡只需持有参数的一小部分,既能装下超大模型,又能把不同量级的通信分别放到带宽匹配的链路上。这正是 Megatron-LM 3D 并行能把训练规模从几百卡推到上万卡的关键——它不是简单堆卡,而是一整套「按通信代价分层映射」的系统工程。
三、配套机制
- ZeRO / 分片优化器:把优化器状态、梯度、参数分片,等价于更灵活的 DP;
- 序列并行:切 LayerNorm/dropout 的激活,省显存;
- 专家并行:MoE 把不同专家放不同卡;
- 重计算(activation checkpointing):用算力换显存;
- 容错:万卡年故障率高,需检查点周期保存、快速重启、坏卡隔离,否则有效训练时间被严重侵蚀。
这几项配套解决的是 3D 并行之外、却决定真实效率的问题。ZeRO/分片优化器本质上是对数据并行的细化:传统数据并行下每张卡都重复保存一份优化器状态和参数,冗余很大;ZeRO 把优化器状态、梯度乃至参数按卡分片,需要时再 all-gather 取回,从而在不牺牲通信效率的前提下大幅省显存,让大模型用更「省」的数据并行就能装下。序列并行针对 LayerNorm、dropout 这类在张量并行下仍被各卡重复保存的激活,把它们也沿序列维度切分,进一步降低显存占用。专家并行服务于 MoE:把不同专家分布到不同卡,配合路由和 all-to-all 通信实现稀疏激活。**重计算(activation checkpointing)**则是用算力换显存——不保存中间激活、在反向时按检查点重新计算,从而以一定的额外算力换取装下更大模型的空间。
容错在万卡规模下尤其关键,原因是概率。单张卡、单条网络在一年里故障率不高,但当集群扩到上万卡、训练持续数月,「每天都可能有卡、链路或节点出问题」就成为常态。如果没有周期性检查点、快速重启和坏卡自动隔离,一次故障可能让几小时甚至几天的训练作废,有效训练时间被严重侵蚀。因此大规模训练比拼的早已不只是理论算力,而是故障多快能恢复、检查点多密、调度多智能这些系统可靠性能力。
常见误区
- 以为加卡就能近线性加速:通信、气泡、负载不均和故障使 MFU 远低于峰值。
- 把 TP 跨节点:带宽不够,性能崩塌,应限定 NVLink 域。
- 只看显存不看通信模式:不同切法通信量差异巨大。
- 忽视故障恢复:超大集群每天都可能有卡/网络故障。
- 混淆 ZeRO 与 TP 的用途:前者偏状态分片、后者单层计算切分。
- 只盯峰值算力、不算有效产出:真正该看的是 MFU/HFU,即真正用于有效计算的比例,通信、气泡、重算和停机都要从峰值里扣除。
- 忽视负载均衡:专家热点、micro-batch 分配不匀都会让部分卡成为短板,拖慢整条流水线。
八点五、通信开销如何被掩盖
3D 并行引入大量集合通信,但高效训练系统不会让 GPU 干等通信完成,而是用几种机制把通信成本尽量藏起来:
- 计算与通信重叠:把梯度同步、all-reduce 等通信操作安排在 GPU 继续计算其他部分的同时进行,使二者在时间上交叠,理想情况下通信的额外时间被计算掩盖。
- 拓扑感知调度:按物理网络的实际带宽和层级安排并行维度与通信伙伴,让大通信走宽链路、小通信就近完成,避免跨域拥塞。
- 梯度分桶(bucket):不等到全部梯度算完再一次性同步,而是算好一部分就开始异步传输,进一步压缩通信暴露的时间。
- 高效集合算法与内核:针对特定拓扑实现 ring、tree 等 all-reduce 算法和融合内核,减少通信的启动次数与冗余数据量。
需要强调的是,重叠并不能让通信免费——当通信量本身超过物理带宽、或链路被多个作业争抢时,再精巧的调度也无法完全掩盖,MFU 仍会下降。这就是为什么并行配置必须和具体集群的网络能力匹配,而不能只在理论上算切分。
九点五、万卡集群的工程现实
把规模推到上万卡后,训练成功与否越来越取决于模型之外的系统能力,可以归纳为几个现实挑战:
- 故障是常态而非例外:如前述,万卡集群每天都可能出现 GPU、链路、节点或存储故障。衡量系统好坏的关键是平均恢复时间(从故障到恢复训练的时长)以及检查点损失的工作量。
- 存储与数据供给:上万卡高速消耗数据,如果数据加载、预处理和存储吞吐跟不上,GPU 会因等待数据而空转。高性能并行存储、数据预取和缓存因此与网络同等重要。
- 调度与碎片:如何把一个需要几千卡的作业高效铺到集群、减少资源碎片、并与其他作业共存,是调度系统的核心难题。
- 可观测与诊断:大规模下性能退化和故障往往不是单点,需要细粒度的监控来定位是哪一层、哪条链路、哪个节点拖了后腿。
- 软件栈协同:驱动、通信库、框架、编译和内核必须版本匹配并针对硬件优化,任何一环不匹配都可能让上万卡的理论算力大打折扣。
正因如此,前沿大模型训练被视为当今最复杂的系统工程之一:决定一个模型能否按时、按预算训成的,往往不是谁买到了最多卡,而是谁能把并行策略、网络拓扑、存储供给、故障恢复和调度监控整合成一个高 MFU、高韧性的整体。理解这一点,才算真正理解了「万卡」二字背后的分量。
总结
Megatron 的 3D 并行用 DP 分数据、TP(NVLink 域内切矩阵)、PP(按层切、micro-batch 填气泡)正交组合,把万亿模型摊到万卡,辅以 ZeRO、序列/专家并行、重计算与周期检查点;扩展成功的真正指标是 MFU 与故障恢复,而非简单堆卡,分层时务必让通信最重的张量并行紧贴高带宽域。还应记住,万卡训练是一整套系统工程:通信要靠重叠和拓扑感知掩盖、数据供给和存储不能拖后腿、故障恢复和调度监控决定有效训练时间,软件栈各层必须协同。真正拉开差距的,是谁能把这些环节整合成高 MFU、高韧性的整体,让上万张卡的理论算力稳定地转化为模型能力,而不是停留在「卡多」本身。还需强调,3D 并行的具体参数(TP/PP/DP 各取多少、micro-batch 数、检查点间隔)没有放之四海皆准的配置,必须结合模型结构、集群网络和实测 MFU 反复调优;任何一个维度配比失衡,都可能让通信或气泡成为新的短板。因此真正成熟的训练团队,会把这些参数当作需要持续实验的系统变量,而非一次性设定后就不再调整。可以说,万卡训练的核心竞争力,正是在长期实践中积累出的、让硬件效率和系统韧性同时最大化的调优经验。对刚接触大规模训练的团队,一个常见误区是把通信开销当作单纯的网络问题,实际上它与并行维度的选择、micro-batch 的切分、检查点的频率乃至数据加载的节奏都彼此牵连,牵一发而动全身。因此更有效的做法不是孤立优化某一项,而是把训练任务当作一个需要整体观测的系统:先用细粒度监控看清 GPU 在每个时间段究竟是在计算、通信还是等待,再针对最长的那段空闲动手。当团队能稳定地把计算、通信和数据供给交织成一条高占用率的流水线时,MFU 的提升往往比单纯更换更快的硬件更显著。这也解释了为什么同一批 GPU 在不同团队手里,最终能转化出的有效训练时间会相差悬殊——差距主要不在资源,而在把整个系统调顺的工程功力,而这种功力只能靠长期实践、细致观测和反复迭代逐步积累,无法靠一次性的硬件采购速成,它考验的是团队长期沉淀下来的系统工程素养。值得补充的是,优秀团队在每次大训练结束后都会做一次复盘:把整段运行里计算、通信、等待的时间分布沉淀下来,对照上一次的配置找出新的瓶颈,再把结论写回并行参数和监控规则里。正是这种“训练—观测—复盘—再调优”的闭环一次次重复,才让 MFU 和故障恢复速度持续抬升。对资源有限的后来者,与其追求一步到位的配置,不如先把这条复盘机制建立起来,它往往是性价比最高的起点。