CUDA 护城河到底有多深:从编程模型到算子库的迁移成本
最后更新:2026-09-19|数据截止 2026 年中:本文讨论的是软件生态结构与迁移成本的定性判断,不给出具体迁移工时或性能折损百分比(因负载差异极大);各框架与兼容层的支持范围以官方最新文档为准。
本文是产业观察,回答:为什么硬件参数被追近,英伟达的地位却没有同步动摇,CUDA 这道「软件墙」到底深在哪、有没有可能被绕开。 国产 AI 芯片与算力管制 把软件生态列为管制之外的「第四道墙」,英伟达 AI 产品矩阵 讲了硬件与整柜的锁定;本文专门量化和拆解软件这道墙的分层结构,以及 ROCm、oneAPI、Triton、国产 CANN/MUSA 各自能挖到墙的哪一层。
先说结论
- CUDA 不是一门语言,而是一整套「硬件抽象 + 算子库 + 框架 + 工具 + 人才 + 时间」的生态。 真正难替的不是
kernel<<<>>>语法(那层很薄),而是十几年沉淀的高度优化算子库、成熟调试分析工具、默认假设 CUDA 存在的框架与无数生产环境代码。 - 护城河是分层的,越往下越难替。 上层新写的训练/推理代码(用 PyTorch、Triton)相对可移植;中层依赖 cuBLAS/cuDNN/TensorRT 等库,可替换但要补性能与覆盖;底层手写 CUDA kernel、多卡通信(NCCL)、长期调优和私有扩展,是迁移最贵、最痛的部分。
- 不同对手挖墙的策略不同。 ROCm/oneAPI 走「开放标准 + 兼容」,Triton 从上层把 kernel 编写硬件中立化,国产 CANN 走自主全栈、MUSA 走 CUDA 兼容;它们分别在不同层取得进展,但没人能一夜之间复刻整套生态。
- 负载决定可迁移性:新代码、推理、单一模型部署较易迁;有大量手写 kernel、深度依赖多卡通信库、追求极致 MFU 的大规模训练最难迁。 墙不会被某次发布推倒,而是被「替代硬件够多 + 上层抽象成熟 + 迁移工具完善 + 客户有强烈意愿」长期侵蚀。
一句话:CUDA 护城河的深度不在语法,而在十几年时间、海量被验证过的代码和几百万开发者的默认选择;它不是不可战胜,但战胜它需要的不是一门替代语言,而是一个同样厚、且有人持续用的完整生态——这是时间和网络效应的壁垒,比单颗芯片的参数差距更难追。
一、先拆墙:CUDA 生态到底是几层
把 CUDA 理解成「在英伟达 GPU 上写并行程序的 C++ 扩展」是最常见的误解。它实际是一个分层的栈,每一层都积累了十几年的工程资产。
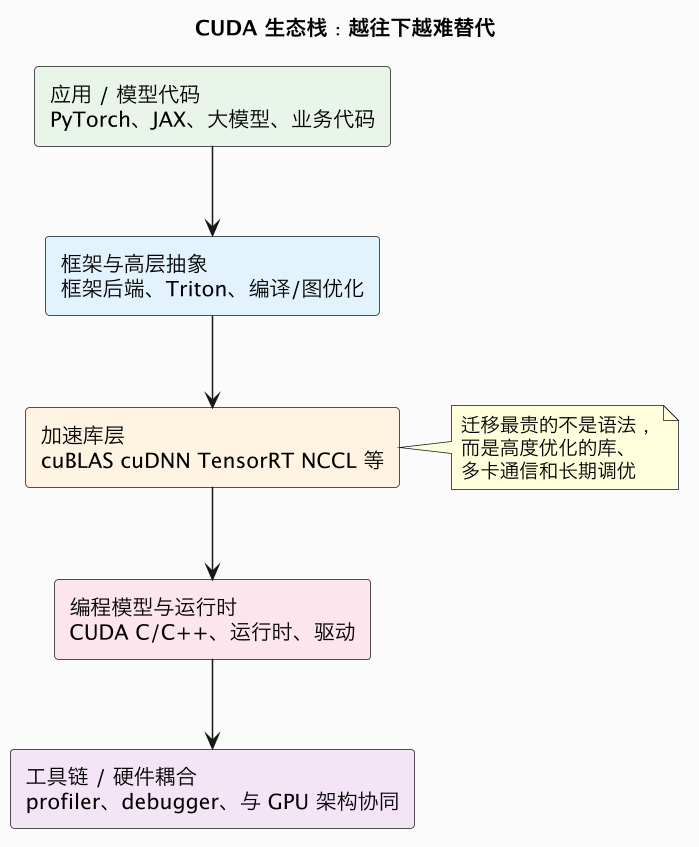
逐层看,壁垒来自哪里:
- 应用与模型层(相对好迁):今天大量新代码直接写在 PyTorch、JAX 这类高层框架上,开发者甚至不直接写 CUDA。理论上只要框架支持新后端,模型代码改动有限——这是替代硬件最现实的切入口。
- 框架与编译层(在被抽象化):Triton(OpenAI 主导的开源语言,用接近 Python 的方式写高效 GPU kernel) 让开发者写一份 kernel,由编译器映射到不同后端,正在把「写 kernel」这件事从 CUDA 专属变得更硬件中立;各家后端也在持续接入。
- 加速库层(最硬的资产):cuBLAS(高度优化的线性代数/矩阵乘)、cuDNN(深度学习原语库:卷积、归一化、注意力等)、TensorRT(高性能推理优化与部署引擎)、NCCL(多卡/多机集合通信库)等,是无数框架和模型默认调用的地基。它们针对每代英伟达架构手工优化了十几年,性能与覆盖极完整,替换不是「有没有等价物」,而是「能不能同样快、同样稳、边角算子全不全」。
- 编程模型/运行时(薄但无处不在):CUDA C/C++ 本身不难学,难的是存量代码里大量手写 kernel、内联 PTX(GPU 汇编)、版本依赖和对特定架构的假设。
- 工具链与硬件协同(隐性壁垒):Nsight 等性能分析与调试工具、驱动成熟度、与 NVLink/NVSwitch 整柜的协同(见 英伟达 AI 产品矩阵),决定了大规模训练能不能被高效诊断和调优,这是生产环境极看重、却最容易被低估的一层。
核心结论:越靠近「模型怎么搭」的上层越可替代,越靠近「怎么把硬件压榨到极致」的下层越难替代。 所以「CUDA 代码不难兼容」和「CUDA 生态无法短期替代」两句话都对——它们说的是不同层。
1.1 为什么这堵墙靠砸钱也难速成
生态壁垒和制造壁垒是两种东西。建一座晶圆厂,资本和设备到位后产能可以在数年内形成;但复制 CUDA 生态,钱不能直接变成「时间」和「网络效应」。
- 被生产环境验证过的代码,是十几年事故堆出来的。 每个库函数在各种模型、各种 batch、各种精度下的边界行为与性能,都经过海量真实作业检验;替代库即便功能齐全,也要重新积累这份「在所有边角都可靠」的信任。
- 人才与默认选择的网络效应。 全球几百万 GPU 程序员的第一语言是 CUDA,教程、问答、开源项目、招聘都围绕它。客户选平台时,「招得到人、搜得到答案、踩过的坑有人填」是硬约束,这种网络效应自我强化。
- 同时移动的靶子。 兼容者追赶的是一个仍在高速演进的目标——英伟达每代硬件、每个库版本都在加特性,等兼容层追上旧版本,新特性又成了新差距。
- 硬件—软件协同设计。 CUDA 与英伟达 GPU 的架构、NVLink、整柜深度耦合,最优性能依赖对硬件细节的掌握,纯软件兼容层天然隔着一层。
这解释了一个现象:过去十年并不缺「CUDA 替代者」,但没有一个靠「也能跑 CUDA 代码」就翻盘。生态不是功能清单,而是时间、信任和网络效应的存量。
1.2 真要迁,企业通常怎么做
现实中的迁移很少「一步到位全换」,理性路径是分层、分负载推进:
- 盘点代码的 CUDA 依赖深度:纯高层框架代码、调用标准库的部分、还是含大量手写 kernel/PTX,决定迁移成本量级。
- 从推理和标准化负载切入:推理可用 ONNX/编译栈重新落地、对 NCCL 依赖低,是成本最低、见效最快的试验田。
- 用抽象层隔离硬件:通过 Triton、统一编译/运行时或厂商适配层,让同一份业务代码能下发到多后端,保留期权而非一次性押注。
- 建立可比较的基准:以端到端吞吐、延迟、单位成本、长时稳定性(而非单卡峰值)做同口径评测,再决定扩大迁移范围。
- 保留双栈过渡:前沿训练留在成熟生态,推理与受供给约束的负载迁移,逐步把团队经验和算子库沉淀到新平台。
这套方法论也反过来指明替代芯片厂商的发力点:降低的应是客户「整体迁移工程」的成本,而不仅是提供一张能跑 demo 的卡。
二、迁移成本到底花在哪
把一个真实 AI 工作负载从 CUDA 迁走,成本不是单点,而是几类叠加:
| 成本类型 | 具体内容 | 大小 |
|---|---|---|
| 代码改写 | kernel、API 调用、版本适配 | 中,可用兼容层降低 |
| 算子覆盖 | 缺算子要自研,尤其冷门/新算子 | 高,长尾最耗人 |
| 性能重调 | 同样算子在新硬件要重调优,追平效率 | 高,依赖经验工具 |
| 多卡通信 | NCCL 对应物、拓扑、集合通信效率 | 高(大规模训练尤甚) |
| 稳定性验证 | 长时间大规模训练的容错/一致性 | 高,需生产环境打磨 |
| 人才与惯性 | 团队熟悉 CUDA,招人/培训成本 | 中高,网络效应 |
其中最容易被低估的是长尾算子和大规模稳定性。一个模型 95% 的计算可能集中在少数几个大算子(矩阵乘、注意力),这些替代平台都能优化;但剩下 5% 由大量长尾算子组成,缺一个就要自研、调优、验证,迁移工作量恰恰堆在这「最后一公里」。而万卡级训练动辄连续跑数周,通信库效率和故障恢复的微小差距会显著放大到有效算力(MFU,Model FLOPs Utilization,模型实际算力利用率)上——这部分经验只能靠真实大规模作业积累,无法靠文档补齐。
按负载给可迁移性分档:
- 较易迁移:用高层框架新写的训练/推理、推理部署(尤其可用 ONNX/TensorRT 类流程重构)、单一模型、对峰值通信不敏感的中小规模任务。
- 中等:有部分自定义算子、中等规模多卡训练,需要补算子库与调优。
- 最难迁移:大量手写 CUDA/PTX kernel、深度依赖 NCCL 的超大模型万卡训练、追求极致 MFU 的旗舰集群、以及多年沉淀的私有 CUDA 扩展。
三、各路替代者,分别挖到墙的哪一层
没有单一替代者试图「重写一个 CUDA」,它们从不同层切入:
| 路线 | 主导/代表 | 打法 | 覆盖到的层 | 短板 |
|---|---|---|---|---|
| ROCm | AMD(开源) | 开放 GPU 计算栈,API 与 CUDA 近似、提供 HIP 移植层 | 中下层,较完整 | 库/工具/生态厚度与稳定性仍逊 |
| oneAPI | Intel(开放标准) | 跨厂商统一编程模型 | 中上层,跨硬件 | GPU 市场份额小,势能有限 |
| Triton | 开源/OpenAI 系 | 高层写 kernel、编译到多后端 | 上层(kernel 编写中立化) | 不解决全部底层库与通信 |
| CANN | 华为昇腾(自主) | 自建全栈 + 框架适配(MindSpore/PyTorch 适配) | 全栈自有闭环 | 第三方生态/开发者规模待长 |
| MUSA | 摩尔线程(兼容) | 兼容 CUDA 类代码、降低迁移门槛 | 快速承接存量代码 | 兼容深度/性能折损、需持续跟进 |
几个要点:
- ROCm 是 CUDA 之外最完整的开放栈,AMD 用 HIP(类似 CUDA 的编程接口与迁移工具)把迁移门槛压得较低,但在加速库完备度、调试工具、超大集群通信和多年生产稳定性上仍在补课;这也是 AMD 硬件性能够强、软件却仍是客户主要顾虑的原因。
- Triton 代表的是「向上抽象」这条最有力的长期侵蚀路径:当越来越多新算子用硬件中立的方式编写、由编译器下发到多后端,CUDA 在「新增代码」上的锁定会被持续削弱——它不直接替换底层库,却让未来的代码不再只属于英伟达。
- 自主派(CANN)与兼容派(MUSA)的取舍,在 国产 AI 芯片实战盘点 里已展开:CANN 上限高但要养生态,MUSA 上车快但壁垒浅、需不断追赶 CUDA 的演进。关键客户多在二者间按「自主性 vs 迁移成本」权衡。
- 框架是最大的杠杆点:PyTorch 等主流框架对多后端的支持(编译/接入层)成熟度,决定了上层应用能否低成本落到非英伟达硬件;这也是为什么「框架适配 + 主流大模型开箱即用」成为各家软件投入的重中之重。
判断:替代 CUDA 的现实路径不是「正面对标复制」,而是上层靠 Triton/框架多后端让新代码不再专属、中层靠开放库补齐算子、下层靠客户在真实集群打磨通信与稳定性、外加地缘与成本制造强烈迁移意愿。四股力合流,墙才会被一层层磨薄。
四、墙会不会塌:什么在加深、什么在侵蚀
护城河不是静态的,两股力量同时作用。
在加深墙的力量:
- 英伟达每代硬件都配新的库与架构特性(如与新数据格式、Transformer 专用加速、整柜网络协同),生态始终向前跑,兼容者要追移动靶。
- 整柜化把软件、网络、运维绑得更紧(见 英伟达 AI 产品矩阵),「开箱即最优」的系统差距扩大。
- 开发者网络效应:会 CUDA 的人最多、教程最多、坑被踩得最平,新负载默认先在 CUDA 上跑通。
在侵蚀墙的力量:
- 上层抽象:PyTorch 多后端、Triton、各类编译器让新代码更少直接绑定 CUDA。
- 推理时代:推理负载更标准化、对极致多卡通信依赖低于训练,且客户有极强的降本与多元供给动机(详见同批推理芯片篇)。
- 开放硬件 + 地缘:AMD/ASIC/国产芯片供给增加,出口管制反而制造了「必须迁移」的强制需求和试验场。
- 云厂商自研:超大客户有能力直接用自家栈对接模型,绕过 CUDA 的部分价值。
一个更微妙的事实是:英伟达自己也在部分消解「必须写 CUDA」的表层锁定——它主动拥抱 PyTorch 等高层生态、提供自动混合精度与图编译工具,让大量普通开发者不必直接写底层 CUDA。这看似在开放,实则是更高明的护城河策略:把价值和粘性下沉到自己独有的库、通信栈、整柜和开发者习惯里,让「不写 CUDA 的人」依然离不开 CUDA 生态。对替代者而言,这意味着即使让上层框架跑通了,真正难啃的仍是下面那层「不用直接写、却处处在用」的系统软件。
需要补充的是「成本不对称」:迁移成本是一次性的、可分摊的,而生态收益是持续的、随规模放大的。 当一个组织要采购成千上万张非英伟达卡时,哪怕迁移工程昂贵,摊到每张卡和每年电费上也可能划算;这正是出口管制和成本压力能强制催生迁移的原因。CUDA 护城河因此不是「迁不动」,而是「迁移动力是否大到超过一次性成本」——动力来自供给受限程度、价差和战略自主性,这三者在 AI 时代都在增强。
五、变量与置信度判断
- 未来 1~2 年(高置信度):CUDA 在最前沿大规模训练与默认开发者生态上仍占绝对主导;迁移主要发生在推理、标准化负载和有政策/供给压力的客户,替代平台靠「框架开箱即用 + 主流模型适配」争取这些场景。
- 未来 2~4 年(中高置信度):上层框架多后端与 Triton 类抽象显著降低新增代码的锁定;ROCm/国产栈在常用算子、工具和集群稳定性上明显改善,迁移的边际成本下降,但「最后一公里」长尾算子与万卡稳定性仍是分水岭。
- 未来 3~6 年(中置信度):形成「英伟达主导最高端训练 + AMD/ASIC/国产分流量推理与部分训练」的多极结构;客户普遍采用可跨硬件部署的抽象层,CUDA 从「唯一选择」变为「最强但可替代的选项」。
- 长期 / 低置信度:CUDA 是否被开放生态彻底中和,取决于替代硬件能否持续规模化、上层抽象能否吃掉底层差异、以及 AI 负载范式(是否一直是大规模 Transformer 训练)是否变化。
六、对不同角色,这意味着什么
- 对模型/应用团队:尽量把代码写在高层框架与硬件中立的算子层,隔离对 CUDA 的直接依赖,为未来跨硬件保留期权;现在就能在推理侧试点非英伟达后端。
- 对替代芯片厂商(AMD/国产):软件投入应优先于下一颗芯片的峰值参数——补齐常用与长尾算子、打磨多卡通信和稳定性、让主流大模型开箱即用,比跑分更决定客户敢不敢迁。
- 对云/大客户:自研栈与多后端兼容是议价工具;可在推理与非核心训练上构建第二供给,降低单一生态依赖。
- 对投资者:判断英伟达护城河,盯的是「新负载是否仍默认 CUDA」「上层抽象渗透率」「替代平台在真实大集群的稳定性」,而不是单卡性能对比。
结语:最深的墙是时间和默认选择
CUDA 真正的护城河,不是某一项别人做不出的技术,而是十几年时间、海量被生产验证过的优化库、工具、通信栈,和几百万开发者「默认就该这样写」的网络效应。它分层:上层应用正被框架和 Triton 中立化、相对好迁,下层手写 kernel、NCCL 多卡通信和极致调优仍极难替。因此 CUDA 不会被一门替代语言一夜推倒,而会在「上层抽象成熟 + 推理标准化 + 替代硬件规模化 + 客户被迫迁移」的合力下,从唯一选择逐渐变成最强但可替代的选项之一。看懂这道墙的分层,就既不会轻信「换个语言就能去英伟达化」,也不会误以为它是一道永远无法侵蚀的城墙。
数据口径与延伸
- 数据口径:CUDA 生态的分层结构、cuBLAS/cuDNN/TensorRT/NCCL 的定位、ROCm/HIP、oneAPI、Triton、CANN、MUSA 的路线差异、按负载区分的可迁移性,均为软件架构与公开生态的定性事实。本文不提供迁移人月、性能折损百分比等因负载而异、易被选择性引用的数字;各框架/兼容层对算子与后端的支持范围以官方文档为准。数据截止 2026 年中。
- 相关产业观察:国产 AI 芯片与算力管制(第四道墙)、英伟达 AI 产品矩阵(硬件/整柜锁定)、国产 AI 芯片实战盘点(CANN/MUSA 路线)、开源商业模式(开放生态如何挑战在位者)。
- 同批待写延伸:推理芯片专题(C8)、InfiniBand vs 以太网(D2)。
一句话总结:CUDA 的护城河不在
kernel语法而在整套分层生态——上层应用可借 PyTorch 多后端与 Triton 逐渐中立化,中层 cuBLAS/cuDNN 可换但要重补性能与长尾算子,底层手写 kernel、NCCL 多卡通信、长期调优与工具链是迁移最贵的部分;ROCm/oneAPI 走开放兼容、Triton 从上层抽离、CANN 自主全栈、MUSA 兼容上车,分别挖到不同层但都难复刻十几年沉淀,因此最现实的演化不是墙被推倒,而是在推理标准化、上层抽象、替代硬件规模化与地缘驱动迁移的合力下,CUDA 从「唯一选择」缓慢变为「最强但可替代的选项」,胜负取决于替代平台能否补齐最后一公里算子与万卡集群稳定性,而非语言本身。