光计算芯片:用光子做矩阵乘法,离替代 GPU 还有多远
最后更新:2026-09-28|数据截止 2026 年中:光计算属早期技术,玩家融资、原型与流片进展以各公司公开发布为准,本文用代际与量级表述,不引用未经证实的具体能效数字;技术成熟度判断(TRL 等级)为作者基于公开信息的推断。
本文是产业观察,回答一个容易被「光」字搞混的问题:光计算芯片(用光子做乘加运算)和硅光互连(用光子搬数据)是两条完全不同的路线,前者离商用远比后者远。 硅光互连/CPO 光引擎已经在 800G/1.6T 光模块里大规模出货(见 硅光互连与 CPO 光引擎、800G/1.6T 光模块),那是「通信」;本文讲的「计算」——让光本身完成矩阵乘法——还停在实验室到早期原型之间。它与 存算一体 同属「非冯·诺依曼算力」的备选路线,可对照阅读。
先说结论
- 光计算芯片的核心卖点只有一个:用光学器件直接做矩阵乘法,理论上把乘加能耗和延迟压到接近「光飞过器件」的物理极限。 大模型推理的本质是海量矩阵乘法,如果这一步能在光域以极低功耗完成,能效故事会比任何电子 ASIC 都性感——但「理论上」三个字后面跟着一长串工程代价。
- 光计算与硅光互连是两回事,成熟度差着好几个数量级。 硅光互连(光进铜退、CPO)解决「数据搬运」,已是千亿美元级的现实产业;光计算解决「数据运算」,全球还没有一款规模量产、被主流客户部署的光计算加速卡。把两者混为一谈,是这个赛道最常见的叙事泡沫。
- 精度是光计算的硬伤:光学乘加是模拟计算,有效精度普遍在 8bit 量级甚至更低,天然不适合训练,只能瞄准对精度容忍度高的推理场景。 而推理市场恰恰是 推理 ASIC 新赢家 和英伟达(产品矩阵)厮杀最凶、迭代最快的地方,光计算要插进来,窗口并不宽。
- 更现实的落地路径不是「光替代电做全部计算」,而是光电混合:光做大规模矩阵乘,电做非线性、归约和控制。 Lightmatter 等公司甚至把重心放在光互连/光交换产品上先变现,说明「光先搬数据、后做计算」的产业顺序大概率成立。
- 时间尺度判断:6 个月内看不到量产拐点,18 个月内观察少数标杆客户试点,36 个月以上才可能判断它能否在特定推理负载里占住一个生态位。 置信度:中高——技术方向真实,但商业化时点大概率晚于多数融资故事里的说法。
一、先把界限划清:光互连、光计算、光网络是三件事
「光」在 AI 算力产业链里出现得越来越频繁,但至少有三个完全不同的含义,混用会直接误判产业位置。
| 维度 | 光互连 / 硅光 CPO | 光计算 | 全光网络/光交换 |
|---|---|---|---|
| 用光做什么 | 搬数据(芯片间/板间传输) | 做运算(矩阵乘法) | 转发数据流(光路交换,不经过电) |
| 光替代的是 | 铜缆/电 SerDes | 晶体管乘加器 | 电子分组交换机的 O/E/O 转换 |
| 成熟度 | 已规模量产(800G/1.6T 模块出货中) | 原型/早期样机(TRL 1~2) | 数据中心内开始试点部署 |
| 代表力量 | 光模块厂、博通/英伟达 CPO | Lightmatter、曦智科技、灵明光子等 | Google Apollo、Lightmatter Passage 类 |
| 本文立场 | 见 硅光互连与 CPO | 本篇主角 | 顺带提及 |
光互连的逻辑是「光的传输损耗和带宽密度碾压铜」,所以机柜间、乃至机柜内的电连接在往光迁移——这是已经被订单验证的趋势。光计算的逻辑则激进得多:不只是搬数据,而是让数据在光域里直接完成乘加,不用变回电。这个跳跃大了一个量级,因为传输只需要光「保持形状」,计算却要求光「精确地相互作用」。
二、技术原理:怎样用一束光算矩阵乘法
矩阵乘法的核心运算就两个:乘法和加法。光学上恰好都有对应物。
乘法靠干涉。最经典的器件是马赫-曾德尔干涉仪(MZI,Mach-Zehnder Interferometer):一束光分成两路,在其中一路用相移器改变相位,再合束——两路光的相位差决定输出光强,效果等价于「输入光强乘上一个由相位决定的系数」。把 MZI 排成阵列、每个相移器写入一个矩阵元素,输入向量以光强编码从一端打进去,另一端的光强分布就是矩阵乘向量的结果。整个乘法过程不发生任何晶体管开关,光以光速穿过器件,一次完成。 另一条路线用微环谐振器(Microring Resonator, MRR):微型环形波导只对特定波长共振,给每个微环配一个波长通道,就能用波分复用在同一根波导里并行跑多路乘法,器件密度可以做得更高。
加法几乎是免费的:多路光合束时光强天然叠加,就是求和。
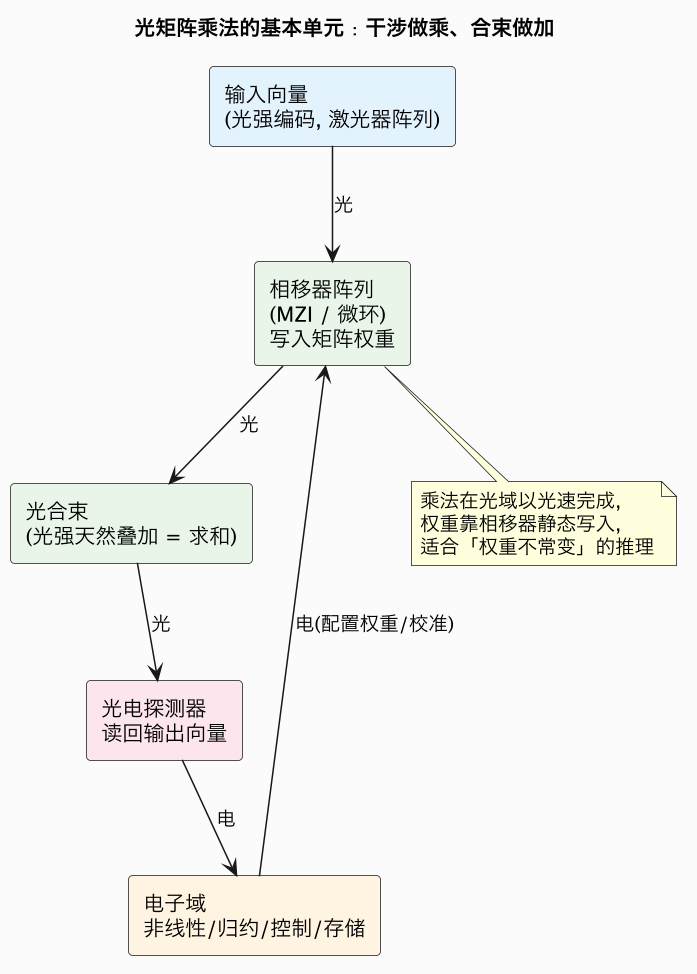
这张图同时暴露了光计算的两个结构性约束:
- 权重写入慢、读取快。 矩阵元素靠相移器配置,重新配置比电子 SRAM 改写慢且耗电(热调谐尤其如此)。这决定了光计算最适合「权重固定、输入狂飙」的场景——推理,而不是每步都更新权重的训练。
- 数模转换的「过路费」。 输入向量要从电转光(DAC+调制器),输出要从光转电(探测器+ADC)。矩阵不够大时,转换开销会吃掉光域省下的能量——光计算的能效优势只在大矩阵上才成立,小矩阵反而亏本。
三、与电子 GPU 和模拟存算放在同一张桌上比
光计算不是唯一的「后 GPU」叙事,把它和主流路线摆在一起,优劣势才看得清。
| 维度 | 电子 GPU / ASIC(数字) | 光计算(模拟光子) | 模拟存算(如忆阻器/ SRAM 模拟) |
|---|---|---|---|
| 计算精度 | 高(FP16/FP8/INT8 数字精确) | 低(模拟噪声,~8bit 量级封顶) | 低(器件非理想性,类似量级) |
| 能效潜力 | 基准(已被榨到每代 2~3 倍) | 理论最优(乘法近零能耗)但含转换开销 | 很高(省掉数据搬运) |
| 矩阵规模弹性 | 任意大(分块计算) | 受限于光器件阵列规模与串扰 | 受限于阵列规模与良率 |
| 可编程性/生态 | CUDA 级成熟(见 CUDA 护城河) | 几乎从零开始 | 几乎从零开始 |
| 制造 | 先进制程,成熟供应链 | 硅光工艺可复用 CMOS 产线,但光电混合封装难 | 新材料/新器件,良率爬坡中 |
| 成熟度 | 量产主力 | TRL 1~2 | TRL 2~4(部分模拟存算已有流片) |
值得注意的一个细节:光计算和模拟存算(存算一体篇)其实是同一类赌注的两种押法——都放弃数字精度换能效,都瞄准推理,都要重建软件栈。区别是存算押「存储器内计算」、光计算押「光速乘加」。它们面对的客户问题相同(推理 TCO),面对的敌人也相同(英伟达每年一代的能效进步)。历史上,挑战者的能效优势经常被在位者一两代产品抹平——这是评估光计算时最该警惕的动态。
四、玩家版图:谁在真做,做到哪一步
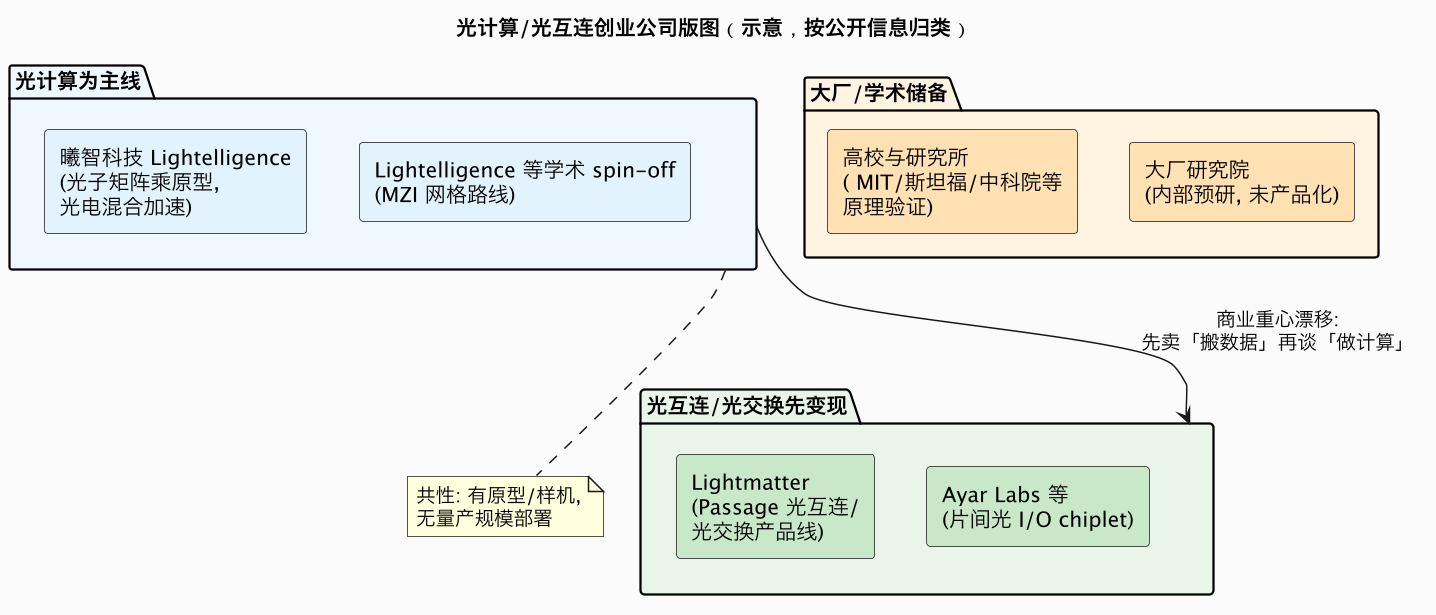
几个值得记住的观察:
- Lightmatter 的路径最有代表性:起家于光子计算,但最受市场追捧的产品是 Passage 这类光互连/光交换平台——用光把多颗芯片连成「一颗大芯片」。这侧面印证了本文的划分:「光搬数据」先商业化,「光做计算」还在后面排队。
- 曦智科技(Lightelligence) 是国内这条路线最知名的玩家,公开展示过光子矩阵乘的原型系统,路线是光电混合:光做乘加,电做其余。与多数同行一样,处于样机与早期客户验证阶段。
- 学术源头集中在 MIT(MZI 网格的奠基性工作)、斯坦福等,国内中科院系和几所高校也有持续产出。这个领域的论文到产品的转化周期,历史上以十年计。
- 与 AI 芯片全景 里的主流量产玩家相比,光计算公司没有一家进入「云厂规模采购清单」,这是衡量真实位置最硬的一把尺。
五、时间预期与置信度
| 判断 | 6 个月 | 18 个月 | 36 个月 | 置信度 |
|---|---|---|---|---|
| 光互连(CPO/光 I/O)继续放量 | 延续出货爬坡 | 进入更多平台 BOM | 柜内光渗透显著上升 | 高 |
| 光计算出现量产级推理加速卡 | 不会 | 极小概率 | 个别标杆客户试点可能 | 中 |
| 光计算在特定推理负载占住生态位 | 否 | 否 | 可能(边缘/超低功耗细分) | 中低 |
| 光计算对 GPU 训练市场构成威胁 | 否 | 否 | 否(精度硬伤未解) | 高(对「否」的判断) |
| 光计算公司估值叙事继续依赖「替代 GPU」 | 会,且有泡沫成分 | 随试点证伪/证实分化 | 行业出清或跑通其一 | 中高 |
给一个更直白的读法:未来 36 个月里,「光」字头的投资机会 90% 在互连侧,不在计算侧。 光计算值得跟踪的信号有三个:是否出现被头部云厂真实部署(而非实验室送样)的混合加速卡;光学乘加精度能否配合算法(量化感知训练、误差校正)摸到 INT8 等效;以及 Lightmatter/曦智这类公司计算产品线与互连产品线的收入结构变化——如果计算线长期不见收入,市场给出的答案就已经写在那儿了。
总结
光计算芯片用马赫-曾德尔干涉仪或微环谐振器在光域直接完成矩阵乘法,理论上能把乘加能耗压到物理极限,但模拟计算的精度硬伤(~8bit 量级)、权重写入慢和光电转换开销,决定了它只适合大矩阵、权重固定的推理负载,且当前成熟度停在 TRL 1~2、全球无量产部署;它与已经规模出货的硅光互连/CPO(「光搬数据」)是两条成熟度相差数代的路线,产业顺序大概率是互连先赢、计算殿后,Lightmatter 把重心放在光互连变现正是这个顺序的注脚——36 个月内看试点,36 个月以上才谈生态位,「替代 GPU」的叙事在当前时点应视为融资语言而非产业判断。