AI Agent 技术架构全景:模型、上下文、工具、运行时与工程治理
系列入口:AI 编程工具 | 新手先看 Agent 和聊天机器人的区别,想动手使用看 新手前 30 分钟。
Agent 不是一颗更大的模型,也不等于“会聊天的软件”。一个能完成真实任务的 Agent 系统,通常由模型、上下文、工具、运行时和工程治理共同组成:模型负责生成下一步意图,Harness(运行时外壳)负责组织信息、执行动作和维持循环,真实工具负责改变或观察外部环境。
本页用一张六层全景图和四张专项图建立整体认知,再把每层链接到站内的机制拆解与 mini-agent 实现。这里的分层用于组织知识,不代表所有产品都采用相同模块,也不意味着每个 Agent 都必须使用 MCP、RAG、多智能体或长期记忆。
本文要回答的问题
- LLM、Agent、Harness、工具和实际后端分别在哪里?
- 一次任务为什么需要“决策—执行—观察—再决策”的循环?
- Context、Memory、RAG、Rules 和 Compaction 如何分工?
- Function Calling、CLI、普通 API、MCP、Skill、Hooks 各在哪一层?
- 如何从架构概念继续走到 mini-agent 的真实代码?
一、总览:AI Agent 的六个技术层
读这张图先抓住主链:目标进入运行时,运行时组装上下文并请求模型,模型只返回文本或调用意图,工具接触真实环境,结果再回到运行时。 L5 不在主链末尾,而是横切整个系统:每一次读写、外联、花费和验收都可能受到它的约束。
六层各自解决什么问题
| 层 | 核心问题 | 典型失效表现 | 从下钻哪里开始 |
|---|---|---|---|
| L1 模型与推理 | 如何理解输入、生成文本与结构化意图 | 推理错误、输出不合 Schema、成本与延迟高 | Prompt 方法论 · LLM 应用工程 |
| L2 上下文与知识 | 每轮究竟让模型看到什么 | 忘事、读错文件、窗口爆炸、旧记忆误导 | 上下文工程 · 上下文压缩 |
| L3 工具与环境 | 如何把调用意图变成真实动作 | 参数错误、工具不存在、后端超时、越权访问 | Function Calling 工具系统 · MCP 协议 |
| L4 Agent 运行时 | 谁驱动循环、保存状态并决定停止 | 原地打转、重复调用、无法恢复、任务失控 | Agent Loop 解剖 · Harness 解析 |
| L5 工程治理 | 如何证明结果可靠并约束风险 | 误删、提示注入、质量退化、故障不可追溯 | 评测回归集 · 安全护栏 |
| L6 产品与应用 | 如何把能力组合成具体产品体验 | 工具选错、配置复杂、自动化边界不清 | Agent 实战 · 工具导读 |
一个简化但实用的关系是:Agent ≈ 模型 + Harness + 外部执行环境。Planning 可以是模型的一次决策,也可以是独立模块;Memory 可以只是消息历史,也可以外接存储;MCP 只是连接工具的一种标准协议,不是 Agent 的必备组成部分。
二、动态视角:一次任务怎样在 Agent 内部流动
静态组件只有串成闭环才成为 Agent。下面用“修复一个仿真报错并验证”的任务说明:模型不直接执行函数,Harness 也不替模型做业务判断,二者通过消息和真实反馈协作。
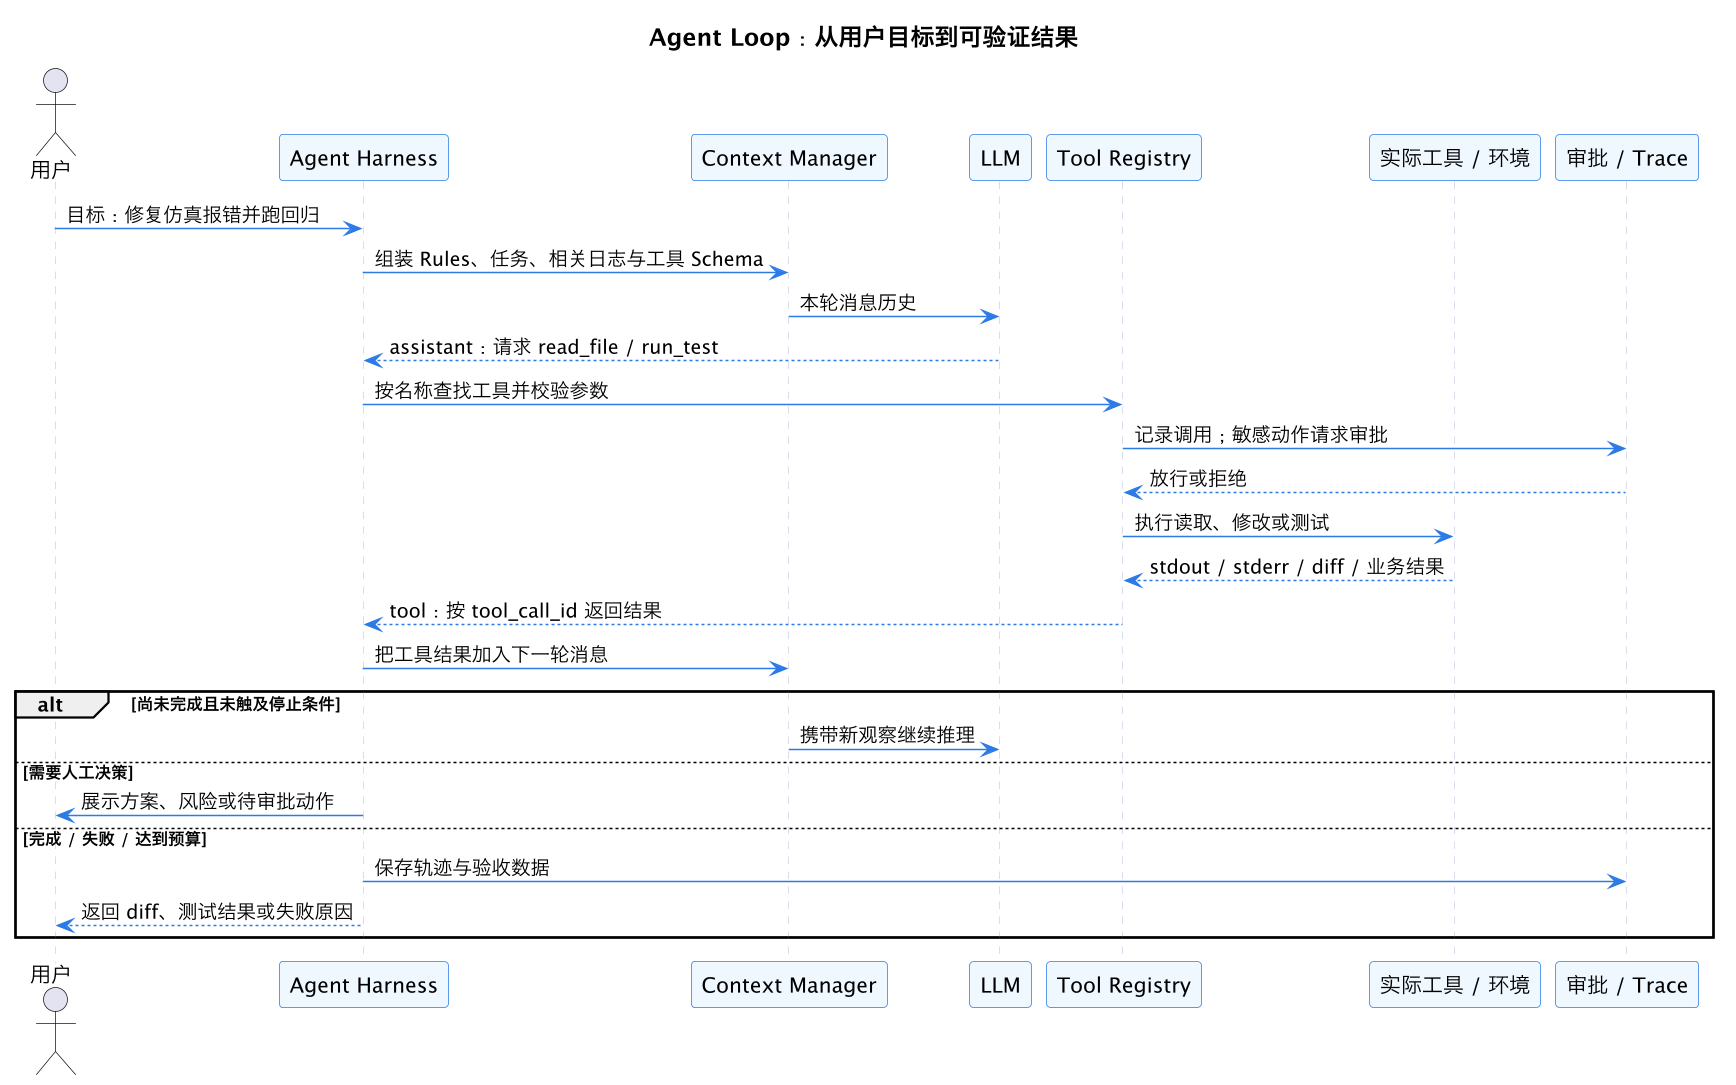
这张图里有三条不能省略的边界:
- 模型输出的是意图,不是执行结果。
tool_calls只表示“请求调用”,真正读取文件和运行测试的是 Harness 与工具。 - 观察结果必须回流。 没有工具输出进入下一轮上下文,模型就只能连续猜测,无法利用真实环境纠错。
- 循环必须有终止条件。 完成任务、需要人工决策、超过步数或预算、连续失败,都可能让循环停止,而不是无限“自主”下去。
Agent Loop 与固定 Workflow 的区别
| 对比项 | 固定 Workflow | Agent Loop |
|---|---|---|
| 下一步由谁决定 | 开发者预先写死 | 模型根据当前状态动态选择 |
| 分支与顺序 | 确定的图或状态机 | 可在运行中变化 |
| 可预测性 | 较高 | 较低,需要更多约束与评测 |
| 适合任务 | 稳定业务流程、审批链、批量 ETL | 开放式检索、调试、代码修复和探索 |
| 常见组合 | 用少量模型节点处理非确定性步骤 | 用状态机、预算和人工审批限制运行边界 |
实际系统经常混合两者:用 Workflow 管住不可逆的业务流程,用 Agent Loop 处理需要观察和试错的局部任务。 ReAct 是常见的循环范式,但不是唯一实现;Plan-Act、Reflexion、Orchestrator-Worker 都是在这个基本结构上增加规划、检查或编排。
三、Context、Memory、RAG:不是同一层“记忆”
模型本身不会主动记住上一轮发生了什么。Harness 每轮重新提供消息、状态和检索结果,才形成“它还记得”的表现。把这些信息来源分开,才能定位“失忆”到底发生在何处。
| 概念 | 回答的问题 | 存储与生命周期 | 不能混淆为 |
|---|---|---|---|
| Context | 本轮模型实际看到什么 | 一次模型调用的输入,受窗口预算限制 | 所有历史信息的完整集合 |
| Working State | 当前任务进行到哪一步 | 当前任务中的计划、变量和中间结果 | 跨会话用户偏好 |
| Memory | 哪些事实要留到以后 | 外部文件或数据库,可跨会话;需要更新与纠错 | 本轮全部上下文 |
| RAG | 如何从大量外部资料找到相关片段 | 离线索引 + 在线检索,结果选择性进入 Context | 记忆本身或无条件的事实保证 |
| Rules | 哪些行为约束长期有效 | 项目或用户配置,通常按产品机制加载 | 可随意改写的临时观察 |
| Compaction | 窗口不足时怎样压缩既有信息 | 截断、工具结果老化、摘要等运行时策略 | 从知识库发现新信息 |
继续下钻:上下文工程入门、规则与记忆文件、上下文压缩机制、RAG 架构。
四、工具连接:Function Calling、CLI、API、MCP 各在什么位置
“模型调用工具”只是意图表达。具体工具可以内置于 Host,也可以是一条本地命令、一个普通 API 或远程 MCP Server 后面的系统。Skill 和 Hooks 与这些连接方式不是同一类概念。
| 选择 | 更适合的情况 | 关键边界 |
|---|---|---|
| 内置工具 + Function Calling | Host 已有文件、搜索、测试等能力 | Schema 约束参数,Harness 负责真实执行 |
| CLI / 脚本 | 单用户、本地开发、开放探索和管道组合 | 不必为了统一形式额外包一层 MCP |
| 普通 API | 单一应用调用已有业务接口 | 稳定、直接,但没有统一的 Agent 能力发现约定 |
| MCP | 多客户端复用、团队共享能力、标准化连接外部系统 | 权限与审计仍需 Host、Server 和后端实际实现 |
| Skill | 把“怎样做一件事”沉淀成可复用方法 | 不是传输协议,也不一定是一段可执行代码 |
| Hooks | 在生命周期节点自动检查、记录或阻断 | 不是业务工具;硬约束不能依赖模型自觉 |
继续下钻:Function Calling 工具系统、MCP 的 Without / With 对照、Skill 与 Agent 分工、Hooks 机制。
五、从架构到代码:mini-agent 的三段实现路线
本站用一个只依赖 Python 标准库的教学工程,把运行时最关键的三段机制做成可运行、可追踪、可测试的代码。它不是功能完整的 Agent 产品,而是让读者能看清每个架构节点如何落地。
| 实现 | 对应架构问题 | 运行后能观察什么 | 教程 |
|---|---|---|---|
| M1 | 模型、工具与循环如何通过消息连接 | assistant/tool 消息配对、工具结果回流、循环终止 | Agent Loop 解剖 |
| M2 | 工具声明如何变成可靠执行 | 参数拒绝、只读并发、错误结构化回传、结果顺序 | Function Calling 工具系统 |
| M3 | 长会话如何在窗口预算内继续 | 压缩触发、消息保护、Token 变化、无法压缩时的硬失败 | Context 压缩机制 |
工程地址:github.com/derekzhuo/geek-doc.cn/mini-agent。模型适配器使用确定性脚本,因此读者观察的是可重复的 Harness 行为,而不是一次在线模型的偶然回答。
六、按目标选择阅读路径
| 你的目标 | 推荐顺序 |
|---|---|
| 第一次理解 Agent | Agent 与聊天机器人的区别 → 本页总图 → Agent Loop → 新手前 30 分钟 |
| 想自己实现 Agent | Agent Loop → 工具系统 → 上下文压缩 → mini-agent 工程 |
| 想把现有工具用好 | Harness → 上下文工程 → Plan 模式 → 结果验收 |
| 想连接内部系统 | 工具系统 → MCP 协议 → 客户端配置 → 内部 Server 边界 |
| 想处理复杂任务与多 Agent | Subagent 入门 → Orchestrator-Worker → Planner-Coder-Reviewer |
| 想做团队工程治理 | 权限最小化 → Hooks → Trace 与 LLM 工程 → 评测回归集 |
| 想研究具体产品实现 | Agent 实战 → Claude Code 教程 · Codex 配置 · CodeBuddy 指南 |
七、常见误解校正
| 误解 | 更准确的判断 |
|---|---|
| Agent 就是更强的 LLM | Agent 是模型、Harness、工具与治理组成的系统,模型只是其中一部分 |
| 所有 Agent 都有固定五大组件 | 功能划分因产品而异,简单 Agent 可以只有循环和少量工具 |
| 上下文就是长期记忆 | Context 是本轮输入;Memory 需要外部保存和按需读取 |
| RAG 等于记忆系统 | RAG 是检索外部资料的方法,检索结果还要进入 Context 才能影响模型 |
| MCP 是 Agent 的必需层 | 单机 CLI 可以直接执行工具,MCP 主要解决标准化复用与共享连接 |
| Planning 一定是独立模块 | 它可以只是模型的一次决策,也可以由专门规划器或工作流实现 |
| 多 Agent 一定比单 Agent 强 | 编排会增加成本、延迟与错误级联,任务可独立分解时才更有价值 |
| 自主运行就是不需要人 | 自主的是执行循环,目标、权限、不可逆动作和最终责任仍需要治理 |
这一篇在知识体系里的位置
本页是 Agent 原理线的总入口。向上连接 AI 编程工具导读 和 如何使用 Agent,向下展开 Loop、工具、上下文三条实现主线;具体产品配置进入 Agent 实战,RAG 与生产工程进入 LLM 应用工程。阅读时可以先记住总图,再按当前问题下钻,不必顺序读完所有文章。
总结
理解 AI Agent 架构,要同时看六个技术层和一个执行闭环:模型生成意图,Context Manager 组织本轮信息,Harness 驱动循环并校验动作,工具与后端产生真实结果,治理机制负责权限、Trace、评测和成本,产品层把这些能力组合成具体体验。先分清模型与运行时、Context 与 Memory/RAG、Function Calling 与 MCP,再通过 mini-agent 的 M1~M3 把概念落到消息、代码和实验,就能建立一张可靠而可继续扩展的技术地图。