Agent 和聊天机器人到底差在哪
系列入口:如何使用 Agent,术语汇总看 术语速查。
一、从两个星期五的下午说起
先看两个似曾相识的场景。
场景 A:下午四点,线上报了一个空指针异常。小王打开聊天窗口,把报错堆栈贴进去,问「这是什么意思」。机器人回了三段解释,列出五个可能原因。小王逐个去代码里翻,找到疑似位置后又问「那这段该怎么改」,机器人给了一段代码,他手动复制进文件,一跑,编译报了新的错。他再把新报错贴回去……如此反复了九轮,等测试跑绿,已经晚上八点。
场景 B:同样的报错,小李对 Agent 说了一句:「生产环境这个空指针,定位根因,修好,补上回归测试,改完先别提交,把 diff 给我看。」然后他去开了个会。回来时屏幕上是一份完整记录:Agent 读了堆栈、在代码库里搜出三处调用链、发现根因是上游一个可选字段没判空、改了两处代码、加了一个针对该字段缺失的测试、跑通了全部相关用例,最后停在「等待你 review」的状态。小李花三分钟看了 diff,批准提交。
两个人用的是同一个模型,智商没有差别。差别在于:小王一直在亲手替工具跑那个「提问—拿答案—动手—再提问」的循环,而小李把整个循环交给了工具,自己只负责开头给目标、结尾做审批。 这就是这篇要讲的分界线。
二、一句话回答
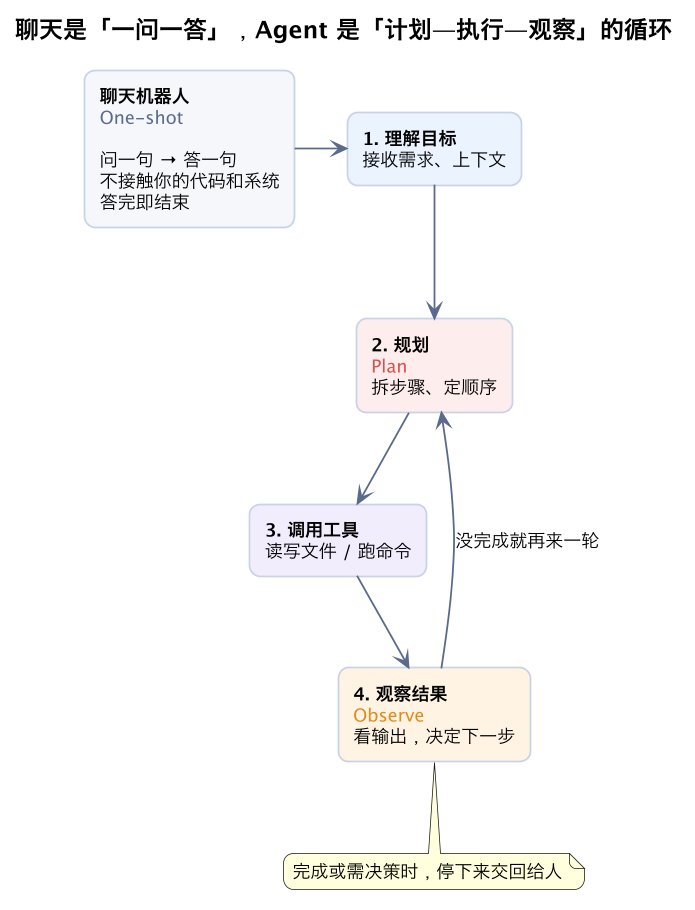
聊天机器人回答「一句话」,Agent 负责「一件事」。 前者你问一句它答一句,对话结束它的工作也就结束了;后者你给一个目标,它会自己拆解步骤、调用工具、执行操作、查看结果,然后决定下一步,直到把整件事做完或者在关键处停下来等你确认。
这个差别听起来细微,用起来却是两种东西。你可以让聊天机器人「帮我看看这个报错什么意思」,它给你一段解释;你让 Agent「修复这个报错」,它会去读报错信息、定位相关文件、改动代码、运行测试,再把结果拿给你看。一个是顾问,只动嘴;一个是干活的人,会动手。
值得停下来看一眼:小李那句指令背后,Agent 内部到底发生了什么。把循环摊开,大约是这样一连串动作——
- 理解目标:修复空指针、加回归测试、不提交、最后给 diff 看。它从这句话里提取出四个约束,而不只是「修 bug」。
- 规划:先看堆栈确定出错的类和方法,再沿调用链往上找谁传了空值,判断是防御性判空还是上游契约问题,然后改代码、写测试、跑用例。
- 行动(第一轮):读取日志文件,用代码搜索找到报错行。
- 观察:发现报错处对象来自三个调用方,其中两处有判空、一处没有。
- 再思考:根因在那一处漏判空的调用方,而不是报错行本身——于是它没有在症状处糊一个判空,而是去改真正的源头。
- 行动(第二轮):修改源头文件,新增一个缺失字段的测试用例。
- 观察:测试输出全绿。
- 收尾:因为有「先别提交」的约束,它停在提交之前,把 diff 和根因说明交还给小李。
这八步里,人只参与了第 0 步(给目标)和最后一步(审批),中间所有「看到结果再决定下一步」的判断都发生在循环内部。 聊天机器人不是做不到其中任何一步——解释堆栈、生成判空代码它都会——它缺的是把这些步骤自动串起来、并且每步都基于真实环境反馈的那个「环」。
三、三个本质特征
把「Agent 到底是什么」说清楚,看三个特征就够了。这三点不是营销概念,而是你判断手里的工具算不算 Agent 的硬标准。缺任何一个,它都退化成别的东西:没有循环,它是一问一答的聊天;没有工具,它是只会出主意的顾问;没有审批节点,它是个不受控的脚本。
第一,自主循环(Agentic Loop)。 这是最核心的一点。Agent 内部有一个「思考 → 行动 → 观察 → 再思考」的循环,它不需要你每一步都发指令。你给的是目标,中间要分几步、先做什么后做什么、上一步失败了要不要换个办法,都由它在循环里自己决定。聊天机器人没有这个循环,它每次只对当前这一条消息负责。
第二,能调用工具(Tool Use)。 光有循环还不够,Agent 还得有「手」。它能通过工具真正对外部世界做事:读写你项目里的文件、执行 shell 命令、搜索代码库、查询数据库、调用 API。正是工具调用让它从「给建议」变成「直接动手」。这也引出了后面所有的安全和审批问题——因为它能真的改动东西。
第三,在关键节点交回给人(Human-in-the-loop)。 Agent 自主,不等于放任。成熟的 Agent 会在要执行危险命令、做不可逆操作、或者遇到需要拍板的岔路时停下来,把方案和 diff(改动差异)给你看,等你批准。完全自动、从头到尾不等人确认的,要么是任务足够简单,要么是在替你承担风险。
3.1 关于「自主循环」,要澄清三个误会
误会一:循环等于模型自己思考,所以它一定知道自己在干什么。 不是。循环只是一个「行动—看结果—再行动」的机械结构,它保证 Agent 会根据环境反馈调整,却不保证每次判断都正确。它可能连续三轮朝着错误方向努力,只是每轮都「自信地」根据错误观察继续推理。循环提升的是执行的连续性,不是判断的正确性——后者仍然要靠你给的目标、上下文和最终审批来兜底。
误会二:循环越多越好,让它一直跑别打断。 恰恰相反。一个任务如果转了五六轮还在原地打转,通常意味着目标不清、缺关键上下文,或者任务本身超出了它的能力。这时候让它继续跑只会烧钱并扩大改动面。有经验的使用者会设置心理预期:简单任务两三轮该收敛,复杂任务可以十轮,但每一轮都应该能看到它离目标更近,而不是横向漂移。
误会三:有循环就不需要我懂代码了。 这是最危险的误会。循环让它能独立走完过程,但「走完」和「走对」是两回事。正因为中间你不参与,最后的审批才更需要你看得懂它做了什么。Agent 降低的是执行的体力门槛,不是判断的责任门槛。
3.2 工具调用:为什么「手」比「脑」更改变性质
一个只能输出文字的模型,无论说得多肯定,影响都止于屏幕;一旦给它工具,它的输出就第一次能改变你磁盘上的真实状态。这一步是质变,所有安全讨论都从这里开始。
常见的工具大致四类,危险程度递增:只读类(搜索代码、读文件、查文档)——基本无害,可以放手让它用;写入类(修改、新建文件)——会留下改动,但可通过版本控制回滚;执行类(跑 shell 命令、装依赖、起服务)——能触达系统,rm -rf 和 npm install 只有一字之差;外联类(调 API、发请求、访问数据库、部署上线)——动作一旦发出可能无法撤回,比如真的往生产库写了数据、真的触发了一次对外发布。
理解这个梯度,审批策略就有了依据:只读工具默认放行,写入工具靠 diff 审查,执行和外联工具则要求逐次确认。这也是为什么后面讲配置和权限钩子时,核心动作都是「按工具的危险级别分级放权」,而不是一刀切地允许或禁止。
3.3 审批不是打断,是分工
新手常把审批节点理解为「Agent 不够智能才需要我盯着」,于是总想把所有确认都关掉,追求所谓全自动。这是把「自主」和「放任」搞混了。健康的分工是:重复性的、可逆的、判断标准客观的动作交给循环;不可逆的、影响外部的、需要价值判断的决策留给人。
举个具体的区分:Agent 自己决定「为了让测试通过,抽一个辅助函数出来」,这是实现层面的可逆决策,不需要问你;但它如果发现「要修这个 bug,得改一个被二十个模块依赖的公共接口签名」,这就是影响面超出本任务的决策,应该停下来。好的 Agent 不是确认弹得越多越好,也不是越少越好,而是恰好停在「继续走的代价可能大于停下来问一句」的位置。
| 特征 | 聊天机器人 | 代码补全 | Agent |
|---|---|---|---|
| 工作方式 | 一问一答 | 上下文补下一行 | 自主循环完成整件事 |
| 能否调用工具 | 一般不能 | 不能 | 能(文件/命令/搜索/API) |
| 谁决定中间步骤 | 你逐句引导 | 你逐行写 | 它自己规划,你审批 |
| 产出 | 一段文字 | 几行代码 | 改好的代码 + 测试结果 |
四、和 L1~L4 的分界线在哪
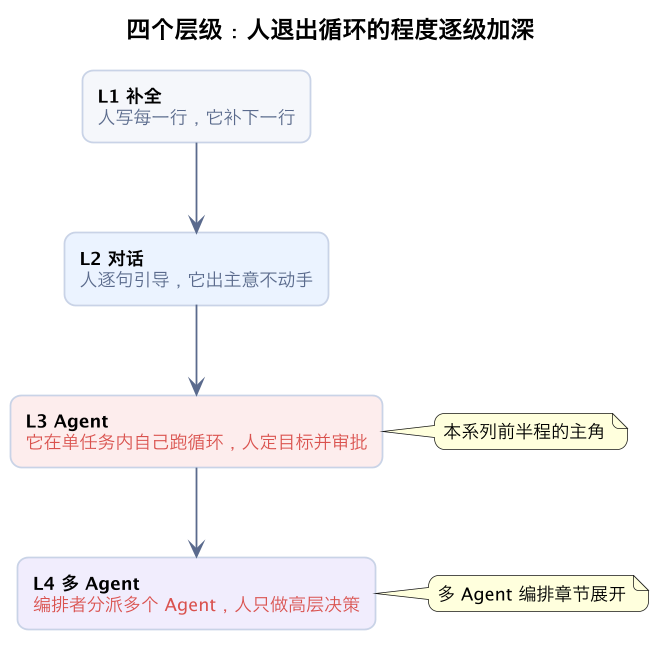
AI 编程工具导读里把工具分了四级,很多人卡在「我这个到底算对话还是算 Agent」。分界线很简单,就看它会不会自己往下走。
- L1 补全:你写代码,它提示下一行,按 Tab 接受。它不主动,你停它也停。
- L2 对话:你在聊天窗口问,它答。可以帮你写函数、解释代码,但它不会自己去翻你项目、更不会自己改文件,每一步都要你把内容贴给它。
- L3 Agent:你说「把这个模块拆成两个文件并更新所有引用」,它会自己去读模块、找引用、改文件、跑检查。指令里包含的是目标,而不是每一个动作;但任务边界由你划定,它在单个任务内自主。
- L4 多 Agent 协作:一个编排者把复杂目标分派给多个专职 Agent,并行或流水线式完成,最后汇总。你连「拆成几个任务」都可以部分交给它。
一个实用的判断方法:如果你发现自己在反复充当「传声筒」——把报错复制给它、再把它给的代码手动贴回文件、再把新报错复制给它——那你其实是在手动替它跑那个本该自动的循环。这种时候,就该换成真正的 Agent 了。
还要补一句反向的判断:不是所有事都需要 L3、L4。 你只想知道「这个正则什么意思」,L2 一句话最快,没必要郑重其事开一个 Agent 去动文件;你只想补全一行,L1 最顺手。层级是工具形态,不是高低等级,用错重武器同样是浪费。
五、理解差别,是为了用对方法
为什么第一篇就要抠这个定义?因为对工具的预期错了,用法一定错。把 Agent 当聊天机器人用,你会事事不敢放手、每个动作都重新指挥,又累又慢;把聊天机器人当 Agent 用,你会轻信它「我已经帮你改好了」,结果它只是在对话里写了段代码,你的文件根本没动过。
看清「它会自己跑循环、会动手、但关键处会停下来等你」这三点,后面的使用方法才有根基:正因为它自主,你才要学会拆解任务和审批;正因为它能动你的系统,你才要懂安全边界和Plan 模式。
六、常见问题
Q:我用聊天机器人,再配合手动复制粘贴,是不是也算 Agent 玩法? 形式上你确实在跑一个循环,但引擎是你自己:每一轮的调度、判断、搬运都由你完成,模型只充当其中「给一段话」的零件。这正是 L2 形态,瓶颈不在模型而在你手动传上下文的速度。任务稍大,上下文还会在搬运中丢失。判断标准很简单——循环的「转」是谁驱动的,是你按发送键,还是工具自己接着干。
Q:Agent 会不会偷偷执行我没授权的操作? 正常设计下不会:工具权限是显式配置的,危险动作要过审批。但你要主动确认两件事:当前工作目录是不是隔离的(别在存放重要文件、又没有 git 兜底的目录里放开写权限)、外联工具(部署、数据库、发消息)是不是默认关闭。安全不是默认就有,是配置出来的。
Q:同一个模型,为什么在对话里表现一般,当 Agent 用却好像变强了? 模型本身没变,变的是它能拿到的信息和纠错机会。对话里它只能基于你贴的片段一次性作答;Agent 形态下它可以先读真实代码、再动手,而且每轮都能看到命令的真实输出,错了会被环境立刻「打脸」并修正。很多所谓的智能差距,其实是有没有接上真实环境反馈的差距。
Q:全自动跑完不打扰我,难道不是终极目标吗? 对足够标准化、全程可逆、结果可自动校验的任务(比如跑一套固定的格式检查),确实可以追求全自动。但对结果存在判断空间、或动作不可逆的任务,人的审批不是权宜之计,而是系统的一部分。成熟度体现在你能清楚地划出「哪些可以放手、哪些必须过我」,而不是无差别地关掉所有确认。
七、第一次上手,可以这样自检
不用记住所有概念,第一次用 Agent 时对照这几条就够了:
- 我给的是「目标 + 约束」(修好、加测试、先别提交),还是一串逐动作指令(打开这个文件、把第三行改成……)?前者才是 Agent 的正确用法。
- 它有没有在动手前先读真实代码,还是凭我一句话的描述就开始写?缺了读代码这步,及时叫停。
- 我心里有没有预期「这件事大概几轮该收敛」?超过预期还在漂,就停下来看是不是目标或上下文出了问题。
- 它要跑的命令、要访问的外部系统,我是否清楚风险?不清楚就别点允许。
- 最终交付时,我是真的看懂了 diff 才批准,还是因为它说得很肯定就放行了?
这五条会贯穿整个系列,现在先有个印象即可。
总结
判断是不是 Agent,不看它多能说,而看它能不能在「计划—执行—观察」的循环里自己往下走、用工具把事做成,并在关键处把决定权交回给你。