自动化代码审查机器人
系列入口:如何使用 Agent。M12 第 2 篇。
一、机器人该做什么、不该做什么
人工代码评审是宝贵但稀缺的资源,资深工程师的注意力应花在设计与取舍上,而不是反复挑缩进、漏判空、忘记加测试这类低级问题。Agent 审查机器人的定位,是在人评审之前做一道不知疲倦的前置过滤。
它擅长:发现明显 bug 与边界遗漏、提示缺少测试、检查与团队规范的一致性、指出可能的越界改动、解释这段 diff 的意图。但它不应:替代人做架构判断、直接阻断合并、或对超出 diff 范围的内容大放厥词。核心原则是"建议而非裁决"——它给出有据可查的意见,最终判断仍归人(边界见自动化边界)。
二、让审查任务自包含
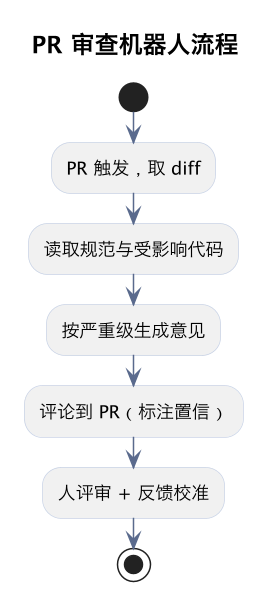
机器人在 CI 中运行时没有你本地的对话记忆,任务必须自包含(原则见 CI/CD 非交互运行):把本次 diff、必要的周边代码、团队规则、以及希望它关注的检查项一次性提供。
只给 diff 会让它"只见树木不见森林",无法判断改动是否破坏调用方;但给太多无关代码又会稀释注意力。合理做法是:以 diff 为中心、附带受影响的函数/接口及其调用点。用明确指令指定输出格式——按严重级(阻断/建议/提问)分类、每条附文件行号和理由。
三、聚焦影响面,分级输出
高质量的机器评审应回答"这次改动可能影响谁、风险在哪",而不只是逐行挑刺。
让它先总结意图、再分析影响面:是否改了公共接口、有无旧调用方需要同步、是否涉及并发/权限/错误处理/性能敏感路径。输出按严重级区分:可能导致缺陷的放最前并明确标出,风格/规范类折叠或单列,拿不准的以提问形式提出而非断言。这种分级让人能优先看真正重要的意见,而不是淹没在几十条琐碎评论里。
四、控制误报:机器人可信度的生命线
一个审查机器人最大的失败模式,是误报太多——当它频繁对正确代码指手画脚,开发者会迅速学会无视它,连真正有价值的告警也一起忽略,最后机器人沦为纯粹的噪音。
控制误报的手段:只对有把握的问题下断言,其余以"请确认"提问;规则要具体、绑定到本项目真实约定,而不是套用泛泛的最佳实践;避免对它无法完整看到上下文的代码强行评论;让每条意见可追溯到代码。宁可少报、也不要滥报,尤其是阻断级意见,误报一次就会严重损害信任。
五、用评审反馈持续校准
机器人不是配好就一成不变。把它当作一个需要持续训练的团队成员:
收集人对它评论的反馈——哪些被采纳、哪些是误报、哪些真问题它漏了;误报高频的规则收紧或删除,漏报的模式补入检查项。可维护一组带标注的 PR 样本做回归,验证规则调整后机器人的表现(方法见评测集)。让它的判断力随团队真实反馈单调变好,而不是停留在第一天的水平。
六、与人工评审的分工
理想的流水线是分层的:机器人先挡低级问题、跑测试与静态检查;作者据此修正后,再由人聚焦于设计、可维护性与业务正确性。这样人看到的是已经"清理"过的 PR,评审质量和速度都提升。
要明确的是,机器人通过不代表人可以不看——它是帮人减负的第一道网,而不是责任的承担者。合并的决定和后果,始终由评审者与作者负责。
七、一个机器人从被嫌弃到被信任的过程
很多团队第一次上审查机器人,体验并不好,理解它的典型演进能少走弯路。
刚上线时,机器人被配置成"尽量多找问题",结果每条 PR 都挂着二三十条评论,大半是缩进、命名和它没看全上下文而误判的"空指针风险"。作者很快开始无视它,有人甚至关掉了通知。团队据此做了三件事:一是大幅收紧断言规则,只保留在完整上下文里也成立的高置信问题,其余一律改成"请确认"的提问;二是把风格类全部折叠,只突出可能导致缺陷的几条;三是建立反馈渠道,误报的规则下个迭代就删。
几轮之后,机器人平均每条 PR 只给三到五条意见,但命中率很高,作者开始真正去看,甚至会在评审前主动等它跑完。这个转变的核心是信噪比,而非检查的覆盖面——一个总是喊狼来了的助手比没有助手更糟,而一个克制、准确的助手才能赢得工程师的信任,进而真正改变评审质量。
八、机器人检查项的优先级清单
配置机器人时,建议把检查项按价值排序,优先做收益高、误报低的。
高价值优先:资源泄漏与未关闭的连接、空值/越界等边界、错误被吞掉、改公共接口却漏改调用方、并发下的共享状态、明显缺失的关键测试。中等:与项目约定不一致的错误处理、日志级别使用、潜在的性能反模式(如循环里查库)。低价值/易误报,谨慎或折叠:纯风格、命名偏好、它看不全上下文时的"可能为空"。
排序的逻辑是先抓"高确定性 + 高代价"的问题,把机器人有限的可信度用在刀刃上。风格问题交给格式化工具(那是确定性的),LLM 机器人不该在它不擅长、又容易惹烦的领域刷存在感。随着反馈积累,再逐步扩展被验证可靠的检查项。
九、让机器人解释"为什么",便于作者成长
机器人的评论如果只说"这里有问题",作者改了也不理解;让它附上简短的原因和后果,它就同时成了一个教学工具。
比如不只说"可能空指针",而是"这里的返回值在 X 路径下可能为 null(见 Y),直接解引用会在该路径抛错,建议先判空"。作者读到的是一个完整的因果,下次会自己注意。随着时间推移,团队对这些高频缺陷的整体敏感度会提高——机器人在评审的同时,也在持续做着隐性培训,而这部分教育价值,是单纯的静态检查工具很难提供的。
十、不同成熟度团队的接入节奏
审查机器人不是一步到位,按团队成熟度分阶段接入更稳。
初期:只让它做只读的提示性评论、聚焦最高置信的少数缺陷,不与任何门禁挂钩,先让大家习惯它的存在、并积累反馈。中期:当误报降到可接受、检查项经过验证,可让它的评论成为"建议修复"的参考、与格式化和测试并行。成熟:对极少数高确定性的问题(如检测到已知的密钥泄漏)才允许触发阻断,其余仍以建议为主。
每一步都基于真实数据推进,先赢得信任、再扩大权限,而不是一上来就让 LLM 卡合并、因误报激起全团队抵触。这种渐进节奏,和团队推广 Agent 的整体路线是一致的。
十一、把审查机器人和度量连起来
要判断机器人到底带来多少价值,可以用几个度量跟踪它的表现,并持续优化。
可记录:它提的意见中有多少被作者采纳(命中率)、上线后由它先发现的缺陷占比、误报率、以及它评论后人工评审耗时的变化。健康的机器人应表现为命中率稳定或上升、误报下降、人工耗时减少。如果发现它长期命中率低,就该收紧规则;漏报多则补充检查。让机器人的价值用数字说话,而不是凭"感觉挺有用"——这些度量也能帮助向团队和管理者证明它值得保留。
十二、不要让机器人制造"对立感"
审查机器人的评论是公开挂在 PR 上的,措辞如果居高临下,容易让作者感到被机器评判、产生抵触,这会抵消它的价值。
让评论保持对事不对人、客观、聚焦代码的语气:描述问题本身和可能后果,而不是评价作者水平;宁可说"这里可能…"也不要"你又忘了…"。机器人是帮作者挡住问题的队友,不是来打分的考官。措辞的温度,决定了它被当作帮手还是监视者。 尤其当它同时面向资历深浅不同的成员,克制、平等、建设性的表达,才能让所有人都愿意接受它的存在,而不是把它视为一种负担或冒犯。
十三、把"它能稳定发现的问题"沉淀成规则
当机器人反复在同一类问题上给出准确意见,说明这类检查已经足够可靠,可以进一步固化为确定性的静态规则或 lint,让它不再依赖 LLM 的概率性判断。
这是一条自然的进阶:LLM 负责探索和发现模式,一旦某模式被证明高确定性,就沉淀成工具规则,既更稳定、零误报,也把模型的判断力释放给更新、更难的问题。长期看,团队的自动化检查库会随机器人的"探路"持续增厚,而 LLM 始终站在前沿处理尚未被规则化的部分——这种"概率发现 → 确定性沉淀"的循环,正是审查机器人持续创造复利的方式。
十四、常见问题
Q:机器人能不能直接卡住合并? 一般不建议。阻断权应留给确定性高的测试/静态检查;LLM 评审以建议为主,避免误报阻塞正常流程。
Q:它漏了 bug 算谁的? 责任仍在人,机器人只是辅助;这也是不能把最终裁决交给它的原因。
Q:评论太多作者烦怎么办? 压缩为少量高置信意见、分级折叠、并持续按反馈去噪;机器人的价值取决于"信噪比"而非评论数量。
Q:大 PR 审不动怎么办? 让它聚焦受影响的公共接口与高风险路径,必要时建议拆分 PR;大 diff 上降低评论密度以保准确。
八、检查清单
- 机器人定位为建议而非裁决,不直接阻断合并。
- 审查任务自包含,以 diff 为中心附带影响面。
- 输出按严重级分类、附行号与理由。
- 有控制误报的机制(提问代替断言、规则绑定项目)。
- 已建立反馈校准与样本回归闭环。
总结
把 Agent 接成 PR 审查机器人,是让它承担"第一道前置过滤":在人评审前用自包含的任务读取 diff 及受影响代码,先总结意图、再分析影响面,按阻断/建议/提问分级输出并附行号,同时把误报率当作生命线——没把握就提问、规则绑定本项目、宁可少报不滥报,再通过人工采纳与否的反馈和样本回归持续校准它;它挡低级问题、人专注设计取舍,且永远只是建议者而非裁决者,合并的判断与责任始终留在人这一侧,这样机器人才能保持高信噪比、成为团队真正会去看的帮手,而不是被无视的机器噪音。