如何让 Agent 读到对的文件
系列入口:如何使用 Agent。本篇是 M3 上下文工程的最后一篇。
一、「它没读到」比「它不会」更常见
当 Agent 改错地方、用了过时的写法、或者忽略了某个关键约束时,先别急着怀疑模型能力。最常见的原因朴素得多:它根本没看到那个关键文件。 Agent 不会自动知道你的代码库里哪个文件最重要——你不给线索,它只能靠自己检索,而检索结果未必命中。
把对的文件送到它眼前,是投入最小、回报最大的动作之一。主要有三种方式,按「你对文件位置的确定程度」选用。
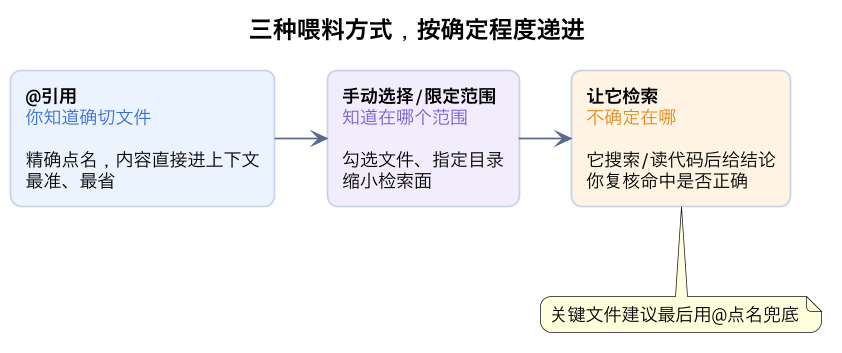
二、方式一:@引用——你知道确切文件
大多数客户端支持在输入框用 @ 直接引用文件(或符号),比如:
「请对照 @services/order.ts 里的下单逻辑,给 @services/order.test.ts 补充支付失败的测试。」
被引用的文件内容会确定地进入上下文,不依赖它自己找,最准也最省 token。当你清楚该看哪个文件时,这永远是首选。除了文件,很多工具还能 @ 引用目录、文档、规则或符号定义。
用好 @引用有几个细节。一是别一次 @ 太多文件。 引用虽然精准,但引用本身仍占窗口,点名十几个文件等于手动制造信息过载,应只引用真正必要的。二是把引用放在语境里。 不要只甩一串文件,要说明每个文件扮演什么角色,比如「对照 @order.ts 的实现,给 @order.test.ts 补测试」,它才知道该怎么用这些信息。三是当你只需要文件的一部分时,可以引用文件再加一句限定(「只看其中处理退款的部分」),避免无关内容干扰。
一个常见的高效组合是:先用它检索定位,确认命中后,再在真正要动手的那一轮用 @精确引用关键文件。这样既利用了检索的广度,又在执行时保证了信息的确定和精简,比一开始就盲目 @ 一堆文件、或完全靠它自己找都更稳。
三、方式二:手动选择 / 限定范围
你可能不确定具体文件,但知道问题大概在哪个目录或模块。这时可以:
- 手动勾选/附加相关文件,让它只在这些文件里工作;
- 在任务里划明范围:「只看
src/auth/目录,别动其他地方」; - 部分客户端支持把某几个文件加入「工作集/上下文」,减少它乱翻。
限定范围的双重好处:既提高它命中正确文件的概率,又避免它读到无关代码、顺手改坏别处。
这个方式特别适合你对代码结构有大致了解、但不想让它乱跑的情况,几个可以直接照做的说法:
- 「只在
src/checkout/这一个目录内排查和修改,不要碰目录外的文件;如果你发现问题根源在目录外,先停下来告诉我,别直接改。」 - 「我把这三个文件加入上下文,你只基于它们分析;需要读别的先问。」
- 「搜索范围限定在
services/,排除tests/和docs/。」
注意这里有一个聪明的设计:你可以在限定范围的同时,预先告诉它「如果发现根因在范围外该怎么办」——通常是先报告而不是自行扩大。这等于提前堵住了它「为了把事做完整而越界」的常见倾向,又不会因为限制太死而让它在根因确实在外时干瞪眼。把范围边界和越界后的处理方式一起交代清楚,是比单纯说「只看这里」更稳妥的做法。
四、方式三:让它自己检索——然后由你把关
当你自己也不确定文件在哪(比如在陌生代码库里找「谁调用了这个 API」),就让 Agent 去搜。但要注意两点:
- 给精准的检索线索:函数名、特征字符串、错误信息,越具体越容易命中,而不是让它泛泛地「看看登录相关代码」。
- 复核它找到的东西:让它列出「我读了哪些文件、依据是什么」,确认命中正确后再让它动手。它检索得自信不等于找对了。
对于会翻很多文件的大型检索,更适合交给子代理,只把结论带回主对话,避免大量中间结果撑爆上下文窗口。
检索能否命中,很大程度取决于你给的线索质量,这里给你直接对照:
- 偏弱:「你看看登录那块代码有没有问题」——范围模糊、没有特征,它只能大面积翻,命中靠运气,还会带回大量无关内容。
- 偏强:「找一下哪个文件在用户密码校验失败时返回错误码
E_AUTH_1024,搜这个字符串和它的调用处」——有精确特征,检索范围小、命中准。 - 更强:「这个报错
NullReference at PricingEngine.calculate:42对应哪个文件?沿调用链往上看,谁可能传入空值」——既有定位锚点,又给了追踪方向。
可以给检索用的高价值线索包括:独一无二的字符串(错误码、异常文案、配置键)、确切的函数或变量名、日志里的具体片段、以及明确的目录边界。线索越具体,搜索模式就能越精确,返回的噪音越少。 还有一个容易忽略的要求:让它在检索后先报告「我搜了什么、读了哪些文件、为什么认为相关」,而不是直接基于结果开改。这一步复核成本很低,却能拦住「它搜错地方还特别自信」的情况。你不必亲自判断所有代码对错,先确认它的检索路径合理即可。
五、怎么确认它真的读对了
喂料之后,用两个小动作验证:
- 让它复述关键信息:「用你看到的内容说一下,这个函数的入参和约束是什么?」答得对,才算读进去了。
- 检查它实际打开的文件列表:执行过程中留意它读的是不是你指定的文件,出现陌生路径及时喊停。
这两个动作可以再细化成一个三步确认法,喂完料花一分钟走完:
- 读了没:让它确认已读取,并说出文件路径,避免它凭文件名猜测或根本没调用读取工具。
- 读懂没:让它用自己的话讲出该文件里最关键的一两条事实或约束,而不是泛泛重复。
- 读全没:确认它是否意识到还依赖哪些相邻文件——如果它漏掉了你知道的关键依赖,及时补上。
通过这三步,你其实在它动手前就完成了一次轻量验收。好处是把「没读到 / 读错 / 读漏」这三类问题都挡在了执行之前,而不是等改完才发现。对新手尤其友好的一点是,这三步都不需要你深入掌握实现细节,只要你对「关键事实是什么」心里有数,就能判断它复述得对不对。把这个确认法养成习惯后,你会发现大量低级错误在开工前就消失了,这也是文件喂料这一步能显著提升交付质量的原因。
| 方式 | 适用 | 关键动作 |
|---|---|---|
| @引用 | 知道确切文件 | 直接点名 |
| 手动/限定 | 知道范围 | 缩小工作面 |
| 让它检索 | 完全不确定 | 给线索 + 复核命中 |
六、一次真实任务的喂料全过程
把三种方式串到一个具体需求里,你会更清楚它们怎么配合。需求是:「最近有用户反馈,购物车里改商品数量后,偶尔会显示成旧价格。」这是一个你暂时也不知道根因的问题,喂料就需要分阶段进行。
第一阶段——定位(靠检索)。 你给它精准线索,而不是让它泛读:「先别动代码。搜购物车更新数量的处理函数(可能含 updateQuantity、recalculate 之类命名),以及价格是从哪里读取和刷新的,找到后告诉我涉及哪些文件、调用顺序。」它检索后报告:数量更新走 cart.service.ts,价格在 pricing.ts 计算,而页面展示用的是另一份缓存,怀疑是更新了数量、但展示读的缓存没失效。
第二阶段——确认(你复核)。 你让它具体说明这三个文件如何交互、缓存在哪一步更新、为什么会偶尔读到旧值。确认它的链路推断合理,而不是它猜的。这一步只做理解,不产生改动。
第三阶段——精读(用 @点名)。 真正要动手修时,你让它精确对照这几个关键文件:「对照 @cart.service.ts 和 @pricing.ts,定位缓存失效应该发生在哪一步。」此时只让相关文件确定地进入上下文,而不是把整个购物车模块都读进来。
第四阶段——验证(复述 + 跑测试)。 改完前让它复述根因和修法,改完跑相关测试,你再看 diff,确认只动了必要范围。
这个全过程体现了喂料的核心节奏:不确定时先用精准检索定位、复核命中后再用 @精确引用精读、动手前复述确认。 如果反过来,一上来就让它读整个购物车相关目录,它会被大量文件淹没、还可能改错;如果完全不给线索、直接说「修好它」,它可能凭猜测乱改一通。把信息分阶段、按确定程度喂给它,是在陌生问题上仍能稳定推进的关键。
还要注意一点:这个任务的中间检索过程(读过的若干候选文件)大部分最终用不到,这类会产生大量中间信息的探索,尤其适合交给子代理,让主对话只保留最终定位结论。这样既完成了大范围摸排,又保持主窗口干净——文件喂料和上下文隔离在这里是配合使用的。
七、一个容易被忽视的误区:读得越多 ≠ 越保险
新手出于谨慎,常让它「把相关文件都读一遍、多读点更保险」。但如前所述,这会带来反效果:窗口被占、注意力被稀释、成本上升,它反而可能在大量材料里抓错重点。正确的谨慎不是「多读」,而是「读准」——确认关键文件确实被看到、且无关内容被排除。你给它三个真正相关的文件,效果往往好于让它自己翻二十个。
判断信息给得是否合适,可以在它读完后问一句:「你现在掌握的、用来做决定的关键事实有哪几条?」如果它能简洁准确地说出来,说明信息聚焦;如果它开始罗列大量似是而非的内容,可能已经读杂了,需要收窄。这个小验证既检查了读取,又检查了理解,是很省事的把关方式。
八、常见问题
Q:我怎么知道该读哪些文件?我自己也不熟。 那就先走检索这条路:让它用你给的特征(报错、函数名)去定位并报告路径和理由,你复核它的命中,确认后再让它动手。把「确定该读哪些文件」这件事本身也交给它先做,但把拍板权留给自己。
Q:@引用和直接在消息里贴代码,有什么区别? 贴代码会让消息变长、且可能丢失文件路径和周边语境;@引用直接关联真实文件,既省手工搬运,也更准确。能用引用就不要手动复制粘贴,尤其是较大的文件。
Q:它读了文件还是改错,怎么办? 先确认它是真读了(让它复述关键约束),再看是不是文件虽然读了、但关键约定在另一个没读到的文件里。必要时用规则文件把跨文件的稳定约束固化。读对文件是前提,但仍要配合方案审查和验收。
Q:要不要让它读整个目录以确保不遗漏? 通常不必,且容易撑爆窗口。更好的做法是先用精准检索或子代理摸排、缩小到几个关键文件,再精读。「确保不遗漏」应靠有方向的检索实现,而不是无差别全读。
八、把文件喂料固化成稳定的工作习惯
最后把这件事上升到习惯层面,帮助你长期受益。文件喂料做得好,关键不是每次临场记得多少技巧,而是形成一个固定的开工顺序:先想清楚这次真正依赖哪几个文件和规则 → 用 @或限定范围把它们准确给到 → 让它复述确认 → 再允许动手。 当这个顺序成为本能,你会在任务一开始就消除大量「没读到、读错、读漏」的低级问题,而不必等改完再返工。
为了让习惯可持续,还可以把重复出现的「该读哪些文件」沉淀下来:如果某一类任务每次都要读固定的几个文件,可以在规则或 Skill 里写明,让它自动去读,而不必你每次重复点名。这样一次性的经验就变成了长期生效的配置,进一步降低你的心智负担。文件喂料和规则、Skill 并不是割裂的,它们配合起来,才能让「读对文件」从偶然变成稳定机制。
还要保留一个朴素的判断:给文件不是越多越负责,读准、读全关键信息才是真正的把关。 当你在实践中越来越能快速判断「这件事的关键文件是哪几个」,你驾驭 Agent 的水平就已经明显提升了。这也是整个上下文工程模块希望帮你建立的核心能力——让对的信息,在对的时机,进入 Agent 的视野。
Q:如果我连一个能搜的特征字符串都没有,怎么办? 可以反过来让它先做一次「结构导览」:只读地列出项目的目录结构、入口文件、主要模块职责,帮你建立地图,然后再决定从哪里深入。这一步不针对某个具体字符串,而是让你在完全陌生时先获得定位能力,再给精准线索。
Q:让它读文件前,我需要先自己打开看一遍吗? 不必须。你可以直接让它读、再让它向你复述关键内容,由它帮你「读」给你听。你要做的是判断它复述得是否合理,而不是先替它读一遍——否则就失去让它代劳的意义了。
总结
Agent 改不对先怀疑它「没读到」:知道文件就用 @点名、知道范围就限定目录、不知道在哪就让它检索但要复核命中——把对的文件送到它眼前,比打磨十句提示都管用。