在客户端配置 MCP Server
系列入口:如何使用 Agent。前置理论:MCP 协议。本篇讲把一个 MCP Server 真正接进你的客户端。
一、配置到底在做什么
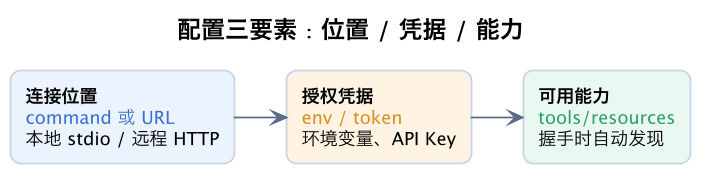
配置一个 MCP Server,本质上是告诉客户端三件事:去哪里启动或连接这个服务、用什么凭据授权、以及它能提供哪些能力。 一旦这三点成立,客户端就能在需要时调用该服务暴露的 Tools、读取 Resources,就像调用自己内置的工具一样。
很多人第一次配置时把它想得很神秘,其实它和「在一个程序里登记一个外部命令或远程地址」没有本质区别。区别只在于登记之后,AI 会根据工具描述自行判断何时调用。理解了这点,下面的各种写法都只是同一组信息的不同表达方式。
二、先分清三种作用域
在写任何配置前,先决定这个 MCP Server 应该在什么范围内生效,这决定了你该写到哪里。
本地作用域(local) 只对你当前用户、且通常只在某个项目内可见,适合个人临时使用或包含个人密钥、不希望进仓库的配置。项目作用域(project) 写在项目仓库里的配置文件中,团队所有人拉取后共享,适合那些团队通用、且不直接含敏感密钥的服务。全局作用域(global/user) 对你当前用户在所有项目生效,适合你个人跨项目反复用的服务。
判断很简单:这个服务是只我自己用、还是团队都要?是只在这个项目、还是到处都用?两组答案交叉,就能选定作用域。一个常见错误是把带个人 API Key 的配置放进项目文件提交,导致密钥泄露——凡是含敏感凭据的,优先放本地或全局,并用环境变量注入,而不是写死。
三、两种连接方式:本地 stdio 与远程 HTTP
MCP Server 有两大类连接方式,配置写法不同,需要分清。
stdio(本地进程) 最常见:客户端启动一个本地子进程,通过它的标准输入输出通信。配置时要给出启动命令、参数和环境变量。它的优点是简单、数据不出本机,适合跑在本地的文件、数据库、脚本类服务。要点是启动命令必须能在你的环境中直接运行——路径、解释器、依赖都要就绪,否则客户端拉起进程就失败。
远程 HTTP(SSE / Streamable HTTP) 用于连接部署在服务器上的 MCP 服务,配置时给出一个 URL,并通过请求头携带令牌。它适合团队共享的托管服务或 SaaS。要点是网络可达、令牌有效,且要意识到数据会经过网络,因此更要关注服务端是否可信。
一个简单的选择标准:服务跑在你自己机器上、用命令启动,选 stdio;服务通过网址访问,选 HTTP。
四、两种注册方法
1. 命令行注册
大多数 CLI 客户端提供了管理命令,适合快速添加本地 stdio 服务。典型形式是「添加 + 名称 + 环境变量 + 启动命令」,例如:
# 添加一个本地 stdio MCP Server,-s 指定作用域,-e 传入环境变量
claude mcp add file-search -s local -e NODE_ENV=production -- node file-search-server.mjs

# 添加一个远程 HTTP 服务,直接给 URL 和鉴权头
claude mcp add --transport http wiki https://mcp.example.com --header "Authorization: Bearer $WIKI_TOKEN"

# 查看已注册服务及其连接状态
claude mcp list
命令行会把这些信息写入客户端自己管理的配置,适合不想手写 JSON、或要快速验证服务能否连通的场景。-- 之后才是真正的启动命令,这个边界别写错。
2. 配置文件注册
团队共享的项目配置通常写在仓库根目录的 .mcp.json 一类文件里,结构清晰、可评审:
{
  "mcpServers": {
    "file-search": {
      "command": "node",
      "args": ["servers/file-search-server.mjs"],
      "env": { "NODE_ENV": "production" }
    },
    "wiki": {
      "url": "https://mcp.example.com",
      "headers": { "Authorization": "Bearer ${WIKI_TOKEN}" }
    }
  }
}这里有个关键安全习惯:令牌用变量占位(如 ${WIKI_TOKEN}),由每个人本地环境提供,而不是把真实 Key 写进文件提交。 这样团队共享了连接方式,却不共享密钥。配置文件还应纳入版本控制,让连接定义可追溯、可评审。
五、连接排错:按固定顺序逐层定位
配置失败是常态,关键是不要乱试,按「传输 → 进程 → 鉴权 → 能力发现」的顺序逐层排查,能快速锁定问题。
第一步,传输层。 stdio 服务先确认启动命令能否在终端手动跑起来;远程服务先用网络工具确认 URL 可达。绝大多数「连不上」其实是命令路径错、依赖没装,或网络不通,而非 MCP 本身的问题。
第二步,进程层。 如果命令能手动跑、客户端却拉起失败,检查工作目录、参数顺序、以及客户端是否在不同的环境中执行(比如找不到 node,是因为 PATH 不一致)。stdio 服务还要注意:它不应往 stdout 打印与协议无关的内容,否则会破坏 JSON-RPC 消息——调试日志应写到 stderr。
第三步,鉴权层。 远程服务返回 401/403,多为令牌缺失、过期或没正确放入请求头;检查环境变量是否真的存在、占位符是否被替换。
第四步,能力发现。 连接看似成功、但工具没出现,通常是握手阶段失败,或服务端没有正确注册 Tools。查看客户端的连接详情和服务端日志,确认初始化与工具列表是否正常返回。
| 报错/现象 | 更可能的层级 | 优先动作 |
|---|---|---|
| command not found / 进程退出 | 进程 | 手动跑命令、查路径与依赖 |
| 连接超时 | 传输 | 确认 URL/端口、网络与代理 |
| 401 / 403 | 鉴权 | 核对令牌与请求头 |
| 连上但没有工具 | 能力发现 | 查握手与服务端工具注册 |
| 输出乱、协议解析错 | 进程 | 调试信息改走 stderr |
五点五、一个真实的配置翻车现场
讲再多原则,不如看一个典型的翻车过程,它几乎把新手会踩的坑串了起来。
小王想让 Agent 能查公司内部 Wiki,于是照着文档装了一个远程 MCP 服务。第一次调用就报连接超时。他以为是服务挂了,去问运维,结果服务一切正常——真正原因是他所在网络要走代理,而客户端没有读取到代理配置。等他配好代理,又变成 403:他把令牌写进了配置文件,却忘了 export 环境变量,占位符根本没被替换,发出去的是字面量 ${WIKI_TOKEN}。修好鉴权后,连接终于成功,可工具列表是空的——原来他用的客户端版本较旧,和服务端协商时初始化字段对不上。升级客户端、重开会话之后,工具才出现。
这个过程之所以有代表性,是因为它严格沿着我们前面给的排错顺序在报错:先是传输(代理/网络),再是鉴权(令牌未注入),最后是能力发现(版本握手)。每一步他都以为「服务坏了」,但问题始终不在服务端,而在本地这一侧的连接配置。记住这个故事,你在自己排错时就不会一上来怀疑服务,而是冷静地从传输层开始,一层一层往上查,往往几分钟就能定位,而不是来回折腾一小时。
还有个细节值得记住:他最后是靠「重开会话」才看到工具的。MCP 的握手发生在连接建立之初,配置改完不重连,旧会话仍在用旧状态,这本身就是一个极其常见、却极易被忽略的「明明改对了却不生效」的原因。
五点六、本地与远程:怎么选才不后悔
前面简单提过 stdio 和 HTTP 的区别,这里再深入一层,帮你做长期不后悔的选择。
选 stdio,意味着每个客户端连接都会在你本机拉起一个独立进程。它的好处是数据天然留在本地、调试直观、不依赖网络;代价是这个服务只在你这台机器上活着,团队其他人想用就得各自装一份、各自维护依赖和版本,进程还可能占用本地资源。它适合「数据敏感、或服务本身就该跑在本地」的场景,比如操作本地文件、本地开发数据库。
选远程 HTTP,意味着服务部署在一台大家都能访问的服务器上,所有人连同一个地址。它的好处是集中维护、升级一次全员生效、不挑每个人的本地环境,也天然适合需要长期运行或共享状态的服务;代价是数据要经过网络,你必须信任服务端,还要处理鉴权、网络和可用性问题。
一个实用的决策顺序是:先问数据能不能出本机,再问是否要团队共享、是否需要集中升级。 数据敏感且只自己用,倾向 stdio;团队共享、集中运维,倾向 HTTP。很多团队的演进路径也印证了这点——先用本地 stdio 快速验证价值,跑顺后再把稳定、通用的服务部署成远程 HTTP,让全员复用。按这个顺序走,你既不会一上来就背负部署运维的负担,也不会在团队规模扩大后被困在「每人装一份」的泥潭里。
六、安全与授权要点
- 最小授权:只接入真正需要的服务;不同服务按需给凭据,别共用一个高权限令牌。
- 凭据不进仓库:用环境变量或本地配置注入,项目文件只放占位符。
- 远程服务确认可信度:数据会经过它,避免把敏感数据导向不明服务。
- 先只读验证:新接入一个服务,先用只读类工具确认连通与行为,再使用写入类能力。
六点五、作用域优先级与「幽灵配置」排查
多作用域在带来便利的同时,也制造了一类很恼人的问题:明明改了配置,行为却没变,或者某个你以为删掉的服务还在生效。这往往是「幽灵配置」——另一个作用域里存在同名条目,实际生效的根本不是你正在编辑的那一个。
理解作用域的叠加关系是排查的前提。本地、项目、全局是三处独立的存储,客户端在启动时把它们合并;当出现同名服务时,按客户端定义的优先级取其中一个。于是会发生这种情况:你在项目的 .mcp.json 里把令牌改成新的,可本地作用域里还留着一个同名的旧条目,且它的优先级更高,结果调用时用的仍是旧令牌,你盯着项目文件怎么也看不出问题。
排查方法其实很机械、很可靠:不要靠读文件猜,直接用客户端的列表命令看当前实际加载了哪些服务、来自哪个作用域、状态如何。 一旦看到同名条目有多个来源,幽灵就现形了。处理时要么删掉多余的旧条目,要么把名称区分开。养成「改完用列表命令确认来源」的习惯,能帮你省下大量「为什么改了不生效」的时间。
还有一类隐形问题是环境变量的作用范围。你在一个终端窗口里 export 的变量,只对从该窗口启动的客户端有效;如果客户端是从图形界面或另一个终端启动的,它根本看不到这个变量,于是占位符不被替换、鉴权失败。排错时要确认变量确实存在于启动客户端的那个环境里,而不是你以为的某个窗口。
六点八、版本与兼容:一个常被拖到最后的坑
配置类问题里,版本兼容是那种「一切看似都对、就是不工作」的典型,值得单独强调。
MCP 协议本身在演进,客户端和服务端会在握手时协商版本与能力。当两端版本差距较大时,可能出现初始化字段对不上、某方声明了另一方不认识的能力,表现为连接建立了却拿不到工具,或干脆握手失败。这类问题最迷惑人的地方在于:网络是通的、凭据是对的、命令也能跑,你在前面几层都查不出毛病,问题却实实在在。
对治方法很直接:保持客户端在较新的稳定版本,并在排错走到「能力发现」这一层仍无头绪时,把「升级客户端」作为一个明确动作,而不是无限怀疑配置。 升级后务必重开会话,让双方用新版本重新握手。对自托管的远程服务,也要留意服务端版本与团队客户端版本之间的兼容区间,避免「服务端悄悄升级、老客户端集体失灵」。
一个团队层面的好习惯是把经过验证的客户端版本区间记录在内部说明里,服务端做可能破坏兼容的升级前提前通知。把版本当作连接的一个显式要素来管理,而不是默认「最新就好」或「能装就行」,你就能避开这类最隐蔽、也最耗排查时间的问题。
七、常见问题
Q:配置后为什么工具没有立刻出现? 通常需要重开连接或重启会话,让客户端重新初始化、拉取工具列表;如果仍没有,按能力发现层排查握手。
Q:.mcp.json 和命令行注册会冲突吗? 它们可能写到不同作用域。重名时以客户端的作用域优先级为准;排查时用列表命令看清当前实际生效的是哪一个。
Q:stdio 服务能不能多开几个项目共享? 每个客户端连接通常会各自拉起一个进程。想多项目共享同一个常驻服务,更适合部署成远程 HTTP 形式,让大家连同一个地址。
Q:为什么我在命令行里能跑通,客户端里却失败? 最常见是两处环境不同:客户端启动时的 PATH、工作目录或环境变量与你当前终端不一致,导致找不到命令或读不到变量。排错时要以「客户端实际运行的环境」为准,而不是你手动测试的那个窗口。
Q:配置文件里一定要用变量占位吗,直接写 Key 行不行? 本地临时测试可以,但凡是要进版本控制、或可能被他人看到的文件,都不应明文写密钥,否则极易随提交泄露。养成用环境变量注入的习惯,几乎零成本,却能挡住最常见的密钥事故。
Q:一次性接入了很多服务,为什么反而更难用? 工具过多会让 Agent 在选择时混淆、也扩大了凭据暴露面。建议按需逐个接入,先把真正高频的服务接好、跑稳,再评估是否需要更多;保持一个「当前实际在用」的精简集合,远比堆满用不到的连接要安全、好用。
八、上线前检查清单
- 作用域选对了吗?个人凭据没有放进项目仓库。
- stdio 命令能在干净终端手动跑通;远程 URL 可达。
- 令牌通过环境变量注入,没有明文写死。
- 列表命令显示服务已连接、工具可见。
- 用一个只读调用验证了连通,再开放写入能力。
总结
配置 MCP 就是登记「连接位置、授权凭据、可用能力」三件事:按 local/project/global 选作用域,本地用 stdio 启动命令、远程用 HTTP 加令牌,命令行适合快速添加、配置文件适合团队共享;连不上时按传输→进程→鉴权→能力发现逐层排错,并始终坚持凭据不进仓库、最小授权,就能把外部服务稳稳接进你的 Agent。