团队推广 Agent 的路线图
系列入口:如何使用 Agent。进入 M10「团队与企业落地」。
一、推广为什么常常失败
常见的推广方式是"采购一批许可证、群发一份使用说明、要求大家用起来"。结果往往是:少数积极分子飞速提效,多数人浅尝辄止,还有人踩坑后彻底不信任;用法和规则散落各处,同一个问题每人重新踩一遍。
根因是把"工具到位"当成了"能力到位"。Agent 的有效使用依赖一整套协作能力——会澄清任务、会给上下文、会验收、会防幻觉——这些只能通过分阶段、有样板、有规范、有反馈地建立。推广本质上是组织学习,而不是软件分发。
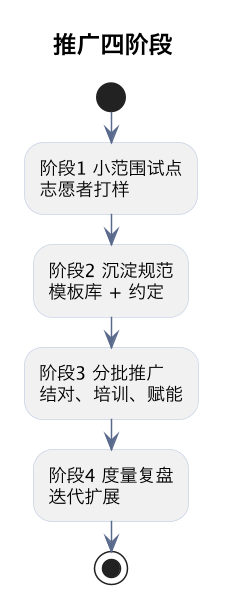
二、阶段一:小范围试点,先打出样板
不要一上来全员铺开。先选一小群有意愿、任务有代表性的志愿者,给他们较好的支持,目标是在真实工作里跑出可信的成功案例、同时暴露真实的坑。
试点要解决几个问题:在我们的代码库和任务类型上,Agent 到底在哪类工作提效、哪类帮倒忙?需要补哪些基础设施(规则文件、命令、权限)?有哪些安全和合规红线?让试点者记录真实的周期时间、返工和失败案例(而不只是高光时刻),这些一手证据是后续推广最有说服力的材料。试点的产出不是‘大家说好用’,而是一套被验证过的用法、边界和样板。
三、阶段二:沉淀规范与共享模板库
试点验证后,把个人的成功经验从"某个人会"变成"团队可复用"。
这一阶段建立共享约定与模板库(详见下一篇):统一的规则文件(如团队 AGENTS.md)、常用斜杠命令、Skill、子 Agent、验收清单和分场景的操作手册。重点是把试点中反复出现的好做法和高频陷阱固化下来,让新人不必重新发明。规范要少而管用——只沉淀真正被多次验证的,避免堆砌一套没人看的繁文缛节;同时明确安全红线:哪些数据不能外发、哪些操作必须人工。
四、阶段三:分批推广与赋能
有了样板和模板,再分批扩大使用面,而不是一刀切。
通过结对演示、场景化培训、随队答疑帮人上手,培训内容紧贴他们自己的任务("你日常这类活怎么用"),而非泛泛讲功能。给每个新团队安排"上手初期"的支持,因为此时最容易因不熟练、几次失败而放弃。可以让试点骨干充当内部教练,把经验带过去。推广节奏与团队的吸收能力匹配,确保一个团队真正用顺了、再扩下一个,比追求"覆盖率 100%"更重要。
五、阶段四:度量、复盘与迭代
推广后进入持续运营。用提效度量按任务类型观察周期时间、返工率、缺陷和成本,判断真实收益;定期复盘:哪些做法有效、哪些规范形同虚设、出现了什么新问题。
把复盘结论回流:更新模板库、补充规则、调整培训,并把新的典型故障做成评测样本。随着团队成熟,可以逐步把更多流程自动化、把高价值判断留给人。推广不是一次性项目,而是‘试点—规范—推广—复盘’循环上升的过程,每一轮都让协作水位提高一点。
六、让试点产出真正可复制
试点最容易被浪费的方式,是只收获了"几个人说好用",却没有把他们的用法变成别人能照搬的东西。要让试点的成果可复制,需要有意识地采集几类产物。
一是场景化用例库:不要笼统记"写代码变快了",而是记录"在某某类型的任务上、原来大概多久、用什么步骤、得到什么结果、要注意什么坑",最好附带真实但脱敏的例子。后来者面对同类任务时可直接照走。二是反例清单:哪些任务试了反而更慢、哪些场景下 Agent 容易带偏、为什么——这部分比成功故事更能帮新人避坑,也直接划出使用边界。
三是基础设施缺口:试点中发现"要是有某条规则/某个命令/某种权限就好了",把这些列为推广前要补齐的事项,让第二批人起点更高。四是可信的度量:用统一口径记录周期时间、返工、缺陷,使推广决策有数据支撑而非轶事。这样试点结束时,你交出去的不是一份热情洋溢的总结,而是一套"可照做的用例 + 可信的边界 + 待补的设施",规模化才站在坚实地基上,而不是靠复制几个高手。
七、各阶段成败标志
| 阶段 | 成功标志 | 危险信号 |
|---|---|---|
| 试点 | 有可信案例与真实边界清单 | 只收集到好评、无失败记录 |
| 规范 | 模板被实际复用、红线清晰 | 一堆文档没人看 |
| 推广 | 各团队能独立稳定使用 | 开通率高、真实使用率低 |
| 复盘 | 指标改善、模板持续更新 | 数字漂亮但质量/信任下降 |
七、常见问题
Q:团队里有人强烈抵触怎么办? 先理解顾虑(怕出错、怕被替代、不信任输出),用试点的真实数据和具体场景回应,让其在低风险任务上先尝甜头,而非强压;保护不被用于考核个人尤其重要。
Q:要不要把使用率纳入 KPI? 谨慎。强考核会催生刷数据、挑简单活,反而损害真实提效与如实反馈;应度量团队整体的交付改进,把工具使用定位为支持手段。
Q:规范会不会拖慢创新探索? 规范只固化高复用、高风险的部分,保留空间让人尝试新用法,再把验证有效的新实践定期纳入,规范是活的护栏不是枷锁。
Q:多团队技术栈差异大怎么推? 统一原则与安全红线(验收、权限、数据合规),具体模板允许各团队按自己的栈定制,再横向分享可迁移的经验。
八、把推广变成可持续的运营
当多数团队都已上手,推广就应从"项目"转为"运营"——能力会随人员流动、工具升级而衰减,需要持续维护。
纳入新人入职:把 Agent 用法、模板和安全红线变成 onboarding 的固定一环,让每批新人都在引导下起步,而不是靠老员工口头传授。保留内部教练网络:各团队有可答疑、能发现问题的骨干,并定期交流新实践,避免知识再次沉淀回个别高手。追踪健康度而非覆盖率:持续看真实使用率、任务类型分布、交付指标和失败反馈,关注"用得好不好",而不只是"有没有开通"。
定期更新资产:模型能力变化后,重新评估使用边界、刷新模板和评测集,让做法与时俱进。这种运营心态能防止"推广成功"之后慢慢回退到各自踩坑的状态。真正的终点不是全员开通,而是形成一种自我更新的机制:无论人员和工具如何变化,团队都能稳定地把 Agent 用好、并持续提高水位。
九、用好度量而不踩考核雷区
推广离不开度量,但度量用错地方会直接摧毁信任,必须从一开始就划清界限。
度量指向系统改进:观察团队整体的周期时间、返工率、缺陷与按任务类型的差异,用来决定补什么规则、改什么流程,而不是给个人打分排名。保护如实汇报:明确"用了反而更慢、Agent 出了错"不会被追责,负面信号才能自由浮现,这是校准使用边界的前提。警惕刷数据:一旦工具使用与奖惩挂钩,就会出现挑简单活、刷采纳率,数据随即失真。
统一口径、端到端计算:把验证与返工耗时计入,避免用单环节的提速自我夸大。当团队相信"数据是帮大家省事、不是盯着个人",度量才能发挥正面价值,推广也才建立在真实而非粉饰的反馈上。
十、安全红线要先于效率讲清
推广速度再快,也必须在团队大规模使用前把安全边界立住,否则一次事故会让全部信任归零。
明确数据与操作红线:哪些敏感数据不能外发、哪些操作必须人工确认、Agent 访问系统默认只读最小权限,这些应成为人人皆知、且由技术默认强制的底线。试点期就暴露风险:在小范围把可能的越权、泄露和误操作摸清,带着防护方案推广,而不是等全员铺开后补救。把红线写进模板与 CI:让安全成为工作流的一部分,而非靠个人记忆。当效率与安全被同时设计,团队才敢于真正把重要工作交给 Agent,推广也建立在可持续而非侥幸的基础上。
十一、从推广到治理的自然衔接
当团队规模和接入系统扩大到一定程度,单纯的推广路线图就需要与企业治理衔接,这不是另起炉灶,而是同一过程的深化。
推广中沉淀的统一身份、模板库、安全红线,正是后续访问控制、审计与数据合规的基础;随着风险上升,再把权限收紧、把审计和合规要求制度化。关键是平滑过渡——在大家已习惯的协作方式上逐步加治理,而非突然叠加一套陌生体系。这样团队既保持了推广带来的效率,又在规模变大时获得了与风险相称的管控,Agent 的使用得以从"团队实践"稳健地走向"企业能力"。
Q:预算有限,推广最先投在哪? 优先投入试点支持和模板库这类"乘数"环节——它们让经验可复制,而非单纯买更多更贵的模型;少量可信样板和顺手的共享模板,对团队提效的拉动远高于堆许可证。
十二、检查清单
- 已选志愿者在真实任务上试点,记录收益与失败边界。
- 已沉淀少而管用的规则、模板库与安全红线。
- 通过结对与场景化培训分批推广,配有内部教练。
- 用交付指标衡量真实提效,定期复盘并回流模板。
- 度量用于改进流程、与个人考核解耦。
总结
团队推广 Agent 应按组织学习的节奏分四步走:先用志愿者在真实任务上试点、得到可信样板和真实的能力边界,再把高频好做法和安全红线沉淀成人人可复用的规范与模板库,然后靠结对、场景化培训和内部教练分批赋能、用顺一批再扩一批,最后用面向交付的度量和无考核压力的复盘持续迭代;避免"全员开通即成功"的错觉,让能力、规范和信任像产品一样逐步长出来,推广才能从少数人的提效变成整个团队稳定的工程能力。