何时该中断并纠偏
系列入口:如何使用 Agent。这是 M2 心智的最后一篇,前置阅读:你是驾驶员。
一、最考验功力的是「什么时候打断它」
Agent 跑起来之后,你面对的是一个动态过程:它不断地改、不断地跑命令、不断地根据结果调整。这时候最难的判断不是怎么开头,而是——现在该不该叫停?
打断太频繁,它没法发挥自主循环的优势;完全不打断,它可能在错误的路上越跑越远,等你反应过来,改动已经盘根错节。这篇给你三类清晰的「必须叫停」信号,让判断有依据而不是凭直觉。
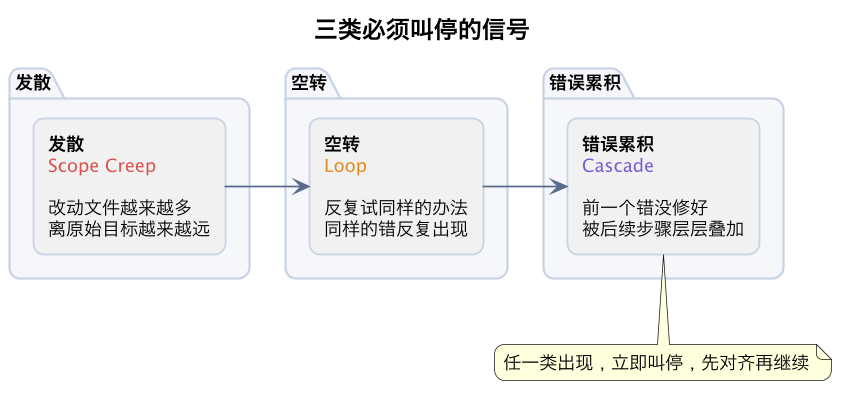
二、信号一:发散——它在不断扩大战线
表现:本来只让它修一个函数,结果它开始「顺手」重构相邻模块、改公共配置、引入新依赖;改动的文件越来越多,离你最初的目标越来越远。
怎么识别:看它连续几步都在动与目标无关的地方,或者它开始说「顺便我还优化了……」。Agent 有时会出于「把事情做完整」的冲动自行扩大范围。
怎么纠偏:立刻停下,把它拉回边界——「先只解决原来的问题,其他改动一律撤回,重构以后单独做。」必要时用 git 还原越界的部分。这也是为什么下任务时要划清边界。
为了更早发现发散,给你几个比「文件变多」更早的预警信号,它们往往在改动面失控前就出现:
- 它的解释里开始出现「顺便 / 顺带 / 为了更完整」。这类措辞说明它已经在给任务之外的动作找理由,此刻纠偏成本最低。
- 它要引入新依赖、新配置,而原任务根本不需要。比如修一个文案 bug 却提出加一个工具库,这是典型的目标漂移。
- git status 里新增的文件,开始和你确认的清单对不上。哪怕只有一两个,也要追问,别等「就多这一个」累积成一大堆。
- 它对「这一步为什么要做」的回答,绕回不到原始目标。让它把当前动作和目标连一条线,连不上,就是发散。
真实例子:你让它「修登录页按钮没反应的问题」。第一轮它正确地发现是事件没绑定;第二轮却开始说「这个表单组件比较旧,我顺便升级一下组件库」;等你注意到,它已经改了八个文件、升级了一个大版本,引入了两处不兼容。如果在它第一次说「顺便升级」时就叫停,只保留第一轮那一处正确修复,整件事两分钟就结束了。发散几乎总是以一个听起来合理的「顺手」开头,你的工作就是在那个开头处把线按住。
三、信号二:空转——它在原地打转
表现:同一个错误反复出现,它换汤不换药地一次次重试;或者在两个方案之间来回横跳,改了又改回。你看到的是命令跑了一轮又一轮,问题没有实质进展。
怎么识别:连续 2~3 次尝试后,报错的核心没变;它给的「新办法」其实是旧办法的微小变体。模型在信息不足时容易陷在这种循环里空烧 token。
怎么纠偏:别再让它盲目试。叫停后补充信息或换个角度——把完整报错、相关日志、你对原因的猜测给它;或者让它先停下来分析「为什么前几次都失败」,而不是立刻再试一次。很多时候需要你提供一个它看不到的关键事实。
空转最可惜的地方,是它看起来特别努力:命令一轮轮跑、方案一次次给,给人「马上就要解决了」的错觉,于是你不忍心打断,结果时间和 token 都在原地被烧掉。识别空转的关键,不是看它试了多少次,而是看每一次尝试有没有带来新信息。给你三个判据:
- 连续两三次的报错,核心信息是不是同一条?如果错误的位置、类型、根因都没变,只是表象措辞略不同,那它其实在重复。
- 它所谓的「新方案」,是不是只改了参数、顺序、命名之类的皮毛,而没有触及不同的原因?
- 每一轮结束,它对「问题为什么发生」的理解有没有变深?如果理解原地不动,只是动作在变,就是空转。
纠偏时,「先停下来分析」往往比「再试一个办法」有效。你可以明确要求它换一种动作:「不要再尝试修复了。先列出你已经试过的办法、各自失败的结果,然后基于这些证据推断最可能的根因,以及你还缺什么信息。」这能把它从「行动模式」切到「诊断模式」。更常见的情况是,真正缺的是一个它根本看不到的事实——某个环境变量、某段没读过的配置、某个服务的版本差异——这时候你提供那一条关键信息,比让它再试十次都管用。空转是在提示你「当前信息不足以收敛」,正确反应是补信息,而不是加尝试。
四、信号三:错误累积——小错被层层叠加
表现:第一步就埋了个理解错误,但它没停下,而是在错误的前提上继续构建,后续每一步都为了迁就前面的错而加补丁,改动越来越拧巴。
怎么识别:代码开始出现不自然的 workaround(绕路补丁)、改动之间自相矛盾、它为了让东西跑通而不断打补丁却不碰根因。这类问题最隐蔽,因为表面上它「一直在推进」。
怎么纠偏:一旦发现根子上的前提错了,果断回到出错的那一步重来,而不是在上面继续打补丁。用 git 把之后的改动清掉,先修正基础认知,再重新往下走。越早回头,损失越小。
错误累积是三类信号里最隐蔽、也最危险的一类,因为它表面上「一直在推进」——文件在增加、功能在成形、甚至测试在变多——你很难像对待空转那样凭「没进展」发现它。要识别它,得盯着「改动的质地」而不是「进度的数量」,几个典型征兆:
- 开始出现不自然的绕路补丁:为了迁就前面的错误假设,后面不断加特殊判断、临时转换、层层适配,代码越来越拧巴,而不是越来越顺。
- 改动之间自相矛盾:前面建立的约定,后面又被破坏,或者两处逻辑需要不断手动保持同步。
- 它一直在让东西「跑通」,却始终不碰那个最初的根因,每次都是在症状层面补洞,而补丁本身又引出新问题。
- 解释越来越长、越来越绕:当它需要用很复杂的说法才能解释一个本该简单的设计,往往说明底层前提就错了。
真实例子:你让它实现一个折扣计算。第一步它错误地理解了「折扣」的基准(按原价而不是折后价叠加),算出第一版。后面为了让结果对上,它不断加修正系数、加特殊规则处理叠加场景、加补丁兜底边界,写了一大坨逻辑,测试却总有奇怪用例对不上。此时如果继续在上面补,只会越来越复杂;正确动作是识别出「第一步的基准就理解错了」,用 git 回到那一步,先把基准修正,再让后面逻辑自然长出来——往往代码能少一大半。错误累积的应对原则只有一条:补丁摞补丁时,别再补,回到第一个错的前提。
| 信号 | 典型迹象 | 纠偏动作 |
|---|---|---|
| 发散 | 文件越改越多、偏离目标 | 拉回边界、撤回越界改动 |
| 空转 | 同样的错反复、原地打转 | 补充信息、先分析再试 |
| 错误累积 | 补丁摞补丁、自相矛盾 | 回到根因那步重来 |
五、叫停之后,怎么重新起步
中断本身不是目的,关键是叫停之后怎么高效恢复。这里把恢复动作再讲细一点,因为很多人叫停后反而卡在「然后怎么办」。
- 先回到最近一个干净的点(上一次验收通过的状态),别在混乱的中间态上继续。恢复前先确认你站在一个已知正确的基础上。
- 用一句话重新对齐目标和当前认知,明确指出刚才错在哪、接下来的边界。最好让它复述,确认这次理解一致。
- 必要时回到 Plan:方向乱了就重新出方案,确认一致后再执行。
- 把这次的教训记下来,沉淀进规则文件或记忆,避免下次在同一个地方再发散。
恢复时还有两个容易忽略的点。一是别急着立刻重跑,先花一分钟确认「导致上次失败的信息缺口是否真的补上了」——如果缺的那条事实还没给,重跑只会再次空转。二是恢复的第一步尽量小,先让它做一个最小、可验证的动作,确认方向这次对了,再放开步子,而不是一恢复就又给一个大任务。这样即使还有偏差,也会在最小范围内被发现。
为了让你在实战中快速判断,下面这张表把三类信号的「核心问题—最省力的观察点—首要动作」并排放在一起,跑任务时扫一眼即可:
| 信号 | 本质问题 | 最省力的观察点 | 首要动作 |
|---|---|---|---|
| 发散 | 边界在移动 | 是否出现「顺便」、文件是否超清单 | 按住范围、撤回越界 |
| 空转 | 信息不足 | 报错核心是否变化、是否带来新信息 | 补信息、先诊断 |
| 错误累积 | 前提错了 | 是否补丁摞补丁、设计是否变拧巴 | 回到错误前提重来 |
再给你一个简单的心理阈值,帮你形成节奏感:普通任务以两三轮为观察单位,如果两轮内既没有向目标收敛、又在重复或扩大,就触发一次认真检查;复杂任务可以放宽到四五轮,但要求每一轮都能看到明确的新增理解或向目标靠近。这个阈值不是硬规定,而是让你有个「到点就抬头看一眼」的提醒,避免一头埋进去放任太久。配合前面讲的分小步和检查点,你会越来越自然地在「让它跑」和「停下来对表」之间切换。
把这套「识别信号 → 叫停 → 回干净点 → 重新对齐」练成肌肉记忆,你就能在 Agent 自主和人工掌控之间找到平衡——既不频繁打断,也绝不会放任它把小偏差滚成大事故。
六、关于「叫停」,要扭转一个成本直觉
很多人不敢叫停,是因为心里有个账:「它都做了这么多了,现在打断是不是浪费?」这就是沉没成本陷阱。需要看清的是:已经走错的部分,不会因为你继续走下去而变对,反而会让要清理的东西越来越多。
正确的账应该这么算:叫停的成本,是放弃眼前这部分(常常还能用 git 直接回退,代价很小);不叫停的成本,是让错误继续向后续步骤扩散——更多错误代码、更难定位的 bug、以及将来更大范围的返工和事故。随着时间推移,这两条成本曲线是反向拉开的:纠越早越便宜,越晚越昂贵。所以当三类信号出现时,「它已经做了很多」恰恰是更该立刻停的理由,而不是舍不得的理由。
这也解释了为什么本模块反复强调前置动作——划边界、先 Plan、分小步、设检查点。它们的共同作用,是让错误在代价最小的阶段暴露:每一步都小、每一步都验证,那么即使叫停,损失也被限制在很小的范围里。你会因此更敢叫停,而不会因为「一停就要损失一大片」而犹豫。从这个角度看,前面所有方法其实都在降低你踩刹车的成本,让「及时纠偏」成为一个轻松、划算、做得出来的动作。
最后提醒一个分寸:叫停是为了纠偏,不是为了收紧到不让它自主。不要因为怕失控就回到事事指挥、频频打断,那会牺牲 Agent 的核心价值。目标始终是那个平衡——平时大胆让它跑,但一旦看到真实信号,果断、低成本地把它拉回来。能在「放手」和「踩刹车」之间自如切换,才是这篇真正想帮你建立的能力。
七、常见问题
Q:我盯着它也没看出信号,等发现时已经晚了,怎么办? 把盯的重点从「看它写什么代码」转到更省力的几个客观信号上:git status 的文件是否超出清单、报错核心有没有变、有没有出现「顺便」这类措辞和绕路补丁。你不必逐行读懂代码,盯这几个结构性信号就能发现大多数问题,且这些信号不依赖深厚专业功底。
Q:叫停后一定要 git 回退吗?能不能让它就地改? 要看问题性质。发散但越界部分清晰,可以只撤回越界文件;空转时通常不必大回退,补信息即可;但错误累积往往意味着地基错了,在混乱的中间态上就地改容易越改越拧,回到最近一个干净点重来反而更快。原则是别在错误的基础上继续盖楼。
Q:会不会我误判了,其实它没跑偏? 有可能,而误叫停的代价通常很小(多看一眼、重新对齐而已);但漏判、放任的代价可能很大。在信号面前,这种风险是不对称的——宁可多停一次确认,也别为了不打断而赌它一定对。叫停不丢人,失控才麻烦。
Q:这些教训怎么避免重复犯? 每次纠偏后,把暴露出的问题沉淀下来:属于该守的边界或约定,写进规则文件;属于会反复出现的检查,固化成钩子;属于项目背景,存进记忆。让一次踩坑变成长期生效的机制,而不是只靠下次记得小心。
总结
看到发散、空转、错误累积三类信号就要果断叫停:回到上一个干净状态、补齐认知、重新对齐后再走——真正的掌控感,来自你知道在什么时候踩刹车。