AI 生成代码的版权与 License 合规
系列入口:如何使用 Agent。M12 收尾篇。
一、为什么"AI 写的代码"也要谈版权
一个普遍误解是:既然是 AI 生成的,代码就没有版权、可以随便用。现实更复杂。模型在大量代码(包含受版权保护的开源项目)上训练,它的输出有时会与训练语料中的代码高度雷同,甚至逐段复现;而各地法律对"AI 生成物能否享有版权、侵权责任在谁"仍在演变,并无统一答案。
对企业而言,风险是真实的:一段看似无害的生成代码,可能复刻了 Copyleft(如 GPL)许可的代码,从而"传染"整个私有代码库,要求你开源;也可能在未来引发侵权索赔或归属争议。 这不意味着不能用 Agent,而是要在享受效率的同时,用工程和政策手段把 IP 风险管起来。
⚠️ 本文是工程层面的风险科普,不构成法律意见。涉及具体许可解释、商用或开源发布的重大决策,请咨询专业法务。
二、风险一:输出复现训练数据中的代码
模型有时会"背出"训练语料里的片段,尤其当提示词包含某段著名代码的开头时。如果这段代码来自一个许可证严格的项目,你把它用进产品,就可能构成侵权或引入许可义务。
工程上的缓解:了解你所用服务的训练数据与输出权属承诺——主流商用工具通常提供一定的侵权赔偿和"不使用受限数据"的保证,这也是企业选型的重要标准;对生成的关键代码,可用代码相似度/片段匹配工具扫描,检查是否与已知开源项目雷同;发现高度雷同的片段,重新生成或人工重写。
三、风险二:Copyleft 许可证"传染"
开源许可证不是一种,关键区别在Copyleft 强度:宽松型(MIT、BSD、Apache-2.0)通常只要求保留声明,可自由用于闭源产品;而强 Copyleft(GPL 系列等)要求衍生作品在分发时也以相同许可开源。
风险在于,如果生成代码实质复制了强 Copyleft 代码、或 Agent 把这类代码片段引入你的项目,可能触发你本不想要的开源义务。应对:在 CI 中加入**许可证扫描(如 SCA 工具)**识别引入代码的许可证、维护一份公司允许/禁止的许可证清单、对命中强 Copyleft 的代码阻断并交合规复核。这与依赖治理的常规做法一致,只是现在检查对象多了"AI 生成部分"。
四、风险三:企业代码的 IP 归属与保密
对公司还有两层问题。一是保密:把私有源码发给外部模型,可能违反保密义务、或被用于再训练(虽然多数商用服务承诺不用客户数据训练,但需以合同为准)——敏感代码应走有合同保障或私有部署的通道(见访问控制与合规)。
二是职务成果归属:员工用 AI 辅助完成的代码,作为职务成果的 IP 通常仍归公司,但应在政策中明确"允许使用、如何使用、责任在员工",避免灰色地带。
五、把合规做进工程流程
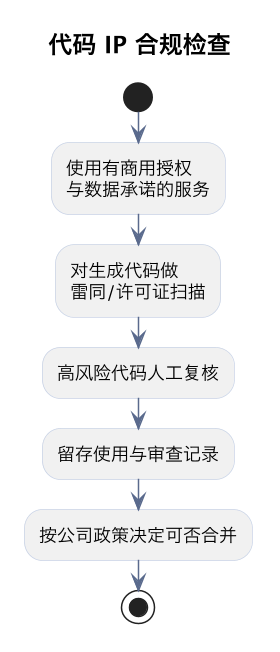
可落地的几道闸:选型优先提供商用授权、侵权赔付和数据不用于训练之合同保障的服务;扫描在流水线中对依赖和疑似复制的生成代码做许可证与相似度检查;复核对高风险、核心模块的生成代码由人确认来源;留痕保存使用了哪些工具、谁审查过,便于事后举证;政策明确允许范围、禁用清单和审批路径。让合规默认生效,而不是靠人记得(与安全护栏同理)。
六、个人项目 vs 企业产品
风险随场景变化:个人学习/不公开的项目风险较低,主要避免直接复制粘贴来源不明的大段代码;开源发布要确保你有权按所选许可证发布、保留第三方声明;商业闭源产品最需警惕 Copyleft 传染和雷同,应有扫描和政策。开源自己的作品时,也要确认 AI 生成部分的权属在你的发布地可被主张,避免后续争议。
七、一次许可证扫描拦下的风险
看一个具体险例,理解扫描的价值。
某团队在发布前的 CI 里跑许可证扫描,工具告警:一段由 Agent 生成的加密工具代码,与一个 GPL 许可的开源库高度雷同。追溯发现,工程师当时让 Agent"实现一个 XX 算法",模型基本背出了该 GPL 库里的实现。由于在发布前命中、且公司政策对强 Copyleft 一律阻断,团队改用一个 Apache-2.0 许可的等价实现并重写了关键部分,避免了把整个私有产品拖入开源义务。
如果这段代码上线后才被发现,处理成本(替换、重新发版、甚至潜在争议)会高得多。这个险例说明,风险往往不是人故意抄、而是 Agent 在"实现一个常见算法"时无意识复现了受限代码;把相似度和许可证扫描做进发布门禁,让这类问题在成本最低的阶段暴露,是工程上最划算的防线,而信任模型"应该不会抄"则是最不可靠的假设。
八、给团队的一份最小政策模板
不必一上来就写厚重制度,一个几页纸的最小政策就能覆盖主要风险。
建议至少回答:允许使用哪些工具(须有商用与数据承诺)、可以用来做什么/禁止做什么(如禁止把受限机密外发)、使用要求(生成代码需经审查、核心代码要扫描)、责任归属(使用者对结果负责)、遇到疑似复制或许可证问题找谁、以及留痕要求。把它与现有的安全、开源政策衔接,而不是另起炉灶。
政策的关键是简单、可执行、有明确入口,让普通工程师知道"我可以用、但要这样用、有问题问谁",而不是面对模糊禁令、要么不敢用要么偷着用。先用最小版跑起来,随真实问题再迭代细化,比追求一次完备更现实。
九、保留"善意使用"的证据链
万一未来出现争议,能否证明自己是善意、合规地使用工具,可能非常重要,而这些证据靠平时积累。
建议留存:所用工具的商用授权与服务条款、生成代码经过人工审查和扫描的记录、对疑似雷同问题的处置过程、以及公司政策的执行痕迹。这些记录能说明你并非故意侵权、且建立了合理的防护流程。合规不仅是"做到",还包括"能证明你做到了",尤其在法律仍在演变的领域,一条完整、可追溯的善意使用证据链,是企业保护自己的重要一环。
十、区分"事实陈述"与"法律结论"
在团队里讨论这类问题时,工程师容易越界给出"这样肯定合法/非法"的断言,反而误导决策,需要有意识地区分。
你可以陈述事实:这段代码与某库雷同、该库是什么许可证、公司政策怎么规定;但"这是否构成侵权、能否这样发布"属于法律结论,应留给法务。让流程把两者分开——工程侧负责发现事实和执行扫描,合规/法务侧负责下判断。既不因为"听说没事"就放行,也不因为"感觉有风险"就恐慌,用清晰的角色分工让每个结论由合适的人给出,是平衡效率与风险的组织保障。
十一、把合规检查"左移"到开发环节
等到发布前才发现 IP 问题,返工成本高;把合规检查左移到开发和提交环节,代价最低。
让扫描工具在本地或 PR 阶段就提示许可证与雷同问题、把政策要点放进 Agent 的规则让它在生成时就避开受限代码、作者在写的时候就能看到风险。问题发现得越早,修正成本越低——这与测试左移、安全左移是同一逻辑。当合规成为开发过程中即时、无感的一环,而不是发布前的一道突击关卡,团队既能放心用 AI 提效,又不会在最后关头被迫返工或带病上线。
十二、持续跟踪法律与判例的演变
AI 版权领域的规则仍在快速变化,今天的最佳实践可能随新立法或判例而调整,需要保持关注。
由法务或合规角色跟踪相关司法进展、定期审视公司政策是否需要更新,避免沿用过时假设。工程团队则通过政策更新获得明确指引,而非各自猜测。在不确定的领域,政策本身也应是"活"的。 把跟踪变化作为一项固定职责,能让你的合规实践始终贴近最新现实,既不过度保守错失效率、也不滞后于新出现的风险——这是快速演变领域里组织保持稳健的必要功课。
十三、常见问题
Q:AI 生成的代码到底算不算我的? 各地法律不一,且"纯自动生成、无人的创造性贡献"的部分可能不被授予版权;但人对代码做了实质性设计、选择与修改的,通常更容易主张权利。具体问法务。
Q:用了 AI 就要开源我的项目吗? 不是。只有在引入了强 Copyleft 代码并触发其条件时才有此风险;正常使用有商用承诺的工具、避免复制受限代码,一般不导致开源义务。
Q:怎么知道生成代码是不是抄的? 无法 100% 确定,可用相似度扫描、对著名片段保持警惕、并依赖服务商的合同承诺与侵权赔付。
Q:公司完全禁止用 AI 写代码最安全吗? 安全但牺牲了巨大效率;更平衡的做法是选合规服务、加扫描与政策,在可控前提下使用。
八、检查清单
- 所用服务具备商用授权、数据与侵权赔付的合同保障。
- 已对生成代码做相似度与许可证扫描。
- 已维护允许/禁止的许可证清单,强 Copyleft 阻断复核。
- 敏感代码走合同保障或私有部署通道。
- 已明确公司使用政策、责任归属并留存审查记录。
总结
AI 生成的代码并非天然无版权风险:它可能复现训练语料中的受限代码、引入强 Copyleft 的"传染"义务、并牵涉企业代码的保密与 IP 归属,而相关法律仍在快速演变;务实的合规不是禁用,而是把管控做进工程——选择有商用授权、数据不用于训练和侵权赔付承诺的服务,在流水线里对生成代码和依赖做相似度与许可证扫描、维护允许与禁用清单,命中强 Copyleft 就阻断复核,敏感代码走私有或合同保障通道,再用明确的公司政策规定允许范围和员工责任、并留存使用与审查记录;个人项目风险较低,商业产品最需谨慎,且所有重大许可与发布决策都应咨询专业法务——在大胆使用 Agent 的同时守住知识产权底线,效率与合规本可以并行。