日志分析与可观测排障
系列入口:如何使用 Agent。M12 第 7 篇。
一、可观测数据的"信息过载"难题
现代分布式系统出问题时,证据并不稀缺,反而泛滥:几十个服务在短时间内吐出几十万行日志、满屏跳动的指标、成百上千条 span。人的瓶颈是在有限时间和压力下,从噪声里捞出那条真正的因果链。
Agent 极擅长处理这类高容量、半结构化的数据:它能快速聚类错误信息、归纳异常模式、跨服务关联同一个 trace、读懂堆栈、比对正常与异常时段。它让排查者从"逐行翻日志"升级为"向一个读过全部日志的助手提问"。但在高压排障中,更要防止它把症状当根因、或被大量无关的次生错误带偏。
二、先圈范围,再喂日志
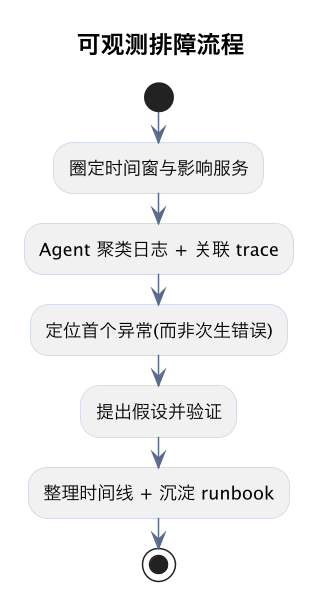
把全部日志无差别塞给 Agent 既不现实(超窗口)也会稀释重点。先用指标/告警圈定时间窗口和受影响的服务,再把这段窗口内相关服务的日志、关键 trace、异常栈有针对性地提供。
让 Agent 先做归纳而非检索:这段时间出现了哪几类错误、各有多少、最早从什么时候开始、涉及哪些服务。先得到错误的"分布地图",再深入具体某一类,比一上来扎进某条报错更不容易迷失方向。
三、追"第一个异常",区分症状与根因
连锁故障里,大量错误是次生的:下游超时引发上游一连串报错,真正的根因往往是时间线上最早的那一个异常。让 Agent 按时间排序,找出最早出现的异常、以及它如何引发后续错误,沿 trace 把跨服务的因果链串起来。
这一步要主动追问:"这是最早的问题,还是被别的故障触发的?""这条错误和用户可感知的症状之间是什么关系?" 警惕它挑了最显眼、但其实是结果的那条错误当根因。根因定位的核心是沿时间和调用方向回到"第一推动"(方法见故障修复实战)。
四、生成假设,并用数据证伪
Agent 可以基于日志快速提出几个可检验的假设(是新发版本导致?依赖超时?资源耗尽?配置变更?),关键是每个假设都要回到日志/指标/变更记录里去验证或排除,而不是接受它的第一个猜测。
让它列出"支持与反对"每个假设的证据,优先验证最能解释全部现象、且时间上吻合的那一个。遇到相互矛盾的证据,让它重新读取原始日志核对。排障质量取决于"假设—验证"的严谨度,而非解释听起来多合理。
五、控制噪声:过滤无关与重复
海量日志里大量是重复堆栈、已知无害告警、并发下的重复打印。让 Agent 做去重和归类:把同一根因的成百上千条堆栈折叠成一类、区分错误等级、滤掉与本次症状无关的背景噪声,让真正新颖、罕见、且与时间线吻合的异常浮现。这种"降噪"往往是定位的关键一步。
六、输出时间线,沉淀 runbook
排查过程中让 Agent 协助维护一条时间线:何时指标开始异常、何时发布/变更、各服务报错的先后、何时采取了止血动作。这条时间线既服务当下决策,也是事后复盘的素材。
确认根因和处置后,让它协助把这类问题的特征信号、排查步骤、止血手段整理成 runbook,下次类似故障就能快速分诊。让每次排障都降低下一次的平均定位时间,可观测协作才算形成复利。
七、一次"被带偏"的真实排查
看一个反面险例,理解追首个异常的重要。
告警显示"下单成功率暴跌",值班工程师让 Agent 统计错误,发现支付服务刷出海量"调用订单服务超时"。他差点让团队去查订单服务的性能。但他多问了一句"按时间排,最早的异常是什么",Agent 重新排序后发现:最先异常的其实是库存服务,它在 14:02 因一次配置变更开始拒绝连接;订单服务拿不到库存而堆积,反过来让支付调用订单时超时。 支付那片"最显眼"的错误纯属次生。
如果顺着最响的报警去查支付或订单,方向完全错了。这个险例说明:在连锁故障里,噪声最大的往往是结果而非原因;坚持让 Agent 回到时间线起点、沿 trace 验证"谁先失败、谁后失败",才能不被海量次生错误牵着走,把有限的止血时间用在真正的第一推动上。
八、指标、日志、Trace 三者配合
可观测性有三大支柱,高效排障要让 Agent 结合三者而非只看日志。
指标告诉你"出问题了、影响多大",用来圈范围;Trace 让你看到"请求在哪个服务/环节变慢或出错",用来定位;日志提供"具体发生了什么、堆栈和上下文",用来确认。让 Agent 的工作沿这个顺序:先用指标缩窗、再用 trace 锁定瓶颈环节、最后用日志和堆栈取到细节证据。
只看日志容易淹没在噪声里,只看指标又拿不到因果。三者串起来,才是一条从"现象"到"根因"的完整证据链。 当你的系统三者打通(有统一的 traceId 贯穿),Agent 跨服务关联的能力会成倍提升,排障速度也随之质变。
九、建立"症状→可能根因"分诊表
随着排障经验积累,把常见的症状和对应根因整理成分诊表,下次就能快速缩小范围。
例如:"成功率跌 + 某服务连接拒绝"→优先查该服务存活与配置变更;"延迟整体升高 + CPU 打满"→查资源与热点;"零星超时 + 无明显错误"→查网络与依赖抖动。让 Agent 基于当前症状对照分诊表给假设,但仍要用证据验证、防止生搬硬套。分诊表不是答案、而是加速假设生成的索引,它把团队过去踩过的坑变成了新人也能用的排障地图,显著缩短平均定位时间。
十、排障时的"假设记录"纪律
高压排障最容易东试一下西试一下,事后说不清哪步有效;维护一份假设记录能让排查更有条理。
让 Agent 协助列出每个假设、依据、验证方式和结果(成立/排除),按可能性排序逐个验证。这份记录既防止重复尝试同一思路,也让团队看到排查的逻辑、便于多人协作,更是事后复盘的直接素材。严谨排障是一个"提出假设—系统证伪"的过程,而非凭直觉乱试;当假设和证据都留痕,你不仅更可能快速命中根因,也能在过程中及时纠正方向。
十一、止血优先,根因可稍后深挖
生产事故中,时间压力下要分清"快速止血"与"彻底定位根因",两者节奏不同、不必强求一步到位。
先用可观测数据快速判断影响面、采取止损(回滚、限流、切流量、重启),把用户影响止住;根因的深度挖掘可以在服务恢复后从容进行。让 Agent 在止血阶段帮你快速归纳症状、在事后阶段再帮你细查根因和整理复盘。混淆两者、在火还在烧时执着于完美根因,会扩大损失。先恢复服务、再追查到底,是排障的基本优先级——而完整的时间线和假设记录,保证了你不会因匆忙止血而丢失事后定位根因的线索。
十二、把可观测能力"建设在平时"
Agent 排障的上限,取决于系统平时埋点和日志的质量;缺数据时再好的助手也无能为力。
平时就让日志带上必要上下文和统一 traceId、关键路径有指标覆盖、错误可被关联,这些投入在风平浪静时看不见、出事时却是定位的前提。可观测性是日常建设、不是故障时的临时祈祷。 当数据基础完备,Agent 才能真正发挥跨服务关联和归纳的威力;与其指望它从稀疏日志里神奇还原真相,不如把功夫下在平时,让证据在需要时本就齐全。
十三、复盘时让数据"自己说话"
事后复盘要避免主观归责,最有力的方式是让时间线、指标和日志客观还原经过。
让 Agent 协助把分散的证据整理成一条可核对的事实链,基于数据讨论根因和改进,而非凭印象或情绪。客观证据是无指责复盘的基石。 当结论建立在可追溯的数据上,团队更能聚焦"系统为什么让人犯错、如何改进",而不是"谁的错",这样的复盘才能真正推动改进、并让成员愿意如实上报问题——可观测数据的价值,因此不止于排障,也延伸到了团队学习和心理安全。
十四、让排障经验在团队内传承
个人积累的排障经验若不分享,团队整体能力提升会很慢;把它显性传承,复利才会形成。
把分诊表、runbook、典型案例放进团队知识库,并在故障后做简短分享,让新人也能站在这些经验上快速成长。让 Agent 协助把一次次排障整理成可教学的素材。当经验从"某个人会"变成"团队都能查",整体平均定位时间才会持续下降。 这种传承把个体的高压经验转成组织的韧性资产,也是可观测与排障工作最值得追求的长期回报。
十五、常见问题
Q:日志太多塞不进上下文怎么办? 先缩小时间窗和服务范围,让它聚类/抽样后再聚焦具体类别,分批读取。
Q:它会不会把无关错误当根因? 会,所以要求按时间找"最早异常"、沿 trace 验证因果链,而非采信最醒目的报错。
Q:日志里有敏感信息怎么办? 脱敏后再分析、走私有环境,遵循数据分级。
Q:能用它做实时告警分诊吗? 可以对告警做初步归类和摘要,但止血等动作仍需人确认,尤其在生产环境。
八、检查清单
- 已圈定时间窗与受影响服务,避免全量海喂。
- Agent 先聚类错误、关联 trace、画出分布。
- 已沿时间线定位最早异常而非次生错误。
- 假设均经证据验证,矛盾处回原文核对。
- 已输出时间线并把经验沉淀为 runbook。
总结
用 Agent 做可观测排障,是让它替你扛住"证据太多"的过载:先按告警圈定时间窗和相关服务、把日志有针对性地喂入,让它先聚类错误、关联同一 trace、画出异常分布,再沿时间线和调用方向追溯"第一个异常"以区分根因与次生症状,随后让它提出多个假设、逐一用日志和变更记录证伪,并用去重折叠把噪声压下去;最后输出完整时间线、把这类故障的信号与排查步骤沉淀成 runbook——在高压下它能把定位从翻日志的小时级缩短到分钟级,但你必须始终主导"什么是因、什么是果"的判断,并坚持每个结论都有原始证据支撑。