一个 Skill 的内部结构
系列入口:如何使用 Agent。先建立概念:Agent 与 Skill 分工模型。
一、Skill 本质上是一份「带目录的操作手册」
理解 Skill 结构,记住一个比喻就够了:它像一本操作手册,平时只把封面和目录摆在模型面前,需要时才翻开具体章节。模型不必每次都读完所有内容,而是先判断「当前任务要不要用这本手册」,用了再按需深入。这种「先看目录、按需展开」的设计,就是 Skill 和一大段写死在规则里的指令最大的不同。
一个 Skill 在物理上通常是一个目录,最核心的是入口文件 SKILL.md,外加若干按需读取的资源文件。
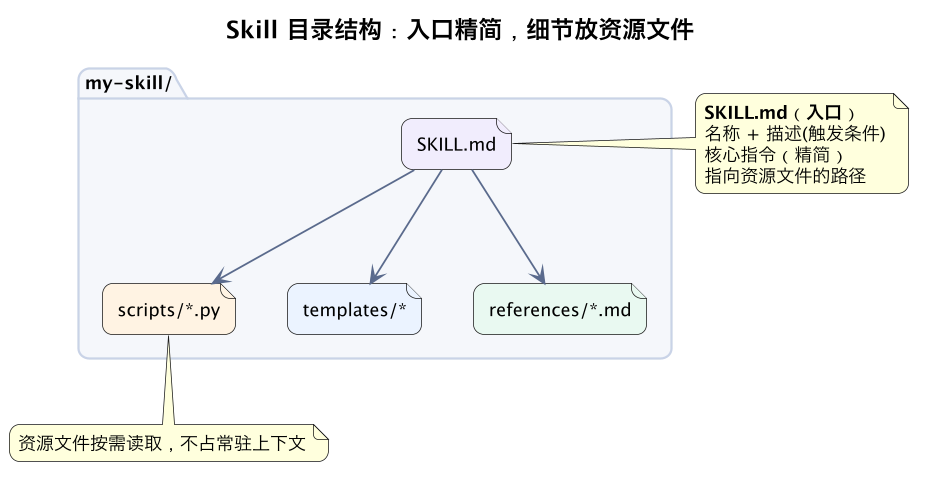
二、入口 SKILL.md 的三个关键部分
SKILL.md 是模型唯一会「先看到」的文件,一般包含:
1. 名称与描述(frontmatter)
---
name: code-review
description: 在提交前对改动做结构化代码评审,检查逻辑错误、边界条件和安全问题。当用户要求 review、审查代码或提交前检查时使用。
---
description 极其重要——它实际上是触发说明书:模型靠它判断「什么场景该调用这个 Skill」。描述里写清「做什么 + 什么时候用」,触发才准。
2. 核心指令(正文)
用简洁的步骤说明这个 Skill 被调用后该怎么做,比如评审的顺序、要检查的维度、输出什么格式。这部分要克制,只放每次都需要的主干。
3. 指向资源文件的路径
当任务需要更详细的内容时,指令里写明「需要 X 时读取 references/x.md」,把细节留到按需加载。
光看片段还不够,给你一个更完整、接近真实可用的 SKILL.md 入口,让你看到三部分如何组合:
---
name: pr-check
description: 在代码提交或发起合并前做结构化交付检查,包括跑测试、核对改动范围、检查提交信息格式。当用户说要提交、push、发 PR 或"检查一下"时使用。
---

# 提交前检查

按以下顺序执行,每一步未通过就停下并报告,不要自行绕过:

1. 查看改动范围:确认只包含本次任务相关文件,发现无关改动先提示。
2. 运行项目规定的检查命令(见仓库规则文件),不要凭记忆假设命令。
3. 核对提交信息是否符合团队格式。
4. 全部通过后,给出可提交的明确结论。

遇到这些情况再读取对应资源:
- 需要提交信息格式细则:`references/commit-convention.md`
- 需要处理大型重构的额外检查:`references/large-change.md`
- 可复用的检查脚本:`scripts/run-checks.sh`
这个例子有几个值得注意的点:描述里既写了「做什么」也写了「什么时候用」(含具体触发说法);核心主干保持在四步、每次都适用;细节全部通过「遇到 X 再读 Y」下沉,而不是堆在入口。一个好入口的判断标准是:只读它,模型就能正确开始;而任何低频细节都不必为「可能用得上」常驻。
三、触发条件:模型怎么决定用不用
Skill 不是你手动逐条执行的,而是模型在读到任务后,根据各 Skill 的 description 自主判断是否调用。这意味着:
- 触发准不准,很大程度取决于
description有没有把适用场景描述具体; - 太宽泛(「帮助处理代码」)会导致不该用时也触发;太窄又会该用时不触发;
- 写完后要专门用正反任务测试触发是否准确(具体做法见 写第一个 Skill 第四步)。
触发质量是 Skill 能不能「自己被用上」的前提,这里给你直接对照,同一个评审 Skill:
- 描述过宽:「帮助处理代码相关的事情」——几乎任何编程任务都可能误触发,模型会在不该评审的时候也启动它,打断正常流程。
- 描述过窄:「仅在用户逐字说出『执行 pr 检查流程 v2』时使用」——现实里没人会这样下指令,导致真正需要时一次都触发不了。
- 描述合适:「在提交、push、发 PR、或用户要求提交前检查时,对改动做结构化评审」——既给了能力,也给了几个真实的触发场景,边界清楚。
写描述时可以套用一个稳定句式:「在【什么场景/用户意图】时,做【什么事】」,并尽量列出用户真实会说的几种说法。还要避免一个常见误区——不要把详细步骤塞进描述。描述的职责是「判断要不要用」,不是「怎么做」,步骤属于正文。描述写得又长又细,反而会稀释触发信号,也白白增加每次匹配的成本。先让模型准确判断「该不该用」,进入之后再谈「怎么做」,两件事别混。
四、渐进式披露:为什么不把内容全塞进入口
这是 Skill 设计的核心机制,叫渐进式披露(Progressive Disclosure):模型一开始只加载简短的入口,只有在确实需要时,才去读对应的资源文件。
为什么这么设计?如果把所有步骤、示例、脚本说明都塞进 SKILL.md,它会变得很长,每次都占宝贵的上下文预算,而且重点被淹没。分层之后:入口常驻且精简,细节按需出现。下一篇 渐进式披露详解会专门展开。
可以把渐进式披露记成清晰的三层加载心智:第一层是元信息(名称 + 带触发条件的描述),用于「判断要不要用」,成本极低;第二层是主干指令,进入 Skill 后加载,用于「知道整体怎么做」;第三层是资源文件,只在具体子问题出现时读取,用于「拿到细节、模板或执行脚本」。越往后越具体、也越晚加载。
这三层的妙处在于,信息成本严格匹配使用深度:绝大多数任务停在第一层(只判断不调用),不为此付出内容成本;真正调用的才加载主干;只有少数复杂情况才深入资源。你可以用这个三层模型检查自己的 Skill——如果一个本该第三层的低频细节被你放进了第一层或第二层,它就会在每次调用里被白白加载。理解了「按深度付费」,你在安排信息位置时就有了明确依据:越是高频、通用的越靠前,越是低频、具体的越靠后。
五、资源文件放什么
| 资源 | 内容 | 何时读 |
|---|---|---|
scripts/ | 可执行脚本(检查、生成、转换) | 需要真正跑动作时 |
templates/ | 输出模板、代码骨架 | 需要套用格式时 |
references/ | 详细规则、背景、长示例 | 遇到具体子问题时 |
入口负责「告诉模型有什么、何时去取」,资源文件负责「具体内容」。这样一个 Skill 既能承载很丰富的知识,又不会把上下文压垮。
关于三类资源,再补充判断「该放哪」的经验:
- 什么时候用
scripts/而不是用文字步骤? 当动作需要精确、可重复、或纯靠模型生成容易出错时——比如固定的格式校验、批量转换、解析特定格式。把确定性逻辑写进脚本由模型调用,比让它每次凭说明重新做更可靠,也更一致。脚本适合「机械且要求准确」的部分。 - 什么时候用
templates/? 当产出需要固定结构——提交报告、文档骨架、代码样板。模板保证输出格式统一,模型只需填内容,不必每次重新组织格式。 - 什么时候用
references/? 当内容是低频的详细背景、长示例、规则细则——多数调用用不到,但在特定子问题上需要查阅。这是最典型的「按需加载」内容。
一个容易犯的结构错误,是把本该是脚本的确定性逻辑写成大段自然语言步骤,结果模型每次理解略有偏差、产出不稳定;反过来,也有人把本该阅读的判断指南硬写成脚本,丧失了应对不同上下文的灵活性。判断主线是:要的是「确定执行」还是「理解判断」——前者给脚本,后者给文档。模板则专门服务于「输出形态的统一」。
还有一个组织建议:资源文件路径要稳定、命名能自解释,并在入口里用「遇到 X 就读 Y」的方式明确指向。模型是按入口给的路径去取内容的,路径清晰、触发条件具体,它才能在正确时机读到正确文件,而不是找不到、或读了无关资源。
六、跟着一个真实需求,理解每个零件的作用
抽象讲结构容易飘,我们用一个具体 Skill 的诞生过程,把每个零件为何存在串起来。假设团队反复在「写周报」这件事上浪费时间:每次手动翻本周合并记录、归纳、套格式,还常常漏项。于是决定做一个 weekly-report Skill。
先想清楚触发场景,写进描述。 真实意图是:用户在周末或明确说「写周报 / 整理本周工作」时调用。描述据此写成「在用户要写周报、总结本周工作时,汇总本周已合并改动并生成结构化周报」,而不是泛泛的「帮助写作」。这一步定的是「何时被自动用上」。
再写每次都要走的主干。 周报流程稳定的核心步骤:确定时间范围 → 汇总该范围内已合并的改动 → 按项目或主题归类 → 提炼成果与风险 → 套用周报格式。这几步每次都需要,放进 SKILL.md 正文,保持精简。
把确定性动作下沉成脚本。 「汇总某时间范围内已合并改动」如果靠模型凭记忆列举,容易漏、也不稳定;写成一个脚本(调用版本控制、按时间过滤、输出清单),模型只需调用并拿结果。这里脚本保证了数据的准确与可重复。
把输出格式放进模板。 周报有固定栏目(本周成果 / 进展中 / 风险与下周计划),做成模板,模型只填内容,保证每次格式统一、不缺栏目。
把低频细则放进参考文档。 比如「跨多个仓库时怎么合并口径」「如何处理没有提交记录但实际做了的工作」这类并非每次遇到的细节,放进 references,只在对应情况出现时读取,不占常驻空间。
走一遍这个例子你会发现,结构里的每个零件都对应一个真实需要:描述负责触发、正文负责主干、脚本负责确定性、模板负责格式、参考文档负责低频细节。Skill 结构不是人为规定的繁琐规范,而是为了让「一类反复出现的工作」能被准确、省心地复用。 当你自己设计 Skill 时,也可以按这个顺序问:什么时候触发、主干是什么、哪里需要确定执行、输出要不要统一格式、有哪些低频细节——答案自然会落到对应的结构位置上。
最后提醒一点:第一次做不必追求每个零件齐备。可以从只有描述和主干的最小 Skill 开始用,等发现某一步老出错(需要脚本)、格式老不统一(需要模板)、或总被低频细节打断(需要参考文档)时,再逐个补上。让结构随真实使用反馈长出来,比一开始设计一个大而全的目录更实用,这也和前面所有知识资产的积累规律一致。
七、常见结构错误速查
把新手在 Skill 结构上的高频错误集中列出,对照避免:
- 入口写成一篇长文:步骤、示例、背景全堆进
SKILL.md,每次调用都占大量预算、重点还被淹没。应下沉到资源文件。 - 描述只写能力、不写触发场景:模型无法稳定判断何时该用,导致误触发或不触发。
- 资源路径没有在入口声明:模型不知道有哪些文件可读取,等于资源白放。
- 把硬约束只写进 Skill 而忘了作用范围:Skill 只在被调用时生效,真正每次都要守的规则应放进 rules,别混淆两者职责。
- 脚本与文档分工颠倒:该确定执行的写成散文、该灵活判断的写成死板脚本。
一个整体的自检方法:写完一个 Skill 后问三句——只读入口,我(或一个新人)能不能正确开始?任何常驻内容是否都是高频必需?低频细节是否都有明确的按需路径? 这三问能在使用前发现大多数结构缺陷。
八、常见问题
Q:SKILL.md 控制在多长合适? 没有统一字数,但原则是「短到只保留每次调用都需要的主干」。如果你发现自己在往里加「可能以后用得上」的内容,基本就该下沉。把入口当目录和启动说明,而不是全本手册。
Q:Skill 必须三个资源目录都齐全吗? 不必。很多小 Skill 只有一个 SKILL.md,或加一个脚本就够。资源按真实需要添加,为了结构「完整」而创建空目录没有意义。
Q:入口和 rules 都能写约定,会冲突吗? 要分工:rules 放每次任务都要守的全局/项目约束;Skill 的指令只在该 Skill 被调用时生效。若同一约定两边都写,维护时容易分叉,应只在一处定义、另一处引用。
Q:模型会不会不按入口写的步骤做? 有可能,Skill 指令本质仍是提供给模型的信息。对必须严格保证的关键动作,用脚本承载确定性、必要时配合钩子强制,比只靠文字步骤更可靠。
Q:一个 Skill 多大 / 多复杂算合适? 以「一类反复出现的工作」为单位,保持单一目的。如果你发现一个 Skill 里要处理好几件不太相干的事,往往该拆成多个。判断标准和任务拆解一致——它应围绕一个可清晰描述的用途,而不是塞成工具箱大杂烩。
Q:怎么确认资源文件真的会在需要时被读到? 在测试时故意构造需要该资源的场景,观察它是否顺着入口声明的路径去读取;读不到通常是路径写错或入口没声明。这个验证在写第一个 Skill 的迭代环节会具体练到。
总结
Skill = 一个精简的 SKILL.md 入口(名称、带触发条件的描述、核心指令、资源路径)+ 一组按需读取的脚本/模板/参考文档;靠描述决定何时触发、靠渐进式披露控制上下文,这就是它能装下大量专门知识却不臃肿的结构秘密。