如何配置一个子 Agent
系列入口:如何使用 Agent。前置:什么是 Subagent。
一、配置的本质:给「专职工人」一份岗位说明
配置子 Agent,本质上是在定义一个岗位:这个工人是干什么的、能力多强、能用哪些工具、按什么规矩做、能看到哪些信息。配得越聚焦,它在那块窄任务上越稳。下面拆五个关键配置项。
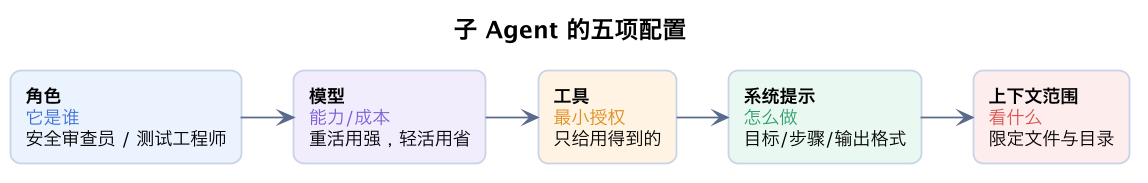
二、五项配置逐一说明
1. 角色(Role)
用一句话给它定位,比如「你是一名专注于安全的代码审查员」。角色框定了它思考问题的角度和语气,也便于你在多个子 Agent 间区分职责。角色要具体,别只写「你是一个助手」。
2. 模型(Model)
按子任务的难度和性价比选模型:
- 推理重、容易出错的活(复杂排障、架构调研):用强模型,质量优先;
- 机械、范围窄的活(格式转换、简单检索、批量改名):用更便宜/更快的模型即可,显著省钱。
子代理的一大优势正是可以「分级用模型」,而不是所有环节都按最高规格付费。
3. 工具(Tools)
遵循最小授权:只给完成该子任务必需的工具。一个只读的调研子 Agent,就不需要给它写文件或执行危险命令的权限;这既更安全(缩小误操作面),也让它更专注。需要跨外部系统时,再按需开放 MCP 连接器。
4. 系统提示(System Prompt)
写清三件事:目标(要交回什么)、步骤或检查维度(怎么做)、输出格式(结论长什么样)。例如:
你是代码库调研员。任务:找出所有调用 deprecated API 的位置。
步骤:在 src/ 下搜索该 API,逐个确认是否为真实调用。
输出:一个列表,每项含文件路径、行号、调用上下文;不要修改任何文件。
明确的输出格式让主 Agent 能稳定地消费它交回的结果。
5. 上下文范围(Context Scope)
控制它能接触哪些信息:限定工作目录、指定可读文件、是否继承主对话历史。通常子 Agent 默认上下文隔离,只拿到主 Agent 显式传给它的那部分信息,这正是它能保护主窗口的原因。范围给太大,隔离的意义就没了;给太小,它可能因缺信息而做偏。
三、配置常见错误对照
| 症状 | 可能的配置问题 |
|---|---|
| 它改了不该改的东西 | 工具授权过大 / 范围没限定 |
| 简单任务成本却很高 | 所有子任务都用了最强模型 |
| 交回结果没法用 | 系统提示没规定输出格式 |
| 它做偏、乱猜 | 角色不清 / 上下文给得不足 |
| 主窗口还是被塞满 | 上下文没真正隔离 |
四、一个完整配置范例
把五项串起来,一个「只读安全调研员」的配置大致是这样:
角色:你是一名专注安全的代码审查员,只做只读调研。
模型:用速度快、成本低的模型(任务是模式化检索)。
工具:只授予只读搜索与读文件,禁止写文件和执行命令。
系统提示:
  目标:在指定目录找出常见安全风险(明文密钥、拼接 SQL、危险反序列化)。
  步骤:逐类检索 → 打开命中处确认是否为真实风险 → 排除误报。
  输出:列表,每项含文件路径、行号、风险类型、一句说明;不改任何文件。
上下文:仅限定目录,不继承主对话历史。
注意这里的搭配逻辑:因为任务模式化,所以用便宜模型;因为只需调研,所以工具收紧到只读;因为要保护主窗口,所以上下文隔离。五项配置不是各写各的,而是围绕同一个目的互相配合。
五、配置常见误区
- 角色写得太泛:「你是一个助手」等于没框定,它找不到稳定的思考角度。
- 所有子任务一律上最强模型:简单活也按顶配付费,成本被悄悄抬高。
- 图省事给全套工具:扩大了误操作面,也让它更容易分心、跑偏。
- 系统提示只说目标,不说步骤和格式:交回结果参差,主 Agent 难以消费。
- 范围要么过大要么过小:过大失去隔离意义,过小则因缺信息而瞎猜。
一个很实用的自检:配置写完后,假设你完全不了解背景,只看这份配置,能否判断「它该做什么、不该碰什么、最后交回长什么样」?如果三者都清楚,配置基本合格。
六、常见问题
Q:系统提示写多详细合适? 以能让它稳定完成窄任务为准:目标、关键步骤/判据、输出格式这三块必须有;过度啰嗦反而稀释重点。细节可在使用中按问题迭代补充。
Q:怎么判断该给它强模型还是便宜模型? 看任务是否需要复杂推理。模式化检索、格式转换用便宜模型;复杂排障、架构判断用强模型。拿不准时,可先用便宜模型试,质量不够再升级。
Q:子 Agent 一定要完全隔离上下文吗? 默认隔离能保护主窗口,但如果它确实需要某些背景,应由主 Agent 显式、精简地传入,而不是放开让它继承全部历史。
六点五、把五项配置看成一个相互约束的整体
很多人配置子 Agent 时,把五项当成五道互不相关的填空题,想到什么写什么,结果配置之间彼此矛盾。这里换个角度,帮你把它们看成一个围绕「窄任务」相互约束的整体。
角色决定了它用什么视角看问题,这个视角又暗示了需要多强的能力——一个需要权衡复杂逻辑的架构调研员,角色本身就要求强模型;而一个只做模式匹配的检索员,角色决定了便宜模型就够用。同样,角色和任务也约束了工具范围:只读调研员根本不该有写权限,给了反而制造风险。系统提示则是把前三项落地的地方——它要用文字把角色的视角、能力的边界、工具的用途,具体翻译成可执行的目标、步骤和输出格式。最后上下文范围收口,确保它只看到完成这件窄任务所需的信息,既不缺也不溢。
这样理解后,你会发现配置不是凑齐五项,而是让五项都指向同一个明确目的。如果某次配置里出现矛盾——比如一个「只读调研员」却被授予了写文件权限,或一个「简单格式转换」却配了最贵的模型——那就是五项没有对齐的信号。写完后通读一遍,专门检查这种互相打架的地方,比逐项检查更能发现深层问题。
六点六、团队场景下配置如何复用
如果只是你一个人用,配置写完、试好就算完成;但在团队里,一个好用的子 Agent 配置往往值得让更多人复用,这时候有几点值得注意。
首先,配置要随仓库走、纳入版本控制,而不是只存在于某个人的本地环境里。这样所有人调用同一个角色时,行为是一致的,也能像代码一样对配置变更做评审和追溯。其次,配置里的「项目特定内容」要写清楚——比如调研范围、输出路径、团队真正关心的判据,这些是把一个通用角色变成「你们团队的角色」的关键,别让复用者还要自己猜。再者,当配置发生变化(比如收紧了某个工具权限、更换了默认模型),应该让相关同事知道,避免他们基于旧的行为预期来使用。
团队复用还有一个隐性收益:当一个角色配置经过多人在真实任务中打磨后,它会比任何个人临时写的配置都更稳健,而这份稳健会沉淀在仓库里持续生效。这和 Skill、规则文件的共享逻辑是一致的——个人的一次配置是技巧,团队共享、持续迭代的配置才是资产。理解了这层,你在做配置时就会自然考虑「别人能不能直接拿去用」,而不只是「我这次能不能跑通」。
六点七、用「岗位说明书」的标准审视配置
配置一个子 Agent,最贴切的类比是为一个真实岗位写说明书。如果你真要招一个人来做这件事,一份合格的岗位说明会回答几个根本问题:这个人是谁、负责什么、需要多强的能力、能动用哪些资源、按什么标准考核。用这套现实标准去审视你的配置,缺漏会一目了然。
对照来看,角色就是岗位名称和定位——「安全审查员」和「测试工程师」显然是不同的岗,思考问题的角度完全不同;模型对应能力级别——你不会让一个资深架构问题交给实习生,也不会让一个博士去做纯体力的搬运;工具对应可支配的资源——一个只做调研的岗位不该有动用资金、改动核心系统的权限;系统提示就是岗位职责和考核标准——目标、流程、交付物说不清楚,这个人就只能凭感觉做;上下文范围则对应信息知情权——他该看到哪些资料、哪些与他无关,都要界定。
这个类比还有一个深层启发:现实中,岗位说明越聚焦,这个人越容易把事情做好;如果一份说明把开发、测试、运维、客服全写进一个岗位,结果往往是样样沾、样样松。子 Agent 配置同理,窄而清晰,远胜宽而含糊。 当你拿不准配置写得好不好时,就把自己代入招聘者:只看这份说明,我招来的人清不清楚该干什么、不该碰什么、最后交什么?能清楚回答,配置就过关。
六点八、配置的迭代节奏:先跑通,再优化
很多新手在配置阶段就想一次写到完美,反复斟酌措辞,迟迟不敢真正派活,这其实搞错了重点。配置的正确性,很大程度上不是「想」出来的,而是「用」出来的,合理的节奏应当是先跑通最小版本,再根据真实表现优化。
第一步,先给出一个包含五项要素、但不必精雕细琢的最小配置,用一个小而真实的子任务试派。第二步,观察它的实际表现:有没有按角色行事、有没有越权、交回格式对不对、是否因信息不足而跑偏。第三步,把发现的具体问题对应回配置——越权就收紧工具、做偏就补上下文、结果难用就明确格式。第四步,再次试派验证改动。通常经过这样一两轮,配置就会明显稳定下来。
这种迭代节奏的好处,是让你的每次修改都有真实反馈作依据,而不是凭空猜测。它也降低了起步的心理压力——你不必一开始就写出完美配置,只要敢先用一个「够用」的版本跑起来。把配置当成需要在使用中持续打磨的活文件,而不是一次成型的成品,你反而会更快得到一个真正好用的子 Agent,也会在这个过程中积累出对「什么配置导致什么表现」的直觉。
六点九、模型分级背后的成本直觉
模型选择是五项配置里最直接影响账单的一项,这里专门展开,帮你建立一种稳定的成本直觉,而不是每次凭感觉决定用哪个模型。
先破除一个常见误解:用强模型不等于更负责,用便宜模型也不等于在质量上偷懒。正确的标准只有一个——让模型能力与任务难度匹配。 一个只需要识别固定模式、转换格式、按模板汇总的子任务,其难点并不在推理,而在执行的稳定与覆盖;这种活即便交给最强模型,多余的推理能力也用不上,你为用不到的智能付了溢价。反之,一个需要在大量代码里权衡因果、推断隐藏关联的复杂调研,模型能力一旦不够,它会漏掉真正关键的联系,省下的模型费用换来一个错误结论,代价远高于差价。
成熟的做法是把任务先在心里分档:哪些是「照着规则跑就行」的机械活,哪些是「必须想明白」的推理活,分别配给相应档次的模型;拿不准的,先用便宜模型试,从它交回结果的质量判断是否需要升级。当你习惯按难度而非按「越贵越保险」来选模型,成本会在不牺牲关键质量的前提下显著下降。
六点十、上下文范围:隔离与充足之间的平衡
上下文范围是五项里最微妙的一项,因为它要在两个看似矛盾的目标之间找平衡:一方面要隔离,保护主窗口、让子 Agent 专注;另一方面要充足,确保它拿到完成任务所需的全部信息。配不好,就会在「给太多」和「给太少」之间翻车。
给太多的问题,是隔离失去意义。如果让子 Agent 继承主对话的全部历史、或放开一个过大的目录,它不仅可能把无关信息带进自己的判断、造成分心,也更容易在无意中触碰不该改的东西。这相当于为了省心,放弃了子代理最核心的收益。给太少的问题则相反——它缺少必要背景,却被要求交结果,于是只能靠猜,产出偏离项目实际,而它可能还表现得相当自信。
找到平衡点的关键,是从任务倒推信息:完成这件明确的子任务,它最低限度必须知道哪些背景、看哪些文件、遵守哪些已确认的决定?把这些显式、精简地给到,其余一律不给。这个「按需供给」的思路和整个上下文工程完全一致,只是作用对象换成了子 Agent。把范围配到「信息够它做对、又不额外占它和主窗口的注意力」,这个专职工人才会既稳又省。
六点十一、工具授权的危险梯度
工具配置虽然只占五项之一,却直接关系安全,值得用一个「危险梯度」的视角把它讲透。这样你在授权时,就不会简单地全开或全关,而是按工具本身的危险级别分级放权。
可以把工具按危险程度大致排成四档。最底层是只读类——搜索代码、读文件、查文档,它们不改变任何东西,基本无害,可以放心交给子 Agent。往上是写入类——新建和修改文件,会留下改动,但通常能靠版本控制回滚,风险可控但应限定范围。再往上是执行类——跑 shell 命令、安装依赖、启动服务,它们能触达系统,一条命令的细微差别可能造成完全不同的后果,必须谨慎。最顶层是外联类——调用外部 API、访问数据库、触发部署,这类动作一旦发出往往无法撤回,可能真的写入生产数据或触发一次对外发布。
顺着这个梯度,授权策略就清晰了:只读工具可默认放行,写入工具靠范围和后续 diff 把关,执行与外联工具则应按需授予、甚至要求逐次确认,而不是一股脑全给。一个只做调研的子 Agent,停留在只读档就完全够用,根本不必让它拿到上面几档的能力。让权限随危险级别递增而收紧,既保证它能完成任务,又把误操作可能造成的最大损失降到最低——这正是最小授权原则在多 Agent 场景的具体落地。
七、配置完照样要验证
配好一个子 Agent 后,用一个小的真实子任务试派一次:看它是否按角色行事、有没有越权、交回的格式对不对,再据此微调。这和 Skill 的测试迭代是一个道理——配置不是写完即对,验证过才敢在真实编排里依赖它。下一篇就讲把多个这样配好的子 Agent 组织起来的 Orchestrator-Worker 模式。
总结
配子 Agent 记住五点:角色给它明确身份、模型按难度分级、工具最小授权、系统提示写清目标步骤和输出格式、上下文严格隔离限定——配得越聚焦,这个专职工人就越稳、越省、越安全。