子代理编排:主代理 fork 独立上下文的执行体与串并行实测
context 压缩机制 解决的是「一个窗口装不下」的问题,但它有一条绕不开的物理边界:压缩只能减少已经进入窗口的内容,不能减少任务本身需要的工作面。当用户同时要求改两个互不相关的模块、各自都要读文件、改代码、跑验证时,把所有中间过程塞进同一个上下文,即使不爆窗口,推理质量也会被无关细节稀释。子代理编排是另一条思路:主代理不再亲自做全部工作,而是 fork 出拥有独立上下文的子代理,自己只负责派活、回收结果和汇总。
本篇是原理系列的第四篇,在同一个纯标准库工程 mini-agent 上完成 M4:新增子代理编排模块,让主代理通过一次 fork_subagents 工具调用派出两个子代理,各自在独立消息历史里改一个文件,再把结果聚合成一条 tool 消息回传。所有实验不依赖外部 API,串并行耗时用 time.perf_counter 各测五轮取中位,数字可以逐次复现。
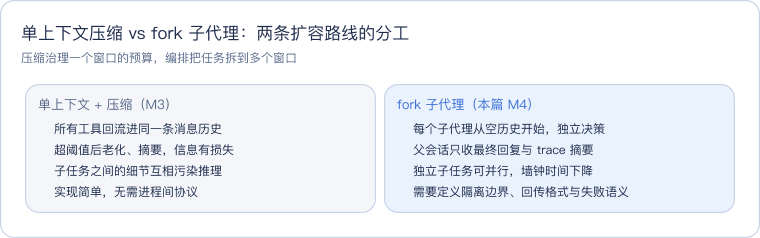
这张对比卡对应本篇的核心判断:压缩与编排不是替代关系,而是两个层级的手段。压缩发生在一个上下文内部,编排发生在多个上下文之间;子代理跑完回传的摘要进入父会话之后,它就是一条普通 tool 消息,照样要接受父侧的窗口治理。
本文要回答的问题
- 既然有上下文压缩,为什么还需要子代理?单上下文的天花板到底在哪?
- fork 出来的子代理与父会话之间什么可见、什么不可见,共享输入如何传递?
- 子代理的结果通过什么格式回传,为什么中间消息不能进入父历史?
- 并行编排的加速比从哪里来,在教学工程里怎样做到真实可测量?
- 子代理失败时主 loop 为什么不会死,提示词缓存在这套机制里处于什么位置?
一、单上下文的三条天花板
先把「不做编排」的代价讲清楚。一个主代理亲自处理两个独立模块的改动,消息历史会按这样的节奏膨胀:读 alpha 文件、读 beta 文件、改 alpha、改 beta、跑测试、再读回确认——六次工具调用的回流全部堆在同一条历史里,而其中至少一半内容对当前决策是无关噪音。这带来三条压缩也救不了的天花板。
第一条是注意力稀释,而不是窗口容量。现代模型的上下文窗口足够装下这些内容,但同窗口内的无关工具回流会参与每一轮推理,模型需要在 beta 的超时配置里分心记住 alpha 的常量值。上下文压缩能删掉旧细节,却无法区分「这条回流对另一个子任务有用、对当前决策无用」这种任务维度的相关性。
第二条是故障爆炸半径。单上下文里一次工具异常经过结构化回流后仍留在历史中,后续每一轮模型都看得到这次失败,可能反复纠结一个已经绕过的问题。独立上下文天然把故障关在子代理内部:子代理失败,父会话只收到一条错误摘要,主 loop 可以选择重试或带着失败信息收尾。
第三条是串行 wall-clock。单上下文只有一条消息历史,模型调用严格一轮接一轮,两个独立子任务的读取、修改、验证无法重叠。fork 子代理之后,两个独立上下文可以并发推进,这是本篇计时实验要量化的部分。
| 维度 | 单上下文亲自做 | fork 子代理 |
|---|---|---|
| 消息历史 | 一条,所有回流共享 | 父一条 + 每个子代理各一条 |
| 无关细节 | 全程参与每轮推理 | 关在子上下文内,父侧不可见 |
| 失败影响面 | 污染整条历史 | 结构化错误摘要,爆炸半径收敛 |
| 时间结构 | 严格串行 | 独立子任务可并行 |
| 工程代价 | 无额外协议 | 隔离、回传、聚合、并发四件事要定义 |
真实产品里的多代理系统——Claude Code 的子代理、各类编排框架里的 worker agent——共性都是「独立上下文 + 结果回传」,区别只在派活粒度与通信协议。
二、fork 的机制:什么可见,什么不可见
「fork」这个词借自进程模型,但子代理 fork 比操作系统 fork 克制得多:它不复制父会话的内存(消息历史),只继承一份任务描述和共享只读输入。M4 在 SubagentRunner._build_messages 里把这条边界写成硬逻辑——子代理的消息列表永远从两条消息重新开始:一条 system 消息定义子代理身份,一条 user 消息装载任务文本、共享输入和约束,父会话历史里的任何正文都不会出现在其中。
共享只读输入是父子之间唯一的常规数据通道。M4 演示里它是三项元数据:编码规范、任务编号、回归要求,由父侧渲染成 user 消息里的键值列表。「只读」不是口号:子代理拿到的是输入快照,它在自己上下文里怎么推理都改不了父侧这份字典;测试里专门有一条断言,把带私有标记的父历史与子代理消息全文比对,确认标记零泄露。
回传方向同样收窄。子代理跑完后,回到父会话的不是它的完整历史,而是一个固定结构的结果对象:名字、成功与否、最终回复、轮数、消息条数、耗时,失败时附结构化错误。编排器把两个结果对象聚合成一条 tool 消息,挂在主代理那轮 fork_subagents 调用的 tool_call_id 上,角色配对契约与 function calling 工具系统 里的普通工具完全一致。子代理内部的 read_file、edit_file 配对消息只存在它自己的内存 trace 里,父级 JSONL 一行都不收。
读这张拓扑抓住三条线。蓝色是控制面:主代理 loop 只认识一次普通工具调用,完全不知道工具内部跑了两个完整 agent;紫色是编排面,负责把任务分发到线程并按提交顺序回收;绿色是数据面,两个子代理共享同一个工作区路径,但各自只改被指派的文件,不存在写冲突。图里最容易被忽略的是回传线的宽度——两个子代理各自产生 7 条消息,回到父会话时只浓缩成一条 tool 消息,这就是上下文隔离在数据量上的直接体现。
三、工程设计:不改动 loop 的挂接方式
M4 对 M1 主循环的侵入是零。run_loop 一行未改,秘密在 ForkingToolRegistry:它继承 M2 的工具注册表,只覆写 dispatch 一个方法——遇到 fork_subagents 就走编排器,其他六个工具原样上交父类。对主循环来说,fork 子代理与读文件没有结构区别,都是「模型发 tool_call、注册表回 ToolResult」。
这个选择把教学焦点逼到了编排模块内部。SubagentRunner 负责单个子代理的完整生命周期:构造独立消息、新建脚本化模型与工具注册表、用内存版 tracer 记录全过程、time.perf_counter 计时,并用 try/except 兜住所有异常——子代理抛错时返回 ok=False 的结果对象而不是炸穿线程。SubagentOrchestrator 提供两种编排:串行就是顺序调两个 runner;并行用 ThreadPoolExecutor 提交两个任务,再按提交顺序收集 future,结果顺序与任务列表严格一致,和 M2 只读批次并发「按请求序回流」的约定同构。
并发安全靠两条隔离保证。其一是状态隔离:每个子代理有独立的模型实例、消息列表、注册表和内存 tracer,线程之间没有共享可变对象;其二是 trace 隔离:子代理不直接写父级 JSONL 文件,避免多线程写同一个句柄造成行交错,父级 tracer 只接收 subagent_fork、subagent_return 两个生命周期事件,且所有写入过同一把锁。
时序上,一次并行 fork 的消息流动如下。
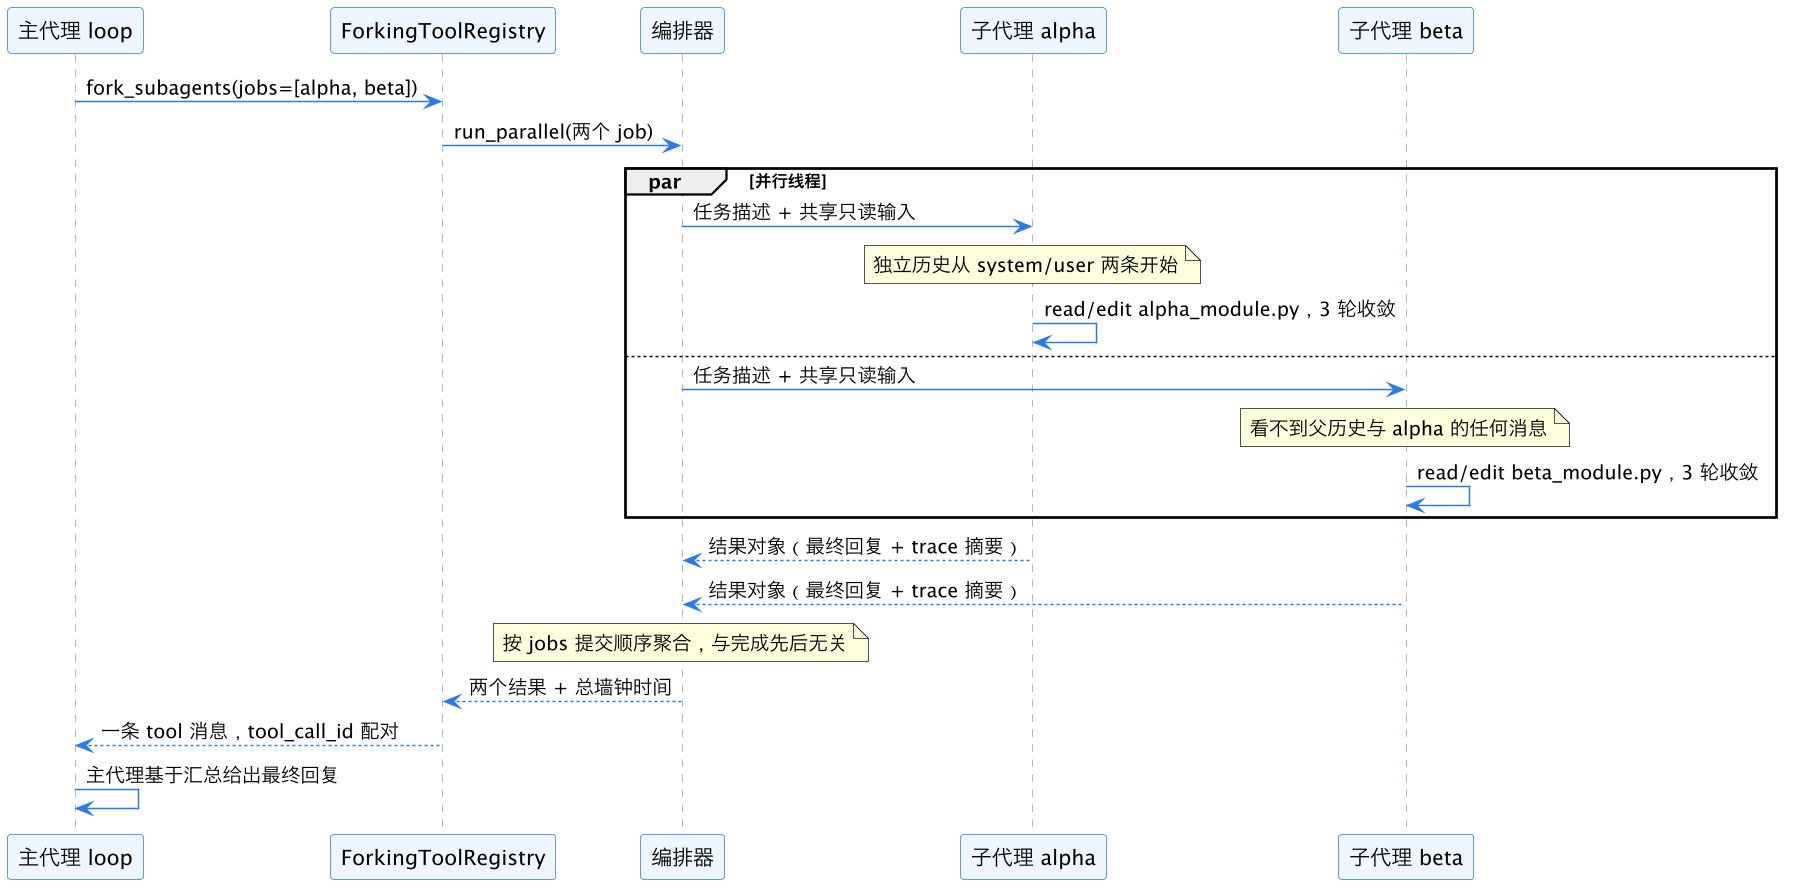
时序图里有两个细节值得停下来看。第一,两个子代理的回传顺序与线程实际完成顺序无关——实测 trace 里 beta 常常先结束,但聚合结果始终 alpha 在前,因为 future 是按提交顺序收的;确定性的回流顺序让脚本化实验可以逐字节对拍。第二,主代理在整个过程中只有两次模型调用:一次发出 fork,一次读取聚合结果后汇总,子代理内部各自的三轮模型调用对主循环的消息计数毫无影响。
四、串并行实测:1.99x 加速比是怎么测出来的
脚本化模型本身没有推理耗时,直接计时只会得到线程调度的噪声。M4 给 ScriptedModel 增加了一个默认关闭的 delay 参数:每次 complete 调用前固定等待给定秒数,用来模拟真实模型的推理往返。演示负载里两个子代理各有三轮模型调用、每轮名义延迟 0.08 秒,按名义值折算单个子代理的延迟分量是 0.24 秒,串行名义下界约 0.48 秒,并行名义下界约 0.24 秒——加速比的理论上限是 2.00x。
需要先交代一个平台口径:本机 time.sleep(0.08) 并不会在 0.08 秒准时返回,多轮实测多落在 0.15 到 0.23 秒之间(一组六次采样的中位为 0.222 秒),约为名义值的 2 到 3 倍,这是系统对睡眠线程做定时器合并(timer coalescing)的结果;作为对照,忙等同样的 0.08 秒精确返回 0.0800 秒,说明偏差来自睡眠唤醒粒度而非计时函数。读者可以用一行命令自行核对:
python3 -c "import time; [print(round((lambda t0: (time.sleep(0.08), time.perf_counter()-t0)[1])(time.perf_counter()),4)) for _ in range(6)]"所以下文的绝对墙钟时间显著高于名义延迟下界,但串行与并行两种编排支付的是同一份定时器超时,比值不受影响——这也是本篇只把 2.00x 当作结构性上限、不把 0.24 秒当作可观测目标的原因。
实测没有直接拿理论值说事。驱动脚本把串行与并行各跑五轮,每轮都重置工作区,用 time.perf_counter 记录墙钟时间再取中位。
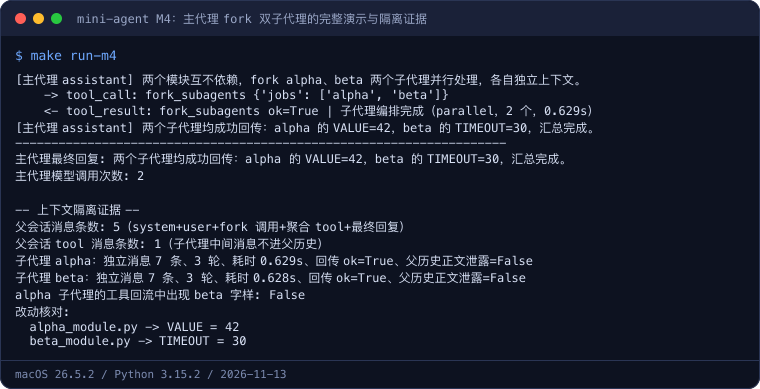
这段终端记录的上半段是主代理视角的完整过程:一次 fork_subagents 调用,回收一条 ok=True 的聚合 tool 消息,然后主代理两次模型调用就收敛。下半段的隔离证据是本篇最关键的断言:父会话总共只有 5 条消息、其中 tool 消息仅 1 条;两个子代理各自持有 7 条独立消息,父历史正文泄露检查均为 False;alpha 的工具回流里检索不到任何 beta 字样;工作区里两个文件的改动各自命中。
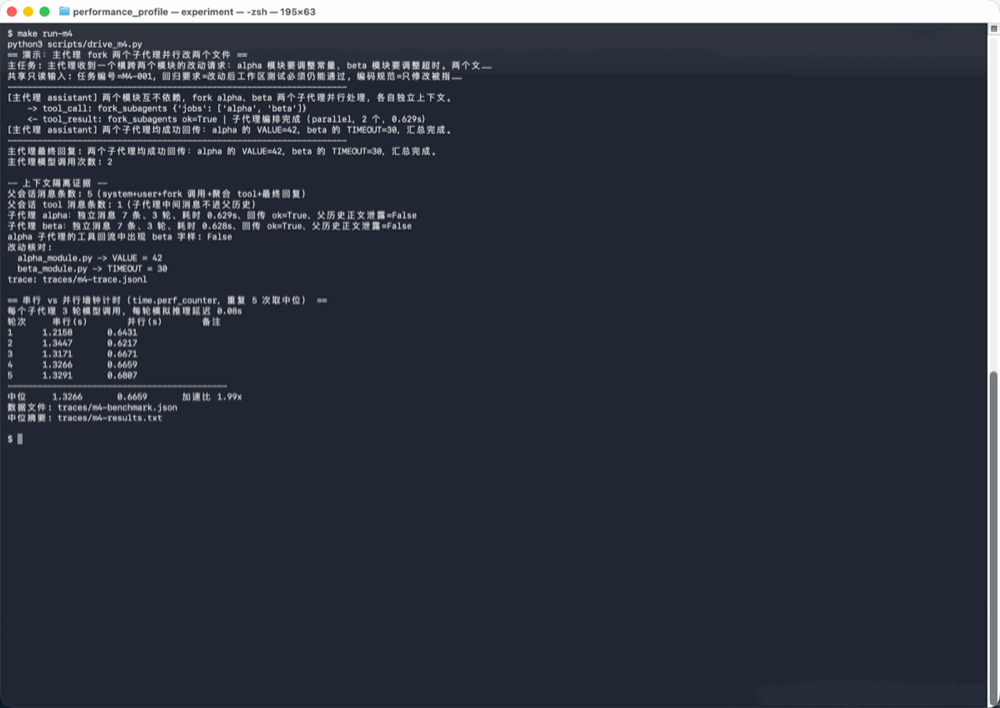
上图中可以对照着读三层信息:控制面只有一次工具调用,隔离面的消息条数呈现「父 5、子各 7」的断层,数据面两个文件的第二行分别落为 VALUE = 42 与 TIMEOUT = 30。父会话那唯一一条 tool 消息的正文,就是编排器聚合出来的多行摘要。
计时对照表单独再看一段。
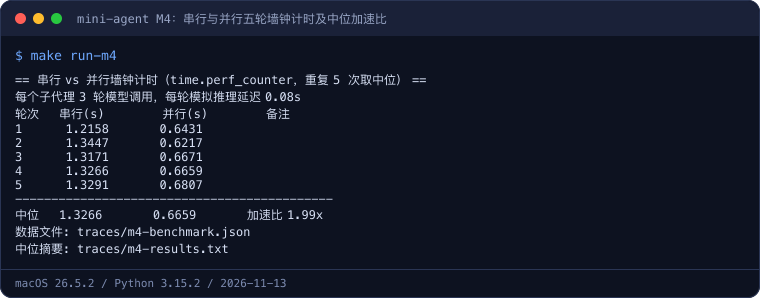
五轮数据里,串行单次落在 1.22 到 1.34 秒之间,并行落在 0.62 到 0.68 秒之间;中位数分别是 1.3266 秒与 0.6659 秒,实测加速比 1.99x,与 2.00x 的理论上限只差线程调度与注册表构造的固定开销。把五轮数据画成图,离散程度和中位差距更直观。
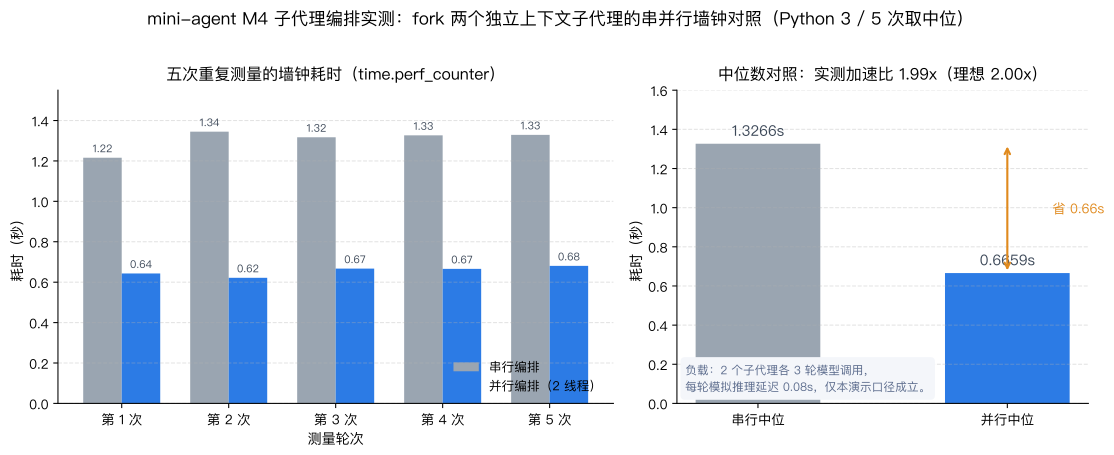
左面板五个轮次里灰柱(串行)始终接近蓝柱(并行)的两倍高度,没有任何一轮出现倒挂,说明差异来自编排结构而非偶然调度;右面板的中位数对照标出了并行方案省下的 0.66 秒,并注明这个数字只对本演示负载成立。把它外推到真实系统前必须补上三个限定:真实模型调用是 IO 密集型,线程在等待响应时释放 GIL,并发结构成立,但总吞吐受账号级速率限制约束;子任务必须真正独立,写同一文件会把并行退化为冲突;任务长度不均时,并行墙钟由最慢的子代理决定,加速比低于子代理数量。
五、失败回传、隔离断言与提示词缓存的边界
失败路径在测试里被固定为硬契约。一个脚本为空的子代理会在首轮模型调用时抛出「脚本回复已用尽」,runner 的 try/except 把它兜成 subagent_failed 结构化错误,错误体带异常类型、消息和子代理名字;与它并行的正常子代理不受影响,仍然成功回传。主代理通过注册表拿到的是 ok=False 的 ToolResult——与 M2 工具错误同一个 {code, message, tool} 形状,主 loop 不需要为子代理失败学习任何新语法。未知任务名则在参数校验阶段就以 unknown_subagent 拦下,根本不会创建线程。
M4 新增 8 个 headless 用例,连同 M1 至 M3 的 28 个共 36 个,全部在标准库下通过。新增用例覆盖五个层面:父子双向隔离(父历史不泄露、子中间消息不进父历史)、回传格式与轮数字段、五轮计时下并行中位显著快于串行且不短于单子代理耗时、失败与未知任务的结构化错误、父级 trace 只含 fork/return 生命周期事件。
最后划清教学模型的两条能力边界,避免把演示数字误读成产品承诺。
第一是提示词缓存(prompt caching)。真实 API 里,多个子代理请求共享同一段 system 前缀时,服务端可以复用前缀缓存,降低重复前缀的计费与首 token 延迟;这是子代理编排经济性的重要组成部分。但 mini-agent 的模型是脚本化适配器,根本不发起网络请求,不存在缓存命中这回事,因此本篇只讲机制语义,不提供任何缓存命中率或费用节省百分比——这类数字必须在真实 API 上测量,编不出来也不该编。
第二是加速比的适用面。1.99x 对应「两个等长、独立、延迟模拟型子任务」这一精确负载;子代理数量增加、任务长度不均、存在共享文件或真实速率限制时,实际收益要重新测量。工程上可信的结论只有结构层面的一条:独立上下文的子任务可以并发,而单上下文内的串行轮次不能。
实验环境
- 机器/系统:MacBook Pro(6 核 Intel Core i7-9750H,16 GB 内存)/ macOS 26.5.2(Build 25F84)
- 工具版本:Python 3.15.2(仅标准库,无第三方依赖)
- 日期:2026-11-13
- 完整命令:
cd demos/mini-agent
python3 -m unittest discover -s tests   # M1+M2+M3+M4 共 36 个 headless 用例
make run-m4                             # fork 演示 + 串并行各五轮计时
实验参数:两个子代理各 3 轮模型调用,每轮模拟推理延迟 0.08 秒;串行与并行各重复 5 次取中位,计时口径为 time.perf_counter 墙钟时间;工作区含 alpha_module.py 与 beta_module.py 两个独立文件,任务脚本为 scripts/m4_task.json;原始计时数据落 traces/m4-benchmark.json,中位摘要落 traces/m4-results.txt,完整 trace 落 traces/m4-trace.jsonl。
代码获取
mini-agent M4 的子代理编排模块、驱动脚本、任务脚本与全部测试已同步到公开仓库:
- 仓库地址:https://github.com/derekzhuo/geek-doc.cn
- 目录:mini-agent/
- 复现方式:进入
mini-agent/,执行make run-m4查看本篇完整 fork 演示与串并行计时对照;make test跑 36 个回归用例;make run、make run-m2与make run-m3仍保留前三个里程碑的演示。修改scripts/m4_task.json的delay或子代理回复序列,可观察不同负载下的计时变化。
这一篇在知识体系里的位置
本篇承接 Agent Loop 解剖 的消息生命周期,把「一条历史走到底」扩展为「主历史加若干独立子历史」的树形结构;子代理内部运行的仍是同一个 Agent Loop,回传消息遵守 function calling 工具系统 的角色配对,回到父会话后继续接受 context 压缩机制 的窗口治理。宏观定位见 coding agent 全景。提示词缓存与系统提示设计的关系属于 提示工程指南 的话题;当子代理数量扩张到需要跨进程、跨机器供给工具时,工具发现与授权边界就落到 MCP 协议 要解决的问题上。
总结
子代理编排的本质是用上下文隔离换推理质量与并发:主代理 fork 出的执行体不继承父历史,只接收任务描述与共享只读输入,在独立消息历史里完成自己的工具循环,再把最终回复、trace 摘要与耗时聚合成一条 tool 消息回传,失败则以结构化错误收敛爆炸半径。mini-agent M4 在不改主循环的前提下用注册表挂接实现了这套机制,实测两个等长独立子任务并行中位耗时 0.6659 秒、对串行 1.3266 秒取得 1.99x 加速比,36 个 headless 用例与父子双向隔离断言证明:父会话始终只看到汇总,子代理的中间过程永远留在它自己的上下文里。