context 压缩机制:上下文窗口告急时 harness 的六条压缩路径与两种实现
Agent Loop 解剖 讲过一个容易被忽略的事实:模型本身是无状态的,它每一轮看到的「记忆」就是 harness 递进去的完整消息列表。function calling 工具系统 又让这份列表涨得飞快——一次 read_file 就能回流上万字符,十几轮工具调用之后,消息历史的体积会远超模型的上下文窗口。窗口不是抽象概念,它是一个有硬上限的预算:超了,API 直接报错,loop 当场死亡。
context 压缩机制就是 harness 在预算耗尽前做的自救。本篇是原理系列的第三篇,在同一个纯标准库工程 mini-agent 上完成 M3:新增压缩模块,真实实现「工具结果老化」与「滚动摘要」两种策略,再用驱动脚本灌一条 13 次工具调用的长会话,把压缩前后的 token 曲线逐轮测出来。所有实验不依赖外部 API,同一条会话跑多少次,数字都一致。
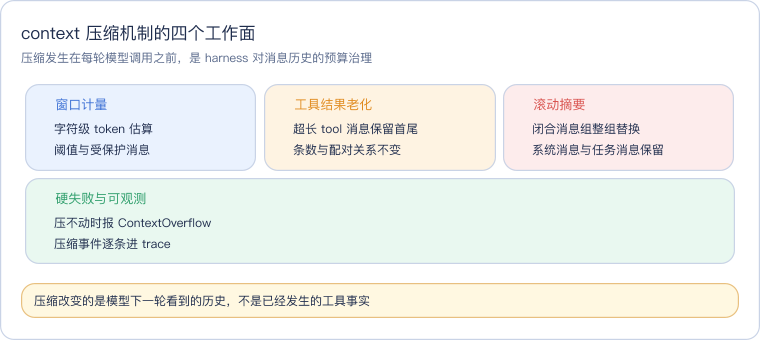
这张概念卡对应 M3 的四个模块。读它抓住一条主线:计量是触发条件,老化和摘要是两条力度不同的压缩路径,硬失败与 trace 是兜底和审计。压缩永远发生在模型调用之前,模型对「自己的记忆被剪过」这件事没有感知,它只能看到剪完之后的文本。
本文要回答的问题
- 上下文窗口为什么会被撑爆,工具结果在其中占了多大比重?
- 真实 coding agent 的 harness 常用哪些压缩路径,各自牺牲了什么信息?
- 工具结果老化和滚动摘要的触发条件、保护边界与信息损失有什么不同?
- 没有外部模型 API 时,怎样把摘要策略做成可复现的确定性实验?
- mini-agent M3 用什么证据证明压缩既守住了窗口预算,又没有让长会话中途死掉?
一、分析:窗口为什么会满,以及六条压缩路径
先看一笔具体的账。M3 实验的工作区里有一个 200 行的笔记文件 long_notes.txt,体积 16400 字符。按本篇统一的字符级估算口径(CJK 字符每个约 1 token,其余字符每 4 个折 1 token,每条消息另计 4 token 结构开销),一次完整读取的回流就超过 4000 token;而实验把窗口阈值故意压到 1200 token,意味着第一轮工具调用结束,预算就已经穿底。真实产品的窗口固然大得多(几十万到上百万 token),但命令输出、构建日志、大文件读取的体积同样水涨船高,比例关系并没有变:工具结果是消息历史里最大的膨胀源,纯对话文本反而不是主要矛盾。
不做任何压缩会发生什么?消息列表原样累积,直到某一轮请求触发上下文长度报错,loop 抛异常终止,任务带着全部已完成的工作一起失败。因此任何严肃的 harness 都必须在窗口耗尽前介入。把业界常见做法按「对原始消息做了什么」归类,可以分成六条路径。
| 压缩路径 | 处理方式 | 信息损失 | 实现成本 | 典型场景 |
|---|---|---|---|---|
| 滑动窗口截断 | 直接丢弃最旧的若干条消息 | 最高,旧事实无痕消失 | 最低 | 聊天机器人、短任务 |
| 工具结果老化 | 超长 tool 消息保留首尾与结构头 | 中,中段细节丢失、轮廓保留 | 低 | 命令输出、大文件回流 |
| 滚动摘要 | 把旧消息组压成一条摘要,后续持续滚动 | 中,细节换概括 | 中,需一次摘要生成 | 长周期 coding 任务 |
| 分段摘要 | 先分段各自摘要,再合并成层级摘要 | 中低,map-reduce 保留更多要点 | 高,多次生成与拼接 | 超长文档、会议纪要 |
| 外置存储与按需召回 | 旧消息落盘,需要时按相关性检索取回 | 低,但依赖检索质量 | 高,带向量库与索引 | 跨天任务、长期记忆 |
| 输入侧预算治理 | 精简 system prompt、裁剪工具声明、上下文编辑 | 低,针对的是固定开销 | 中 | 工具数量庞大的 agent |
六条路径不是互斥的,成熟产品通常组合使用。Claude Code 在窗口接近上限时会触发自动压缩,把早期对话折成一段摘要后继续任务,属于第三类;多数 harness 对单条命令输出默认就有长度截断,属于第二类;提示词缓存(prompt caching)虽然不删除任何内容,但通过复用固定前缀降低计费与延迟,和第六类的预算治理目标一致。选型的本质是在信息保真度、实现成本、触发时机之间取舍,不存在零损失的压缩——这也是为什么压缩事件必须留痕:事后要能回答「模型当时为什么不知道这件事」。
M3 选择落地第二条和第三条。理由很直接:老化处理的是最大膨胀源(工具结果),实现简单且不改变消息配对,适合作为第一道防线;摘要处理的是老化之后仍然超标的整体历史,代表另一大类思路。两条路径一「截」一「概括」,合起来能覆盖真实 harness 最主流的自救动作;其余四条路径在文末的知识体系位置里给出延伸方向。
二、设计:压缩触发状态机与模块边界
压缩不是一个函数,而是一个每轮都要走一遍的判定流程。把 M3 的触发逻辑画成状态机,只有四个状态和一条硬失败分支。
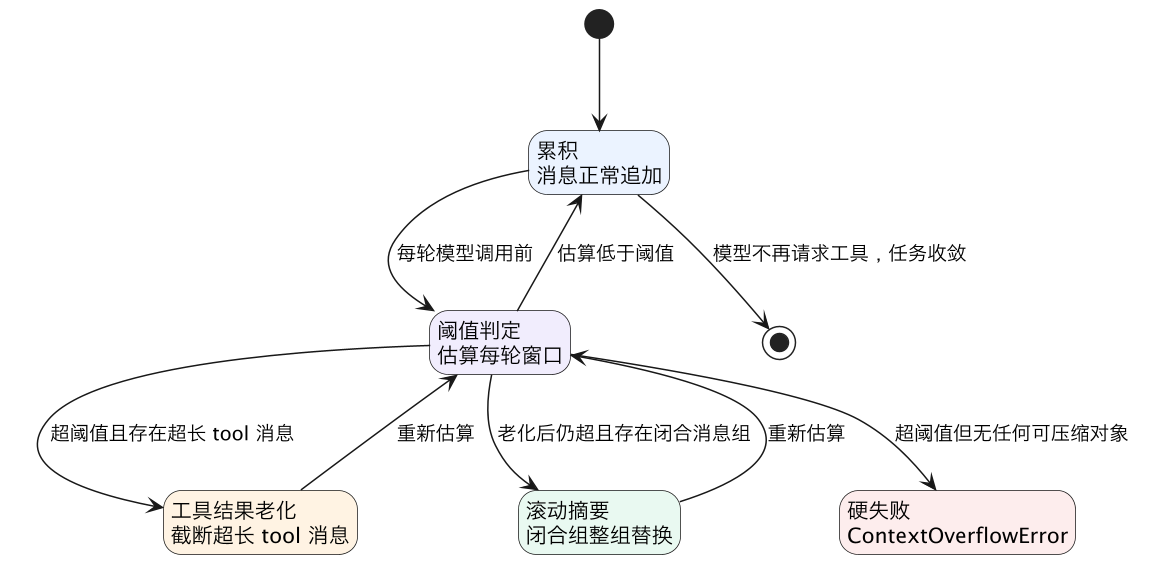
读这张状态机抓住两个回路。短回路是「判定 → 老化 → 判定」,只缩短 tool 消息的内容,消息条数和角色顺序完全不动;长回路是「判定 → 摘要 → 判定」,会把一组旧消息整条替换成摘要,消息条数明显下降。两个回路都可能在同一轮触发——实测第 9 轮就是老化之后仍然超标,摘要接着生效。最右侧的硬失败分支不是摆设:如果超标的是 system 消息本身或受保护的任务消息,两个策略都无权动它,继续假装能压缩只会让下一轮 API 调用报更难懂的错,不如在 harness 层抛出明确的 ContextOverflowError。
模块边界上,M3 只新增一个文件 mini_agent/compression.py,对 M1/M2 代码的侵入仅有 loop 里的一个可选参数。
这张依赖图的关键是 ContextWindow 成为 loop 唯一可见的入口:loop 不知道内部有几个策略、各自怎么剪,它只在每轮调用模型前问一句「窗口治理了吗」。管道内部先老化、后摘要,顺序固定,因为老化成本低且无损配对,应当优先耗尽它的空间。摘要器走模型适配器边界——ScriptedModel.summarize 从消息内容本身生成确定性文本,将来接真实模型时只需把同名方法换成一次 LLM 调用,压缩模块一行不改。
保护边界是设计中最需要纪律的部分,三条规则在代码里都是硬约束:
- 开头的 system 消息与第一条 user 任务消息永远不压缩,它们定义了 agent 的身份和目标;
- 摘要只替换完整闭合的消息组——一条带
tool_calls的 assistant 消息,必须和它对应的全部 tool 消息一起被替换,绝不允许留下没有回答的工具调用; - 最近 4 条尾部消息受保护,保证模型眼前的推理链始终是完整原文,压缩只动「远期记忆」。
三、对比:老化与摘要的取舍
两种策略都在 M3 里实现,是因为它们处理的对象和损失模式根本不同,硬合成一个策略反而讲不清边界。
| 对比维度 | 工具结果老化 | 滚动摘要 |
|---|---|---|
| 处理对象 | 单条超长 tool 消息的 content | 一组闭合的 assistant/tool 消息 |
| 消息条数 | 不变 | 显著减少(实测 14 条折 1 条) |
| 配对关系 | tool_call_id 原样保留 | 整组替换,不存在悬空配对 |
| 保留的信息 | 首部、尾部、原字符数/行数/错误码 | 每步动作、工具名、回报首行 |
| 损失的信息 | 中段原文 | 原始措辞与完整回报 |
| 是否需要模型参与 | 不需要,纯字符串处理 | 需要摘要器(教学工程用确定性实现) |
| 触发频率(本实验) | 8 轮 | 1 轮 |
| 适用场景 | 日志、文件内容等大块回流 | 多轮之后的整体历史收敛 |
老化的价值是「便宜且可逆推」:结构头里记下原始字符数、行数和错误码,模型至少知道这条回流曾经有多大、是否失败,配合保留的首尾片段,大多数排错推理仍能进行。摘要的价值是「减条数」:当十几轮对话的固定结构开销本身就积少成多时,只剪内容已经不够,必须让消息数量下一个台阶。代价是摘要经过一次再表述,原始细节不可逆——所以摘要器的输出必须完全来自消息原文,不能自由发挥,M3 的确定性摘要逐字引用每条 assistant 动作文本和 tool 回报首行,正是为了把再表述的自由度压到零。
两者的关系是分层防线而不是二选一:老化守第一关,把每一条大回流压到几百 token;摘要守第二关,在老化后的历史仍然超标时整组折叠。实测中老化触发 8 轮、摘要只触发 1 轮,这个比例符合预期——单条消息超标的概率远高于整体历史超标的概率。
四、实现:估算口径、老化截断与闭合组替换
先看统一的 token 估算函数。教学工程不接分词器,用字符级口径换取确定性:CJK 字符每个按 1 token,其余字符每 4 个折 1 token,每条消息加 4 token 结构开销,每个工具调用另计 8 token 加工具名长度。
def estimate_tokens(messages):
    total = 0
    for msg in messages:
        total += 4
        text = msg.get("content") or ""
        cjk = len(_CJK_RE.findall(text))
        total += cjk + (len(text) - cjk + 3) // 4
        for call in msg.get("tool_calls") or []:
            total += 8 + len(call.get("name", ""))
return total这个口径不追求与某家分词器精确对齐,追求的是同一输入永远得到同一数字,trace 才能逐轮对拍。真实产品在同一位置调用的是模型官方 tokenizer,接口形状完全一样:输入消息列表,返回整数。
老化策略的核心是一次有纪律的内容替换。注意它对任何位置的超长 tool 消息都生效——会话早期只有一条大回流时,「保护最近消息」救不了窗口,而截断 content 不破坏配对,所以没有理由豁免最新一条。
header = "%s 原 %d 字符 / %d 行" % (
    _AGING_MARK, len(content), len(content.splitlines()))
if msg.get("error"):
    header += " / 错误码 %s" % msg["error"].get("code")
msg["content"] = "\n".join([
    header,
    content[:self.head_chars],
    "……(中段已省略,完整内容见运行日志)……",
    content[-self.tail_chars:],
])
老化后的消息长这样(摘自真实 trace):结构头交代原始体积,错误码字段保证 M2 的结构化错误回流在压缩后依然可分类。标记前缀同时承担幂等职责——已经老化过的消息二次扫描时直接跳过,不会被反复套娃。
摘要策略最复杂的部分是闭合组判定。区间起点固定在受保护头部之后(system 与首条 user 之后),终点是尾部保护窗口之前;如果区间尾部恰好切在一组工具调用中间,就逐条收窄终点,直到区间内每个 tool_calls 都能在区间内找到对应 tool 消息、且区间里只有 assistant/tool 两种角色。
while end > start and (call_ids != answered or any(
        msg.get("role") not in ("assistant", "tool")
        for msg in messages[start:end])):
    end -= 1
    # 重新计算区间内的调用 id 集合与回答 id 集合
通过校验后,整段消息被一条 user 角色的摘要消息替换,摘要文本由 ScriptedModel.summarize 生成。下面是一次真实压缩回合的时序,第 9 轮两个策略先后生效。
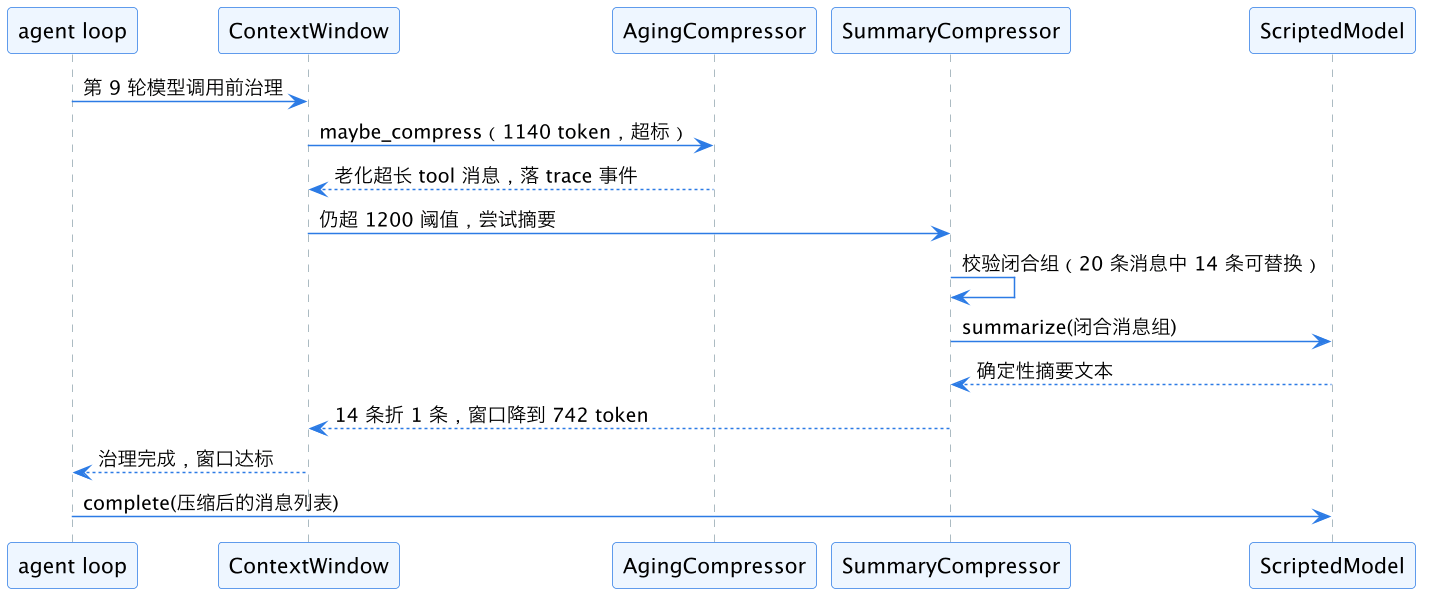
时序图里有两个细节值得注意。其一,loop 在整个过程中只和 ContextWindow 说话,两个压缩器对它透明;其二,模型这一轮实际上被调用了两次——一次作为摘要器处理旧历史,一次作为决策者处理压缩后的新窗口,两次调用的输入输出都进 trace,可以事后复盘模型「被剪掉了什么」。
loop 侧的增量只有三行,默认参数为 None 时行为与 M1/M2 完全一致,旧测试零改动。
if context_window is not None:  # M3:模型调用前先做窗口治理
    context_window.before_model_call(messages, tracer, step)
reply = model.complete(messages)
五、测试与长会话实测
M3 新增 11 个 headless 用例,连同 M1 的 5 个、M2 的 12 个共 28 个,全部在标准库下运行。新增用例覆盖四个层面:估算口径的确定性与 CJK/ASCII 权重;老化的阈值触发、幂等性、system 消息豁免与配对保留;摘要只替换闭合组、保护头尾部;以及一条完整长会话在压缩管道下正常收敛。
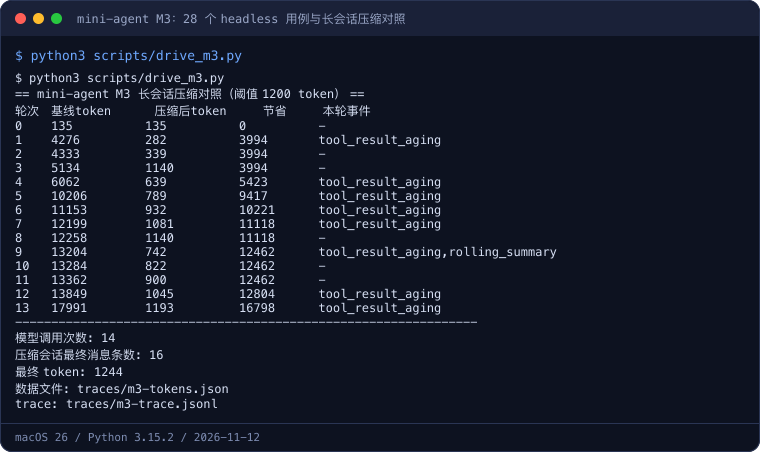
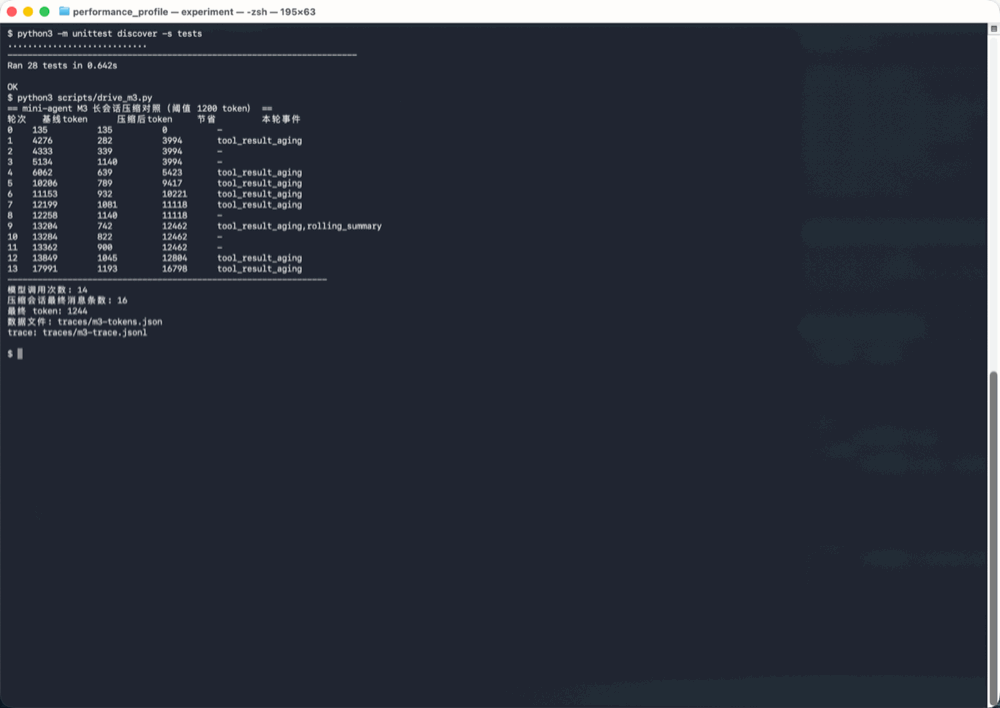
终端卡里的对照表是本篇最核心的实测证据。14 轮模型决策中,不压缩基线的窗口从 135 token 一路涨到 17991;压缩会话同轮次的窗口始终被按在 1200 阈值线附近,第 13 轮只有 1193 token,相对基线的 17991 压缩了约 93%。第 1 轮首次老化把单条 16400 字符的回流从 4276 token 砍到 282;第 9 轮老化与摘要同时触发,消息条数从 20 条直落到 7 条。
trace 里每个动作都有结构化记录。首次老化事件记录了受影响的消息索引与前后 token,摘要事件则留下完整的消息组规模。
{"type": "event", "event": "context_compression", "payload": {"step": 1, "strategy": "tool_result_aging", "before_messages": 4, "after_messages": 4, "before_tokens": 4276, "after_tokens": 282, "affected_indexes": [3]}, "seq": 8}
{"type": "event", "event": "context_compression", "payload": {"step": 9, "strategy": "rolling_summary", "before_messages": 15, "after_messages": 7, "before_tokens": 1282, "after_tokens": 742, "affected_indexes": [2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 15]}, "seq": 54}
两条事件并排看,两种策略的性格差异一目了然:老化事件前后消息条数都是 4,只动内容;摘要事件把 15 条消息压到 7 条,动的是结构。affected_indexes 让任何一次信息损失都可以精确回溯到具体消息,这正是生产 harness 排查「模型为什么忘了某件事」时需要的审计线索。
把逐轮数据画成曲线,压缩的节奏更直观。
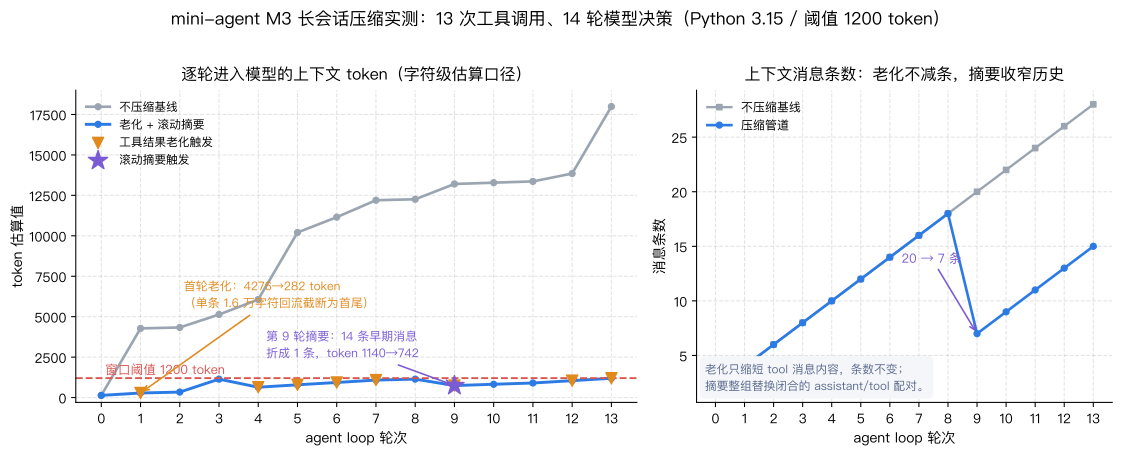
左面板是每轮真正发给模型的 token 估算。灰色基线近乎线性爬升到接近 18000,蓝色压缩线始终贴着红色阈值虚线下方运行,橙色倒三角标出 8 次老化触发点,紫色五角星是唯一一次摘要触发。可以看到压缩线不是单调的:每次老化后明显下台阶,随后随着新消息追加重新爬升,形成一条贴着阈值呼吸的锯齿线。右面板解释了两条策略在消息维度的分工——老化全程不改变条数,蓝灰两条线在第 9 轮之前完全重合;摘要触发的瞬间蓝线从 20 条垂直跌落到 7 条,之后重新线性增长,与灰线拉开恒定差距。
长会话最终以正常的最终答案收敛,共 14 次模型调用、16 条最终消息。需要说明一个口径细节:最后一条 assistant 回复追加之后窗口为 1244 token,略超 1200 阈值——阈值约束的是每轮发给模型之前的窗口,观察者记录的 14 个轮前值全部达标,模型自己产出的回复不受此限,这与真实 API 的计费边界一致。
测试还固定了硬失败语义:当一条 4000 字符的 user 消息本身就超过阈值时,两个策略都无权动它,ContextWindow 直接抛出 ContextOverflowError 而不是带着超长输入去撞 API。这个用例保证「压不动就明确失败」不会在后续重构中被悄悄改成静默放行。
实验环境
- 机器/系统:Mac mini / macOS 26(Darwin 25.5.0)
- 工具版本:Python 3.15.2(仅标准库,无第三方依赖)
- 日期:2026-11-12
- 完整命令:
cd demos/mini-agent
python3 -m unittest discover -s tests   # M1+M2+M3 共 28 个 headless 用例
python3 scripts/drive_m3.py             # 长会话压缩对照,写 traces/m3-trace.jsonl 与 m3-tokens.json
实验参数:窗口阈值 1200 token,老化首部保留 160 字符、尾部 120 字符、最小触发长度 240 字符,摘要保护最近 4 条消息;工作区含 200 行、16400 字符的 long_notes.txt,任务脚本为 scripts/m3_task.json,共 13 次工具调用、14 轮模型决策。
代码获取
mini-agent M3 的压缩模块、长会话驱动、任务脚本与全部测试已同步到公开仓库:
- 仓库地址:https://github.com/derekzhuo/geek-doc.cn
- 目录:mini-agent/
- 复现方式:进入
mini-agent/,执行make run-m3查看本篇完整压缩对照与逐轮 token 表;make test跑 28 个回归用例;make run与make run-m2仍保留前两篇的演示。修改scripts/m3_task.json的threshold或回复序列可观察不同触发节奏。
这一篇在知识体系里的位置
本篇承接 Agent Loop 解剖 的消息生命周期,把 loop 的「完整历史递交给模型」补上了预算治理这一层;触发后的工具结果仍遵循 function calling 工具系统 的角色与配对契约,压缩不会破坏 tool_call_id。宏观定位见 coding agent 全景。六条路径中本篇落地了两条,分段摘要与外置召回面向跨天长期任务,输入侧预算治理与工具声明规模相关,后者和 MCP 协议 的工具供给方式直接相连;通过精简提示词缓解窗口压力的思路则属于 提示工程指南 的范畴。下一篇 M4 将进入子代理编排:当单个上下文实在装不下任务时,主代理可以 fork 出独立上下文的子代理,用进程级隔离替代单窗口内的压缩。
总结
context 压缩机制的本质是 harness 对无状态模型的预算治理:窗口有硬上限,而工具结果是历史膨胀的主要来源,所以压缩必须在每轮模型调用前完成。mini-agent M3 用字符级确定性估算做计量,实现了工具结果老化与滚动摘要两条真实策略——前者保留首尾与结构头、不动消息配对,后者只替换完整闭合的消息组、保护系统消息与近期尾部,压不动时抛明确的硬失败。13 次工具调用的长会话实测显示,压缩会话每轮窗口都守在 1200 token 阈值内,末轮相对不压缩基线的 17991 token 收敛到 1193,28 个 headless 用例与逐条 trace 事件证明:压缩剪掉的是冗余体积,而不是任务继续下去所需的事实。