万卡训练为什么总在“崩”:超大规模训练的故障与可靠性
数据截止 2026-09。承接万卡集群网络拓扑、Megatron 与 3D 并行训练系统、一度电的旅程。
小规模训练里,一次跑挂了重跑即可;但当一次前沿训练动用上万张加速卡、跑上数月、烧掉数百万乃至更高量级算力,“崩一次”的代价大到无法承受。此时系统的核心问题发生了根本转变:不再是“会不会出故障”,而是“多久出一次、多久能恢复、会丢多少进度”。 在这个尺度上,可靠性不是一项锦上添花的指标,而是决定一项训练能否如期完成的工程主线。
先说结论
- 故障概率随规模近似线性放大:单机再可靠,上万台设备的集群平均无故障时间(MTBF)可能短到以小时计,中断是常态而非意外。
- 故障源遍布全栈:GPU 掉卡/XID 错误、网络闪断、存储抖动、节点死机、电源与散热、软件 bug,任一环节都可能拖垮全局同步的训练。
- checkpoint 是生命线:周期性保存模型/优化器状态决定崩溃后最多丢多少进度,保存频率与开销、存储带宽之间要权衡。
- 静默数据损坏(SDC)最难缠:不报错、却悄悄算错,可能污染权重、数周后才发现,需要校验与定期自检。
- 可靠系统的设计哲学是“假设高频故障、追求快速恢复”,而非“永不出错”:故障隔离、局部重启、冗余与自动恢复把损失压到最小。
节点速览:技术 / 玩家 / 成熟度 / 预期
数据截止 2026-09。标尺说明见 AI 产业链总览。
| 象限 | 要点 |
|---|---|
| 关键技术 | ① checkpoint 与异步/分层保存(TRL-4)② 故障检测与自动重启/局部恢复(TRL-3~4)③ 冗余与故障域隔离(TRL-3~4)④ 静默数据损坏检测(TRL-2~3)⑤ 在离线/弹性训练(TRL-2~3) |
| 主要玩家 | 系统方:英伟达(编排/整柜软件栈)、各大框架与训练平台(Megatron、DeepSpeed 等);运营方:前沿实验室与云的基础设施/SRE 团队;硬件方:GPU、网络、存储厂商共同降低失效率 |
| 做到什么程度 | checkpoint+重启已成标配;自动故障隔离与节点替换在头部成熟;真正的弹性在离线训练仍处早期;SDC 检测与端到端可靠性仍是前沿难题 |
| 后续预期 | 6 个月:编排软件强化自动恢复(置信度高);18 个月:更频繁轻量 checkpoint 与弹性恢复普及(置信度中);36 个月:十万卡级可靠性工程体系成形(置信度中) |
一、为什么规模一大就“必然崩”
训练是全局同步的:每一步,所有 GPU 都要完成计算、交换梯度、彼此对齐才能进入下一步。只要有一个环节掉队或出错,整批设备都可能被迫停下来等或直接失败。 故障概率随设备数近似线性累积。
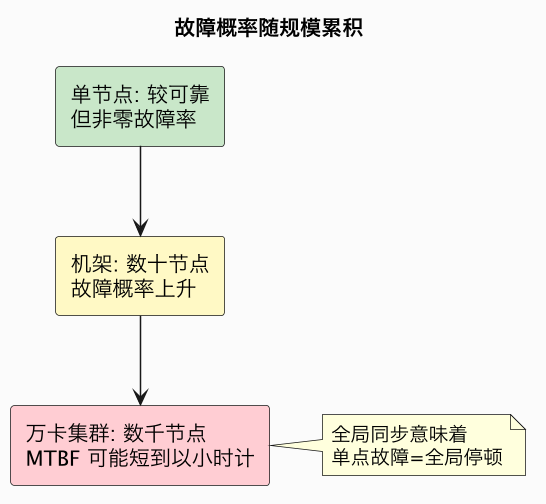
打个量级比方:若单台机器平均无故障时间是数千小时,数千台同时工作时,整个集群“任意一台出问题”的平均间隔会骤降到数小时量级。这意味着在一次持续数月的训练中,遭遇几十上百次中断并不夸张。因此工程目标从“消灭故障”转为“让故障可承受、可快速恢复”。
二、故障都从哪来:全栈皆可崩
故障源横跨硬件、网络、存储、电力和软件,且表现形式各异。
| 层 | 典型故障 | 后果 |
|---|---|---|
| GPU/节点 | 掉卡、XID/ECC 错误、死机、过热降频 | 该 rank 失败、全局中断 |
| 网络 | 链路闪断、交换机/光模块故障、拥塞丢包 | 集合通信超时、训练 hang |
| 存储 | 元数据/IO 抖动、读写失败、带宽打满 | checkpoint 失败或喂数停滞 |
| 电力/制冷 | 市电切换、局部掉电、热点温升 | 机架/分区批量宕机 |
| 软件 | 框架/驱动/CUDA bug、内存泄漏、死锁 | 崩溃或静默错误 |
其中网络故障在万卡集群尤为突出:一次集合通信要穿过多级交换机与大量光模块,任何一段链路异常都可能让全局通信超时;这也是万卡集群网络拓扑强调多平面冗余与故障域划分的原因。电力侧,市电切换、UPS/柴发动作或局部热点,可能一次带走整柜甚至整个配电域,使“故障爆炸半径”远大于单机故障。
三、checkpoint:崩溃后的“存档点”
游戏里有存档,训练里靠 checkpoint:周期性把模型权重、优化器状态(如动量)、学习率调度器、数据游标等完整状态写到持久存储。崩溃重启后从上一个存档点继续,而非从头再来。
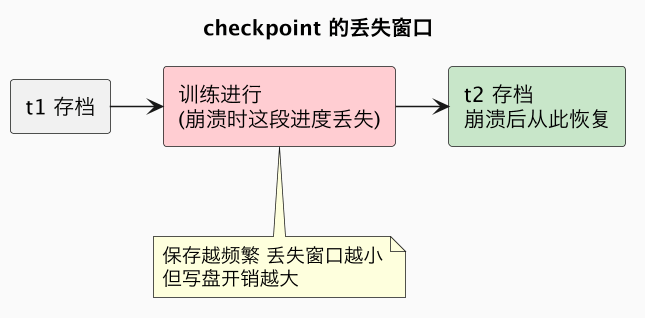
这里存在核心权衡:存得越频繁,崩溃后丢失的计算越少,但每次写盘(模型+优化器状态可达数 TB)会占用存储带宽、暂停或拖累训练。 前沿实践用异步/后台 checkpoint、分层存储(快层落盘、慢层归档)、增量/分片保存等手段降低开销,并在检测到故障征兆时“抢存”一次。checkpoint 的写入本身也要校验,否则恢复时才发现存档损坏,等于白存。
四、静默数据损坏:不报错才算错
最危险的不是“明显崩了”,而是系统没崩、却悄悄算错——静默数据损坏(SDC)。来源可能是显存/链路位翻转、硬件竞态、数值不稳定或底层库缺陷。它不触发报错,训练照常进行,却可能让某些参数被污染、loss 悄悄异常,等到数周后模型表现变差才被察觉,此时已浪费巨量算力且难以回溯。
- 检测:对关键张量做校验和、跨副本结果一致性比对、周期性“黄金参考”自检、loss/梯度异常监控。
- 缓解:ECC 内存、端到端数据完整性校验、可疑节点隔离与轮换、以及保留多个 checkpoint 以便回退到污染之前。
- 难点:检测本身有开销,且并非所有偏差都能被识别,需要在成本与覆盖间平衡。
五、可靠性工程的转向:与故障共存
综合来看,超大规模训练的方法论已从“追求零故障”转为“假设故障高频发生,把每次故障的损失与恢复时间压到最小”。
- 故障隔离与爆炸半径控制:划分故障域、多网络平面、冗余供电,让单点故障不扩散。
- 自动检测与(局部)重启:健康检查发现坏卡/坏节点后自动摘除、替换备件、从 checkpoint 恢复,减少人工介入与排队等待。
- 冗余与备件:预留热备节点/机架,故障即补,缩短停机。
- 弹性/在离线训练:理想形态是节点增减时训练不重启、规模可伸缩;这要求并行策略与通信拓扑动态适配,目前仍处早期,是向十万卡演进的关键方向。
这套体系由硬件失效率、集群编排软件(如整柜/调度层)、训练框架与 SRE 流程共同支撑,本质和大型互联网系统的 SRE 相通,只是赌注(一次训练的成本与时间窗口)高得多。
常见误区
- 误区:集群崩说明设备质量差。 规模一大,再好的设备也会高频故障,重点是恢复能力。
- 误区:checkpoint 存一次就够。 保存频率、完整性校验与存储带宽要系统设计。
- 误区:没报错就是没问题。 静默数据损坏可能数周后才暴露且极难回溯。
- 误区:重启一次损失不大。 全局同步下重启可能损失大量已算进度并占满存储 IO。
- 误区:弹性训练已普及。 节点动态增减仍处早期,是未来重点。
总结
万卡训练的故障不可避免——全局同步让单点故障放大为全局停顿,集群 MTBF 可能短到以小时计,而故障源横跨 GPU、网络、存储、电力与软件;应对之道不是追求永不出错,而是以 checkpoint 守住进度底线、用校验与自检揪出不报错的静默损坏、靠故障隔离、热备替换与自动重启把恢复时间和爆炸半径压到最小,最终在‘高频故障成为常态’的前提下,让一次耗资巨大的长跑仍能稳定抵达终点。
相关与延伸
- 故障如何沿网络放大:万卡集群网络拓扑
- 并行与通信的系统基础:Megatron 与 3D 并行训练系统
- 电力故障来源:一度电的旅程
- 成本视角的 GPU 治理:AI FinOps:GPU 成本治理