先进制程工艺
一、一句话回答
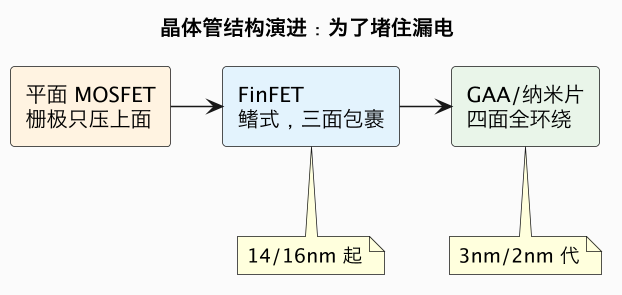
先进制程就是用更小、更密、更省电的晶体管制造芯片,是性能与能效的根基。当平面晶体管缩小到漏电无法控制,业界先转向 FinFET(把沟道竖成「鳍」、栅极三面包裹),再转向 GAA(栅极四面全环绕沟道,三星称 MBCFET、台积电用纳米片 nanosheet),以继续摩尔定律。与此同时,后端互连改用铜、低 k 介质和越来越多层金属布线,并大量引入 EUV。如今的「3nm/2nm」早已不是真实物理栅长,而是代际营销名。每一代缩微都靠新结构 + 新材料 + EUV 协同,难度和成本指数上升,而它直接决定 AI 芯片最关键的指标——能效(每瓦算力)。
为什么先进制程对 AI 关键。AI 训练和推理的瓶颈很大程度是功耗与散热:在同样功耗下,越先进的工艺能塞进更多晶体管、跑得更省电,意味着更高的算力密度和更低的单 token 能耗。英伟达旗舰 GPU 与最新 HBM 接口,都绑定最先进的制造节点。
二、先进制程在挑战什么
| 维度 | 问题 | 应对 |
|---|---|---|
| 晶体管 | 缩短后漏电、短沟道效应 | FinFET→GAA,更强栅控 |
| 光刻 | 图案更小,DUV 多重曝光极限 | EUV、High-NA |
| 互连 | 连线延迟、电阻电容上升 | 铜互连、低 k、背面供电 |
| 材料 | 迁移率、接触电阻 | 高 k 金属栅、新沟道材料 |
| 热/功耗 | 密度高带来热密度问题 | 架构+封装+散热协同 |
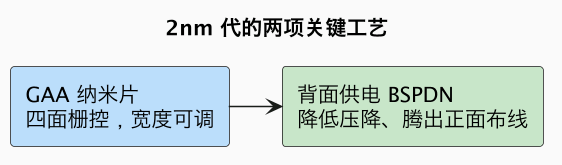
值得点出两个较新的方向。其一是 GAA 纳米片:把 FinFET 的鳍改成水平堆叠的多层纳米片,栅极四面环绕,沟道宽度还可调,能更好抑制漏电,是 3nm/2nm 代的关键。其二是 背面供电网络(BSPDN,如英特尔 PowerVia、各家路线):以往晶体管和供电线都在晶圆正面抢空间,把供电路径挪到背面可降低电压损耗、腾出正面布线空间,是 2nm 以下的重要工艺革新。
三、为什么「制程数字」不再等于尺寸
早期 0.18μm、90nm 大致对应真实栅长,但如今「7nm/5nm/3nm」更多是代际密度与性能的营销标签,各家定义不同,横向不能直接比较物理尺寸。真正可比的是:晶体管密度(MTr/mm²)、同功耗性能提升、同性能功耗下降,以及 N 代相对上一代的 PPA(性能-功耗-面积)改进。
四、成本与良率:先进的另一面
- 设计/流片成本飙升:先进节点一次流片与全套掩膜成本极高(见光掩膜),只有出货量大的芯片才划算。
- 良率决定盈亏:新结构导入初期缺陷多,良率爬坡慢,直接决定代工厂和客户的成本(见良率经济)。
- 只有头部玩得起:设备、研发、人才的门槛让先进制程玩家收敛到极少数。
节点速览:技术 / 玩家 / 成熟度 / 预期
数据截止 2026-09。标尺说明见 AI 产业链总览。
| 象限 | 要点 |
|---|---|
| 关键技术 | ① FinFET(TRL-5,成熟)② GAA 纳米片(TRL-3~4)③ 背面供电/High-NA(TRL-2~3) |
| 主要玩家 | 台积电(领先)/三星/英特尔代工;设备与材料由 ASML、Lam、AMAT 等支撑 |
| 做到什么程度 | 3nm 已规模出货(FinFET 收尾/首批 GAA),2nm 导入 GAA+背面供电 |
| 后续预期 | 6 个月:3nm 产能放量(高);18 个月:2nm 风险/量产(中);36 个月:1.4nm、CFET 等新结构预研(低) |
常见误区
- 把制程数字当成真实栅长:现在只是代际标签,要看密度和 PPA。
- 以为缩微只靠光刻机:新晶体管结构、材料和互连同样关键。
- 认为越先进越省钱:工艺本身和设计/流片成本反而更高,靠出货量摊薄。
- 忽视能效意义:对 AI 而言先进制程最大的价值是每瓦算力。
总结
先进制程靠晶体管结构从平面到 FinFET 再到 GAA 纳米片、配合 EUV、铜互连和背面供电,把摩尔定律艰难延续;制程数字已沦为代际标签,真正可比的是密度与 PPA,而新结构导入带来的设计成本和良率门槛让玩家收敛到极少数——对 AI 来说,这场越来越贵的缩微游戏最大的回报,就是每一瓦电能换来更多算力。