CPU AI 推理:GPU 抢走聚光灯后,CPU 在 AI 系统里到底还干什么
最后更新:2026-09-28|数据截止 2026 年中:具体芯片算力、带宽与售价以各家官方发布为准,本文用代际与量级表述;Grace-Blackwell、x86 AMX、ARM SVE 等路线图为公开信息,量产与出货节奏有不确定性。
本文是产业观察,回答一个被 GPU 叙事淹没的问题:当所有预算都涌向 GPU,CPU 在 AI 系统里是退场了,还是换了个更值钱的位置? 本仓库的读者天天和 Linux、perf、numactl 打交道,对 CPU 有肌肉记忆,这一篇就从系统分工的角度讲清:哪些负载永远留在 CPU 上、CPU AI 推理什么时候依然划算、以及为什么 Grace-Blackwell 这类紧耦合超芯片反而让 CPU 重新升值。它与 KV Cache 经济学(显存墙)、推理引擎之争(调度软件栈)、英伟达整柜战略(系统形态)直接咬合。
先说结论
- CPU 没有消失,它是 AI 系统的「总调度」。 任何一张 GPU 都不能自己干活:数据从磁盘和网络进来要预处理,kernel 要有人 launch,checkpoint 要有人写盘,多卡多机要有人编排。host CPU 干的就是这些——GPU 是计件工人,CPU 是车间主任。
- CPU 侧瓶颈是真实存在的隐性成本。 GPU 利用率上不去,常见原因之一不是 GPU 慢,而是 host CPU 喂不动:数据增强把核打满、Python 调度开销让小 kernel 空转、NUMA 跨 socket 访问拖慢 H2D 拷贝。perf 一跑,火焰图里一大半在 dataloader。
- CPU AI 推理在两类场景依然经济:小模型低并发服务,和推荐/广告排序这类稀疏负载。 AVX-512、AMX(x86)与 ARM SVE/SME 让 CPU 的 INT8 矩阵吞吐在近年跨了一个数量级,几十亿参数以内、QPS 不高的业务,用现成的 CPU 服务器跑推理,总拥有成本经常低于为它单买 GPU。
- Grace-Blackwell 这类紧耦合 CPU+GPU 超芯片,把 CPU 从「外围打杂」拉回价值中心。 CPU 用超大一致性内存给 GPU 当「显存扩展池」和预取后端,CPU 内存容量和带宽直接变成推理性能参数——CPU 的角色不是变小了,是被重新定价了。
一句话:GPU 决定 AI 系统的峰值,CPU 决定这个峰值能不能被喂出来;推理时代,「什么样的负载留在 CPU、什么时候必须上 GPU」本身就是一笔要算清的经济账。
一、GPU 不能自己干活:host CPU 的四份本职
先回到一台 8 卡 GPU 服务器里实际发生了什么。一次训练 step 或一次推理请求,落到硬件上是一条流水线,而这条流水线的大部分环节根本不在 GPU 上。
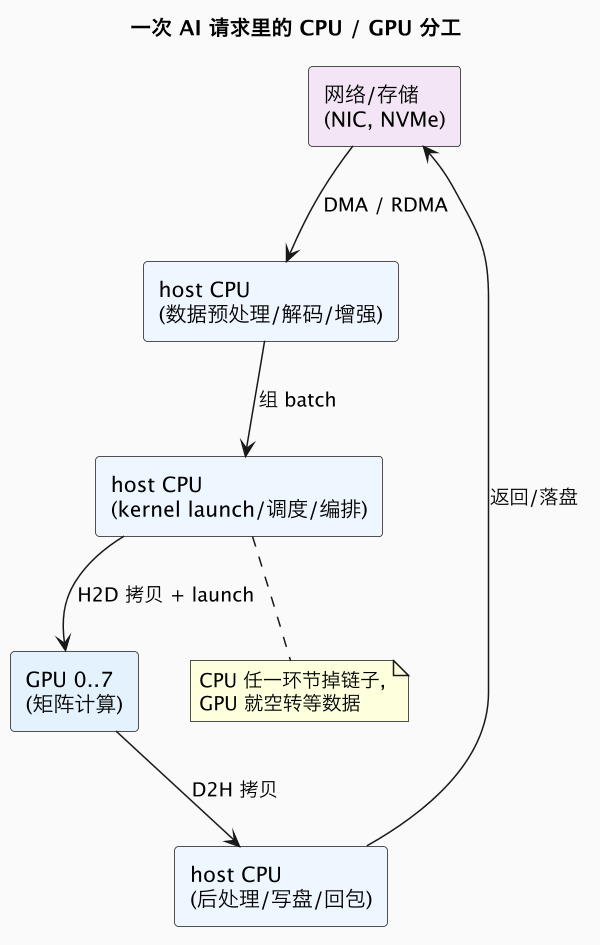
拆开看,host CPU 有四份躲不掉的本职:
数据预处理。 训练侧的解码、增强、tokenize,推理侧的请求解析,全在 CPU 上。图像 pipeline 尤其重,高吞吐训练任务把上百核的 host 吃到七八成很常见。
kernel launch 与运行时调度。 GPU 上每次计算都要 CPU 经驱动提交。小 kernel、碎算子、Python 框架开销,都会变成 CPU 侧串行瓶颈——推理引擎(见 vLLM 与 TRT-LLM 之争)大做 CUDA Graph、continuous batching,本质都是削减 CPU 每次发射的调度税。
I/O 与 checkpoint。 模型动辄几百 GB,checkpoint 写盘、数据拉取、KV Cache 在显存/内存/SSD 间的换入换出(见 KV Cache 经济学),路径全过 CPU 内存子系统。
编排。 多卡集合通信的 host 侧协调、容器调度、健康检查、流量分发。集群越大,这部分纯 CPU 负载越重。
所以「买 GPU 送 CPU」的说法恰好说反了:没有足够强的 host CPU,GPU 只是一屋子昂贵的电暖器。
二、被低估的瓶颈:GPU 利用率上不去,先看 CPU
用 perf 的视角看一个典型的「GPU 利用率只有 50%」投诉,排查路径往往是这样的:nvidia-smi 显示 GPU 时忙时闲,pidstat 一看 host 侧若干核被打满,perf top 里热区在 dataloader 和 Python 解释器,numactl --hardware 再一看,GPU 挂在 NUMA node 1 而进程内存分配在 node 0——H2D 拷贝跨 socket 走 UPI/Infinity Fabric,带宽腰斩。
共性是 GPU 的供给能力超过了 CPU 管线的供给能力:
| 失配点 | 症状 | 典型根因 |
|---|---|---|
| 数据预处理不足 | GPU 利用率周期性掉到低位 | dataloader worker 数不够、解码在单线程 |
| launch 开销过大 | 小 batch 推理延迟高、吞吐上不去 | 算子碎、Python 调度税、未用 CUDA Graph |
| NUMA 错配 | H2D 带宽只有标称一半 | 进程与 GPU 不在同一 NUMA node |
| 内存带宽争抢 | 推理尾延迟抖动 | checkpoint、KV 换出与预处理抢内存控制器 |
| 网卡软中断集中 | 网络吞吐上不去、局部核 100% | IRQ 未绑核、未开 RSS/XPS |
这也解释了为什么头部 GPU 服务器的 host CPU 配置在持续加码。英伟达自己做 Grace 的公开理由之一,就是 x86 host 的内存带宽和 PCIe 拓扑跟不上 GPU 的胃口。CPU 的价值,是被 GPU 的需求反向定义出来的。
三、CPU AI 推理的回春:什么时候不上 GPU 反而更赚
训练几乎全面 GPU 化,但推理是另一本账。推理负载千差万别,GPU 只在「足够大、足够密、足够并发」时才算得过账。下面这张决策表是本文的核心:
| 负载特征 | 留在 CPU | 必须上 GPU |
|---|---|---|
| 模型规模 | 数十亿参数以内,INT8/INT4 量化后装进内存 | 百亿参数以上,或显存内放不下 KV Cache |
| 并发形态 | 低 QPS、延迟不敏感、突发流量 | 高 QPS、continuous batching 摊薄成本 |
| 算子结构 | 稀疏(推荐系统 embedding 查表)、控制流多 | 稠密矩阵乘为主、算子规整 |
| 内存足迹 | 大内存小算力(特征仓库、大 embedding) | 大算力,HBM 带宽敏感 |
| 既有资产 | 已有大量 CPU 服务器、利用率不满 | 新建推理集群,按 GPU 规划 |
三个支撑 CPU 推理经济性的硬件变化值得单独讲。
AVX-512 与 AMX(x86 阵营)。 AMX(Advanced Matrix Extensions,英特尔自 Sapphire Rapids 引入的矩阵扩展)用专用 tile 寄存器和 TMUL 指令做 INT8/BF16 矩阵乘,让 CPU 的 int8 吞吐相比纯 AVX-512 时代跨了一个量级。量化后的小模型,一颗现代双路 x86 跑出的 tokens/s 足以覆盖大量企业内部服务的 QPS——而量化路径(INT8 乃至 FP8/FP4,见 量化经济学)在 CPU 上同样成立。
ARM SVE/SME(ARM 阵营)。 可变长向量 SVE 与矩阵扩展 SME,配合 ARM 服务器众核、高内存通道数,在「内存容量大、计算密度低」的负载上性价比突出。AWS Graviton 系把推理实例当卖点,逻辑就在于此。
稀疏负载天然属于 CPU。 推荐/广告排序的核心是超大 embedding 表的查表加小 MLP,计算密度低、内存足迹巨大、控制流不规则——这正是 GPU 最不擅长的形态。业界的推荐推理集群至今仍以 CPU 为主力,不是因为买不起 GPU,而是这笔账怎么算都是 CPU 赢。
一句话划边界:GPU 按「峰值算力 × 利用率」计价,CPU 按「现成资产 × 够用就行」计价;当负载喂不饱 GPU 时,CPU 就是更便宜的那个。
四、Grace-Blackwell:CPU 被重新定价的信号
如果说 AMX/SVE 是让 CPU 在「不需要 GPU 的负载」里守住地盘,Grace-Blackwell 这类超芯片则是让 CPU 在「GPU 的地盘」里升值。
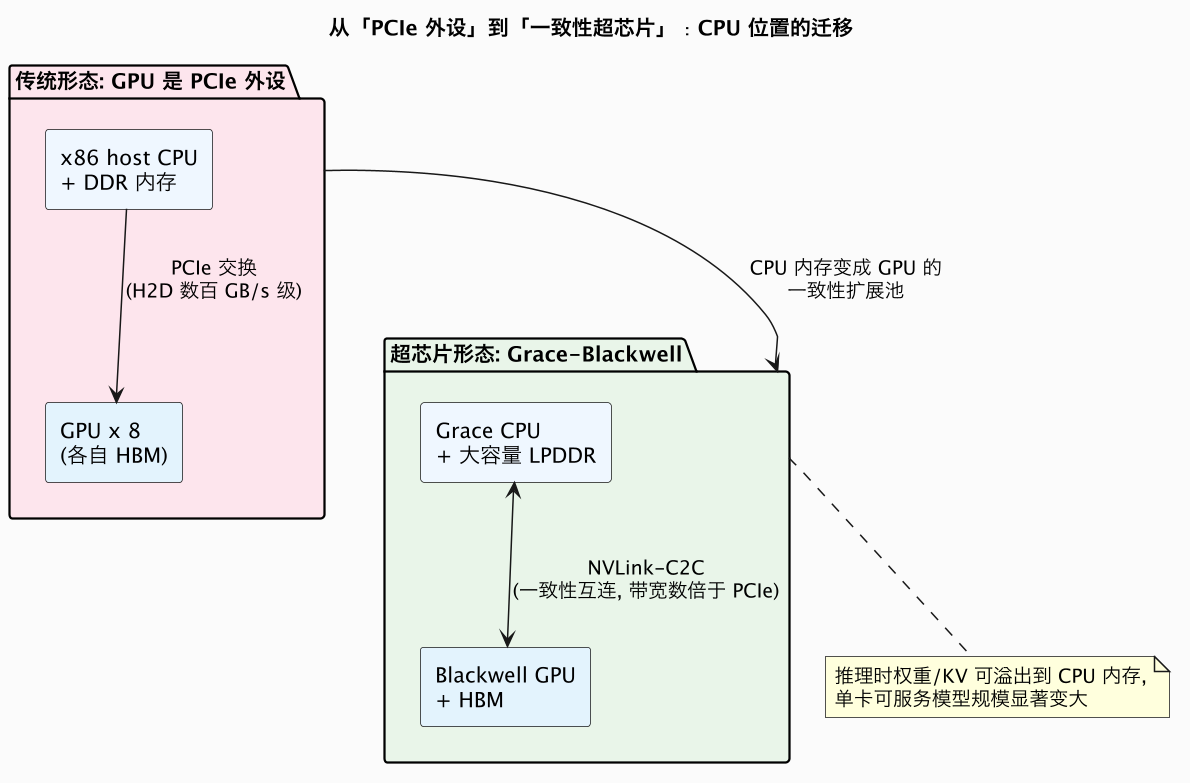
这张图的关键变化是互连语义:传统形态里 GPU 挂在 PCIe 上,CPU 内存和 GPU 显存是两个世界,数据靠显式拷贝;Grace-Blackwell 用 NVLink-C2C 把 CPU 和 GPU 连成一个缓存一致性的域,Grace 侧的大容量 LPDDR 内存(单超级芯片数百 GB 量级)可以被 GPU 直接寻址。对推理的直接意义是:模型权重和 KV Cache 可以溢出到 CPU 内存,单卡可服务的模型规模不再被 HBM 容量卡死——这正好打在 KV Cache 经济学 讲的显存墙上。
产业含义有两层。其一,CPU 内存容量与带宽从此变成推理性能的一级参数,英伟达把 ARM CPU 焊进平台,顺带拿走了原本属于英特尔/AMD 的 host CPU 预算——这是 英伟达整柜战略 里「整柜打包」逻辑在芯片层面的预演。其二,x86 阵营的回应是把 host 做得更强:更多内存通道、CXL 内存扩展、与 GPU 的紧耦合方案。无论谁赢,CPU 子系统在 AI 服务器 BOM 里的价值占比是往上走的。
五、变量与置信度判断
| 变量 | 作用方向 | 时间窗 | 置信度 |
|---|---|---|---|
| host CPU 成为 GPU 利用率瓶颈被普遍认知 | AI 服务器 host 配置持续加码 | 已发生 | 高 |
| AMX/SVE 推动小模型 CPU 推理普及 | 企业私有推理大量留在 CPU | 1~3 年 | 高 |
| 推荐/稀疏负载继续以 CPU 为主 | CPU 推理基本盘稳固 | 已发生、延续 | 高 |
| 一致性超芯片形态扩张 | CPU 内存变推理性能参数 | 2~4 年 | 中高 |
| 推理 ASIC 绕过 host CPU 直挂网络/存储 | 部分场景削弱 host 角色 | 3~6 年 | 中 |
- 6 个月(高置信度):GPU 服务器的 host CPU 核心数、内存通道数继续上调;推理框架对 AMX 的优化默认开启;企业私有化部署里「小模型 + CPU」方案占比明显上升。
- 18 个月(中高置信度):Grace-Blackwell 系出货放量,一致性内存池成为推理标准卖点之一;x86 以 CXL 内存扩展回应;推理 ASIC(见 推理 ASIC 新赢家)在头部客户处尝试轻 host 架构。
- 36 个月(中置信度):CPU 在 AI 服务器 BOM 中的价值占比止跌回升成为共识;CPU 处理稀疏段、GPU 处理稠密段的异构调度进入主流推理引擎;纯 GPU 叙事退潮,系统按「每美元有效 tokens」整体计价(与 FinOps for AI 口径合流)。
六、对不同角色,这意味着什么
- 对基础设施/SRE 团队:GPU 集群利用率低时先查 CPU 管线——dataloader、NUMA 绑定、IRQ 绑核、内存争抢,perf 和 numactl 是比换卡便宜得多的第一刀。
- 对推理平台选型者:先按模型规模、QPS、算子密度对照第三节决策表再谈买什么卡;几十亿参数、低并发的内部服务,CPU-only 经常是 TCO 最优解。
- 对 CPU 厂商:AI 时代的护城河不在「替代 GPU」,而在 host 价值、内存子系统和稀疏负载基本盘;把 AMX/SVE 软件生态做顺,比讲故事重要。
- 对投资者:别把 CPU 当夕阳资产——host 加码、一致性超芯片、CXL 内存扩展三条线都在给 CPU 子系统重新定价;格局见 AI 芯片枢纽。
数据口径与延伸
- 数据口径:host CPU 分工、AMX/SVE 指令集能力、Grace-Blackwell 的 NVLink-C2C 一致性互连与内存容量量级、推荐系统 CPU 推理的主流地位,来自各家官方资料与行业公开研究的常见口径。具体算力与带宽数字以正式发布为准,本文用代际与量级表述。数据截止 2026 年中。
- 相关产业观察:KV Cache 经济学(显存墙与 CPU 内存池)、推理引擎之争(调度税)、量化经济学(CPU 推理的量化路径)、英伟达整柜战略(系统形态)、推理 ASIC 新赢家、FinOps for AI。
一句话总结:GPU 抢走聚光灯后 CPU 并未退场,而是牢牢占住 AI 系统的总调度位——数据预处理、kernel launch、I/O 与编排全在 host CPU 上,GPU 利用率上不去往往先查 CPU 管线;推理时代决策边界清晰:小模型低并发与推荐稀疏负载留在 CPU 更经济(AVX-512/AMX 与 ARM SVE 撑起了这条性价比曲线),大模型高并发才必须上 GPU;Grace-Blackwell 这类一致性超芯片把 CPU 内存变成 GPU 的扩展池,让 CPU 子系统在 AI 服务器 BOM 里重新升值——CPU 的角色不是变小了,而是被重新定价了。