大模型推理引擎之争:vLLM、TensorRT-LLM、SGLang 在抢什么
最后更新:2026-09-19|数据截止 2026 年中:开源推理项目迭代极快,本文讲机制与格局逻辑,具体特性以各项目当前版本为准,不引用未经核实的性能跑分。
本文是产业观察,回答:同样的 GPU、同样的模型,为什么换一个「推理引擎」,吞吐和成本能差出一大截。 GPU 算力账单 讲了推理为什么成为主要成本,KV Cache 经济性(本批 E4)讲显存如何成为瓶颈,CUDA 护城河 讲底层生态;本文聚焦直接决定「一张卡能服务多少用户」的软件层——推理引擎之争。
先说结论
- 推理引擎是把 GPU 变成「赚钱服务」的关键一层。 训练框架关心怎么把模型训出来,推理引擎关心怎么用最少的卡、最低延迟、最高并发把已经训好的模型服务出去,直接决定单 token 成本。
- PagedAttention 与连续批处理是分水岭式创新。 它们像给操作系统引入虚拟内存分页和高效进程调度:按需、分块管理 KV Cache 显存,并动态拼批,显著提升吞吐和显存利用率,奠定了新一代引擎的基础。
- 三大路线各有算盘:vLLM 事实开源标准,TensorRT-LLM 厂商极致优化,SGLang 主打结构化生成与新调度。 一个靠社区和易用性,一个靠英伟达硬件深度优化,一个靠前沿特性与场景化创新,彼此快速互相借鉴。
- 竞争焦点已从「跑得快」扩展到 KV Cache 治理、投机解码、PD 分离与多后端可移植。 引擎层正在成为与芯片、云并列的推理成本战场,也是开放生态对抗 CUDA 锁定的关键。
一句话:推理引擎是大模型商业化的「成本阀门」——PagedAttention 和连续批处理重写了显存与调度的基本法,vLLM、TensorRT-LLM、SGLang 在开源标准、厂商极致优化和前沿调度三条路线上竞速;谁能把同样的卡榨出更多便宜 token,谁就握住了 AI 服务的利润开关。
一、推理引擎到底在干什么
模型训练好之后,一次推理请求要经过:接收 token → 逐层前向计算 → 每步生成一个新 token(自回归)→ 直到结束。朴素地「一个请求占一张卡、算完再换下一个」会让昂贵的 GPU 大量空转。推理引擎的职责,就是在正确性不变的前提下,让 GPU 尽可能满载、让显存尽可能不浪费:
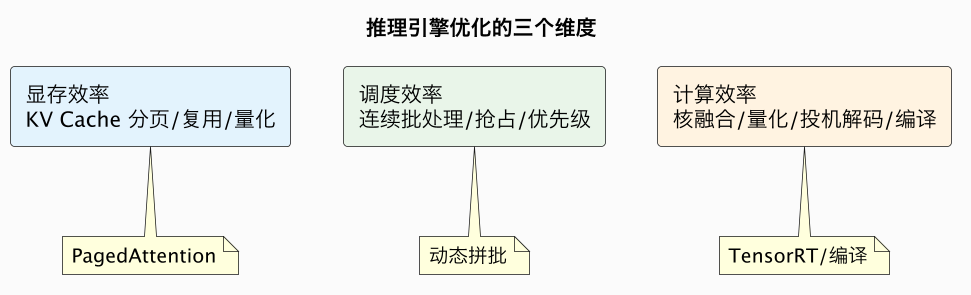
这层软件位于模型框架(PyTorch 等)与硬件驱动(CUDA)之间,向上提供 OpenAI 兼容 API、流式输出、多模型管理,向下调用高性能核(kernel)与显存管理。它和 Web 服务器、数据库一样,是「能不能把资源高效变现」的系统软件,只是服务的对象是 token。
二、两个分水岭:PagedAttention 与连续批处理
要理解今天的竞争,必须先理解两个被全行业迅速吸收的创新。
PagedAttention:给 KV Cache 做「虚拟内存分页」。 自回归生成时,模型要缓存每个 token 在每一层的 Key/Value 张量,即 KV Cache(详见 KV Cache 经济性)。早期实现为每个请求预留一整段连续显存,但请求长度未知、差异巨大,导致大量内部碎片和预留浪费。PagedAttention 借鉴操作系统的分页思想:把 KV Cache 切成固定大小的 block(块),按需分配、用块表(类似页表)记录逻辑到物理块的映射,碎片大减、显存利用率大增,还能在并行采样、beam search 间共享前缀块。这一设计是 vLLM 的标志性创新,随后成为行业通用做法。
连续批处理(continuous batching,也称动态/迭代级批处理):让 GPU 像高效调度进程一样拼请求。 传统静态批处理要等一批里最长的请求完成才换下一批,先完成的请求占着位置空等;连续批处理在每个生成步(iteration)动态调整批次——某请求结束立刻填入新请求,从而显著提升吞吐。配合显存抢占、换入换出,引擎能在延迟和吞吐间精细权衡。
两者合起来,相当于为大模型推理装上了「虚拟内存 + 抢占式调度」,把 GPU 利用率从朴素服务的低水平拉到接近饱和,是推理成本断崖式下降的软件根源之一。
三、三条路线:vLLM、TensorRT-LLM、SGLang
| 引擎 | 背后/定位 | 核心打法 | 适合谁 |
|---|---|---|---|
| vLLM | 开源社区(源自学术) | PagedAttention 起家、易用、生态与模型支持最广、事实标准 | 大多数自建推理、社区与初创 |
| TensorRT-LLM | 英伟达 | 深度编译优化、核融合、多 GPU/TPU 无关(绑定英伟达 GPU)、极致性能 | 追求英伟达硬件极限吞吐者 |
| SGLang | 学术+开源 | RadixAttention 前缀缓存、结构化生成、高效调度/运行时 | Agent、多轮、结构化输出等新场景 |
- vLLM 的护城河是社区与广度:开箱即用、支持模型多、迭代快、与 Ray/KServe 等部署生态衔接好,几乎是自建推理的默认起点。它用「好用 + 开放」占据心智,类似推理界的通用平台。
- TensorRT-LLM 的护城河是英伟达纵深:通过编译期优化、专用核、IN-FLIGHT batching、多机并行等手段在自家 GPU 上榨性能。它的代价是更偏工程化、与英伟达工具链绑定——这也是 CUDA 护城河 在推理层的延伸:性能极致,但可移植性弱。
- SGLang 的护城河是前沿调度与场景创新:以 RadixAttention(对公共前缀做层级缓存复用)为代表,在多轮对话、Agent、结构化生成、共享系统提示等「大量重复前缀」的场景里效率突出,体现了引擎竞争从通用吞吐转向场景化优化。
值得注意的是三者快速互相借鉴:好的调度、缓存、量化、投机解码特性很快会被各家吸收,单靠一个算法难以长期领先,真正的壁垒转向社区生态、工程成熟度和与硬件/框架的协同。
四、当前竞争焦点:缓存、投机、PD 分离、多后端
引擎层的创新正沿四条线推进,每一条都直接打在成本上:
- KV Cache 深度治理:分页之上做前缀复用、跨请求共享、分层缓存(显存—主机—SSD)、量化与压缩。长上下文与多轮对话的成本主要由 KV Cache 决定(见 KV Cache 经济性)。
- 投机解码与新注意力:用小模型/草稿一次猜多个 token 再并行验证(投机解码)、以及面向长上下文的稀疏/线性注意力变体,减少串行生成步数;Mamba/线性注意力等新结构若普及会改变缓存与引擎设计。
- PD 分离(Prefill/Decode 解耦):把「吃算力的首 token 预填充」和「吃显存带宽的逐 token 解码」拆到不同实例分别优化,配合 KV Cache 传输与跨层路由,提升整体效率——这也改变集群组网与调度(与 组网拓扑 相关)。
- 多后端与可移植:为对抗厂商绑定,引擎越来越多接入 AMD、自研 ASIC(见 云厂自研 ASIC、AMD 反攻),底层借助 Triton、编译器与可移植运行时(规划 E5/E1),让上层模型与 API 不被锁死在单一硬件。
对商业而言,这些优化最终汇成一个指标:每美元每秒能产出多少合规 token、首 token 延迟多少。它直接决定 MaaS 的毛利和价格战空间(见 API 商品化、从盒子到 token)。
五、变量与置信度判断
| 变量 | 作用方向 | 时间窗 | 置信度 |
|---|---|---|---|
| KV Cache 管理持续优化 | 推理成本继续下降 | 持续 | 高 |
| PD 分离与分层缓存普及 | 改变部署/组网形态 | 1~3 年 | 中高 |
| 引擎多后端支持成熟 | 削弱硬件锁定 | 2~4 年 | 中高 |
| 新架构(线性注意力等)普及 | 改变缓存/调度假设 | 3~5 年 | 中 |
| 算法红利收敛 | 竞争转向生态与工程 | 已开始 | 中高 |
- 未来 1~2 年(高置信度):vLLM 维持最广开源心智,TensorRT-LLM 在英伟达硬件上做性能上限,SGLang 等在 Agent/结构化/前缀复用场景扩张;PD 分离、KV 分层缓存和投机解码成为大厂标配。
- 未来 2~4 年(中高置信度):多后端成熟让同一引擎/模型可跑在 GPU、AMD 与自研 ASIC 上,成为反锁定的关键软件层;单点算法红利收敛,竞争转向工程稳定性、生态与系统协同。
- 长期(中置信度):若线性注意力/新架构大规模落地,KV Cache 的核心地位可能被部分改写,引擎格局随模型架构再洗牌。
六、对不同角色,这意味着什么
- 对自建推理的团队:默认从成熟开源引擎起步,按场景评估前缀复用、PD 分离、量化和投机解码,把每 token 成本而非裸跑分作为指标。
- 对云与 MaaS:引擎是毛利的核心杠杆,深度定制调度与缓存(以及与自研芯片协同)是价格战底气(见 API 商品化)。
- 对硬件厂商:能否被主流开源引擎一等公民式地支持,决定了非英伟达硬件的实际可用性——软件支持是卖卡的前提。
- 对开源生态:推理引擎是少数「开源项目能直接撬动千亿美元成本结构」的软件层,社区生态本身就是护城河。
延伸观察:推理引擎为什么是「成本中心里的利润工程」
在很多技术团队的认知里,推理引擎只是部署模型时的一个组件,但在商业化的 AI 服务里,它实际上是一个直接决定毛利的「利润工程」。可以用一个简化的等式理解:推理业务的边际成本约等于「为服务该请求占用的 GPU 秒数 × GPU 综合成本」,而引擎决定了同样的请求在同样的硬件上占用多少 GPU 秒。当业务量从每天几万次请求涨到几亿次,引擎每提升 10% 的吞吐,对应的就是真金白银的硬件采购和电力节省;在 token 价格被竞争压到接近成本线时(见 API 商品化),引擎优化能力甚至直接决定这项业务是赚钱还是亏损。
利润工程的第一个战场是显存的精细化运营。推理时显存被模型权重、KV Cache 和运行时工作区分割,如何在三者之间动态调配,是一门接近操作系统内存管理的手艺:权重要常驻、KV 要按需扩张、工作区要预留但不能浪费;不同长度、不同阶段(prefill/decode)的请求对显存的需求差异很大,引擎必须在保证不溢出(OOM)的前提下,把显存利用率压到极限。PagedAttention 的分页思路、KV 的量化与分层,本质上都是在「不增加一张卡」的前提下,挤出更多并发容量——显存利用率从 50% 提到 80%,可服务的并发量几乎是数量级逻辑里最关键的改善。
第二个战场是批处理的精细调度。理想的推理引擎要像一个优秀的操作系统调度器:在每个生成步把延迟敏感的短请求、吞吐优先的长请求、正在做首 token 预填充的请求和已经在解码的请求合理拼批,在 SLA(首 token 延迟、每 token 延迟)和总吞吐之间找到最优平衡;还要处理优先级、抢占、长上下文换入换出、多模型混部等现实问题。这些调度策略没有一劳永逸的答案,与业务的请求长度分布、并发模式高度相关,因此真正用得深的大厂,几乎都会在开源引擎之上做大量自研调度——开源提供了优秀的地基,但最赚钱的调优往往是场景私有的。
第三个战场是硬件与引擎的协同设计。引擎不是中立地「跑在硬件上」,它的性能高度依赖底层算子、内存格式、集合通信库和硬件特性。英伟达 TensorRT-LLM 的优势正来自对自家硬件和库的深度利用;而开放引擎(vLLM 等)为了支持多后端,必须投入大量精力在 AMD、自研 ASIC 上做适配和优化。这里存在一个正反馈:引擎对某硬件支持得越好,越多负载跑上去,云厂越愿意采购该硬件,反过来又推动更多引擎投入。这让推理引擎实际上成为芯片能否进入大规模商用的「软件准入层」——一颗芯片即便硬件参数漂亮,若主流引擎不能在其上稳定高效地跑主流模型,就很难真正放量。
从职业与组织角度,这也解释了一个新现象:既懂大模型推理机制、又懂 GPU 体系结构和系统调度的「推理性能工程师」成为极度稀缺的人才。他们的工作横跨模型、编译器、内核和分布式系统,优化收益以真金白银计,却长期没有被清晰地归入传统职位序列。对任何提供大模型服务的公司,建立这样一支「利润工程」团队,价值不亚于模型本身的微调——模型决定服务的上限,推理引擎决定这个上限能不能以赚钱的方式交付给海量用户。
从技术栈纵深看,推理引擎向上连接的是一整套模型服务平台,它本身只是其中最核心的执行内核。一个完整的生产推理系统,还要包含模型仓库与版本管理、多模型/多 LoRA 适配器的动态加载、自动扩缩容与基于 GPU/显存的调度、灰度发布与 A/B、可观测性(每模型每租户的 token、延迟、命中率、成本)、内容安全过滤、配额计费,以及跨多个加速器和机房的统一编排。推理引擎决定「一张卡跑得多快」,服务平台决定「一个组织能不能稳定、可控、可核算地把成千上万张卡运营成服务」。随着企业把 AI 接入核心业务,上层平台能力(尤其多租户隔离、成本归属、合规审计)的重要性甚至会超过单点引擎性能,这也是云厂商 MaaS 和私有化 AI 平台竞争的真正战场。
值得单独强调的是量化和低精度推理这条与引擎深度绑定的技术线。把权重和 KV Cache 从 FP16 降到 FP8、INT8 甚至 INT4,往往能在精度损失可控的前提下显著降低显存占用和计算时间、提升单卡并发,是性价比最高的优化之一。但量化不是免费午餐:不同层、不同模型对精度敏感度不同,需要校准数据、量化感知处理和逐层验证;权重可量化不等于 KV Cache 也可大胆量化;某些场景还会出现难以察觉的质量回归。引擎在这里的价值,是把这些复杂选择产品化——提供一键量化、自动精度调优、混合精度和质量监控,让应用团队不必成为数值专家。谁能在「更低精度」与「质量不塌」之间做到工程上可信赖,谁就能直接改善推理业务的毛利。
从开源生态与竞争格局看,推理引擎还呈现出明显的**「内核开源、商业在周边」**的特征。引擎本身难以形成封闭的收费壁垒——算法迅速扩散、云厂和大厂都有能力自研,因此开源成为聚集用户和事实标准化的最优选择;可持续的价值则沉淀在周边:托管服务(省心、弹性、SLA)、企业级支持与安全合规、针对特定硬件的极致优化、以及与数据/微调/部署工具的端到端整合。这与数据库、大数据系统的开源商业化路径高度相似:开源内核广泛普及,少数公司靠托管和企业能力变现。对硬件厂商,被主流开源引擎深度支持是生死攸关的渠道;对云厂,基于开源内核做自有优化和托管是常规打法;对创业公司,则需要在引擎之上找到比「再做一个 vLLM」更难复制的价值点。理解这一层,才能理解为什么最有影响力的推理引擎往往免费开放,却依然是整个 AI 商业版图中举足轻重的一环。
结语:决定一张卡能卖多少 token 的软件
训练让模型诞生,推理引擎让模型赚钱。同样的 GPU 和模型,朴素服务与经过 PagedAttention、连续批处理、前缀复用、投机解码和 PD 分离优化的引擎之间,是数倍的吞吐与成本差距——这使推理引擎成为大模型商业化最直接的成本阀门。vLLM 用开源与易用做成事实标准,TensorRT-LLM 用英伟达纵深守住性能上限,SGLang 用场景化新调度开辟细分战场,而好创意被迅速抄平意味着长期壁垒在生态与工程。更深远的变化是多后端支持:引擎正在成为让模型挣脱单一硬件锁定的关键软件层,与开放网络、云厂自研芯片一起,把算力市场重新拉向多供应商竞争。
数据口径与延伸
- 数据口径:PagedAttention、连续批处理、KV Cache、投机解码、PD 分离等机制及三大引擎路线,来自开源项目文档、公开论文与工程实践的通用口径。开源项目迭代极快,具体特性与性能以当前版本为准,本文不引用未经核实的跑分。数据截止 2026 年中。
- 相关产业观察:GPU 算力账单、KV Cache 经济性、CUDA 护城河、从盒子到 token、云厂自研 ASIC。
- 同批待写延伸:AI 编译器(E5)、开源框架史(E1)、API 商品化(F9)。
一句话总结:推理引擎是位于 PyTorch 与 CUDA 之间、决定「同样的 GPU 能服务多少并发、产出多便宜 token」的系统软件层,其分水岭是 vLLM 标志性的 PagedAttention——把 KV Cache 像操作系统虚拟内存一样分页管理以消除显存碎片——和连续批处理在每个生成步动态拼请求以避免空等,二者把 GPU 利用率拉到近饱和;当前呈三条路线:vLLM 靠开源、易用和最广模型支持成为事实标准,英伟达 TensorRT-LLM 靠编译与专用核在自家硬件上榨到性能极限但绑定 CUDA,SGLang 靠 RadixAttention 前缀缓存和结构化生成切 Agent/多轮等场景,且彼此快速互相借鉴;竞争前沿已转向 KV Cache 分层复用、投机解码、Prefill/Decode 分离和多后端(AMD/自研 ASIC)可移植,最终都落到「每美元每秒多少 token」这一决定 MaaS 毛利的指标上——引擎因此既是推理成本阀门,也是让模型挣脱单一硬件锁定的关键软件层。