GPU 服务器谁来组装:ODM 如何成为 AI 硬件的隐形总装线
英伟达设计芯片、提供参考架构,但它并不亲手把成千上万台服务器造出来。把 GPU、CPU、主板、内存、电源、散热模块、网卡和机柜,按照英伟达的设计快速、大批量地组装成可交付 AI 服务器的,是一批以台湾厂商为主、加上美国超微(Supermicro)在内的 ODM 和整机厂。它们处在“芯片”和“算力服务”之间一个看似不起眼、却在 AI 时代被迅速放大的环节——谁能更快、更可靠地把整柜整柜的 GPU 服务器造出来,谁就握着算力落地的咽喉。
先说结论
- AI 服务器的复杂度远高于普通服务器:GPU 数量多、供电和散热要求极端、还要做机柜级集成,这显著抬高了整机厂的技术含量和价值占比。
- 产业链分工是“英伟达出芯片+参考设计,ODM/整机厂出工程实现+量产+交付”:超微、富士康工业互联网、广达、纬创、纬颖等是主力。
- 液冷与整柜化(rack-scale)是这一轮最大的变量:整机厂从“装盒子”升级为“交付整柜级供电散热系统”,价值量上升,但工程和质量风险也同步上升。
- 这是一门“低毛利、高周转、强客户绑定”的生意:业绩对英伟达出货节奏和大客户订单极度敏感,能率先跟进新架构者享受爆发,跟不上或质量出问题者会被快速边缘化。
- 台湾 ODM 供应链在全球 AI 服务器组装中占据主导地位,这既是效率优势,也使其成为地缘与供应链风险的焦点。
节点速览:技术 / 玩家 / 成熟度 / 预期
数据截止 2026-09。标尺说明见 AI 产业链总览。
| 象限 | 要点 |
|---|---|
| 关键技术 | ① GPU 服务器整机工程与高密度供电(TRL-4)② 液冷整机/整柜集成(TRL-3~4)③ 机架级(rack-scale)交付(TRL-3~4)④ 快速跟随新 GPU 平台的研发与量产(TRL-4) |
| 主要玩家 | 超微 Supermicro、富士康工业互联网(FII)、广达 Quanta、纬创 Wistron、纬颖 Wiwynn、英业达、神达等;客户:超大云厂、Neocloud、企业 |
| 做到什么程度 | 主流整机厂均已推出多代 GPU 服务器与液冷整机;AI 服务器收入占比快速提升,但毛利率普遍较薄、产能受 GPU 与上游器件分配制约 |
一、AI 服务器和普通服务器,差在哪
先理解为什么“组装服务器”这件在过去被视为低附加值的事,在 AI 时代突然变难、也变重要了。
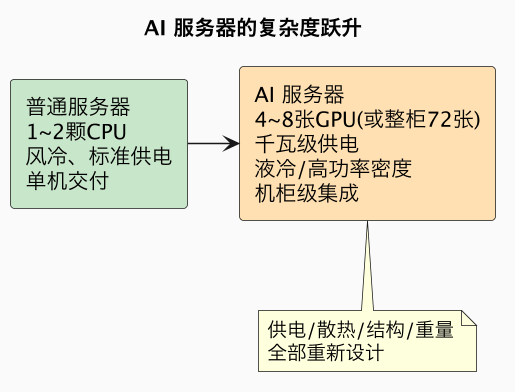
一台普通服务器以一到两颗 CPU 为中心,风冷、标准供电即可,按单机交付。而一台 AI 服务器要搭载多颗功耗逼近千瓦的 GPU,需要解决一系列硬问题:怎样为这些 GPU 提供极大且稳定的电流(电源功率、母排、供电相数全面升级)、怎样把它们产生的热量带走(风冷逼近极限,液冷成为高密度必选)、怎样在有限空间内兼顾结构强度与重量(GPU、散热器、电池都很重)、以及怎样让 GPU 之间、GPU 与网卡之间高速互联。更进一步,当交付单元从“服务器”变成“整柜”(如英伟达的整柜方案),整机厂要负责把计算、交换、供电、散热、布线在机柜层面集成为一个开箱即用的系统。
这些工作的本质,是把英伟达的参考设计工程化、可制造化、可运维化,并在保证质量的前提下以极大规模复制。它要求整机厂具备快速的结构与机电研发、供应链组织、大规模制造和现场交付能力。这也是为什么 AI 服务器虽然仍叫“服务器”,其技术门槛和单台价值量都已不可同日而语。
二、谁在造:超微与台湾 ODM 群
这一层的玩家可以大致分成两类:以超微为代表的、更贴近品牌与快速市场反应的整机厂,和以台湾 ODM 为主、深度承接大客户与英伟达订单的制造巨头。
| 玩家 | 类型 | 特点 |
|---|---|---|
| 超微 Supermicro | 美国整机厂 | 跟进英伟达新平台极快、产品线宽、液冷布局早;增长迅猛但也伴随治理争议 |
| 富士康工业互联网 FII | 巨型 ODM | 制造规模与垂直整合能力强,承接超大客户与整柜大单 |
| 广达 / 纬创 / 纬颖 | 台湾 ODM | 深度绑定北美超大云厂,AI 服务器与机柜经验丰富 |
| 英业达 / 神达等 | 台湾 ODM | 服务器与整机代工,分食 AI 订单 |
英伟达每发布一代新架构,整机厂之间就会展开一场“谁能最快推出量产机型”的竞赛。超微在过去几轮中以“极快跟进、率先供货”著称,常常在英伟达新品发布后很短时间内就拿出多型号整机,靠速度吃到最早、最旺的需求;这推动其营收随 AI 浪潮大幅跃升。但快速扩张也带来考验——超微曾因公司治理、信息披露与审计相关问题引发市场对其内控和财务的关注,这类争议提醒我们:在极端高增长的硬件环节,交付速度和内部管控必须同步,否则速度本身会变成风险。
台湾 ODM 群(富士康工业互联网、广达、纬创、纬颖、英业达等)则是全球 AI 服务器组装的基本盘。它们长期为北美超大云厂提供服务器,具备成熟的研发协同、超大产能、完整的电子与机构供应链,并且越来越多地承接机柜级、液冷化的高价值订单。可以说,英伟达的算力蓝图,很大程度上是由台湾的制造网络变成实物的。这种高度集中也意味着:该供应链的任何风吹草动(产能、地缘、灾害)都会牵动全球 AI 算力的交付节奏。
三、液冷与整柜化:价值上升,风险也上升
这一轮对整机厂最深刻的改变,来自液冷和整柜化两大趋势,它们共同把整机厂的角色从“装服务器的”推向“交付算力系统的”。
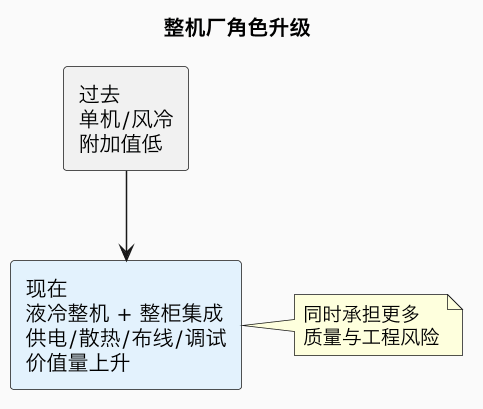
液冷要求整机厂在服务器内部集成冷板、歧管、快接头,并与机房的 CDU、管路对接,任何一处泄漏或接触不良都可能造成昂贵损失;整柜化则要求整机厂在出厂前就把计算节点、交换单元、供电母排、液冷管路、线缆全部装好、测好。这使得整机厂交付的不再是一堆零件,而是一个高度集成、到场快速上电的算力单元,单柜价值量和技术含量都大幅提高,整机厂在价值链中的话语权随之增强。
但价值上升从来伴随风险上升。液冷引入了防漏、防腐、可维护性等新的质量责任;整柜集成意味着任何一个环节(哪怕是一根线缆、一个供电模块)出问题,都可能影响整柜交付;而快速跟进新平台又压缩了验证时间。对整机厂而言,这是一场在“快、稳、便宜”之间走钢丝的竞赛——只快不稳会被质量问题反噬,只稳不快要不到订单,成本控制不好则在薄毛利下无利可图。
四、一门薄毛利、强周期、绑定英伟达的生意
最后看这门生意的商业本质,它有三个鲜明标签。
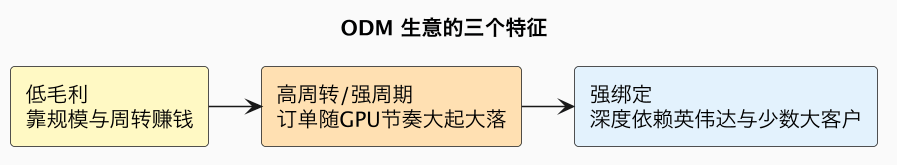
第一是低毛利。ODM/整机环节长期以制造和集成为主,议价能力弱于掌握芯片的英伟达和掌握订单的超大云厂,因此毛利率普遍较薄,靠的是规模和高资产周转。AI 服务器虽然抬高了单机价值,但要把高营收真正转化为利润,仍取决于供应链管理和产品结构。
第二是高周转、强周期。这门生意的景气度几乎完全锚定 GPU 的出货节奏与大客户的资本开支:新平台上市初期,能供货的产能供不应求;一旦出货放量、供给跟上,或大客户调整订单节奏,景气与排产就会变化。因此整机厂的业绩往往呈现强烈的跟随式波动。
第三是强绑定。整机厂深度依赖英伟达的芯片供给与参考设计(能不能拿到足够 GPU、拿到多早,直接决定其出货),也依赖少数超大客户的订单。这种“双重绑定”放大了景气上行期的弹性,也意味着一旦上游分配或下游需求变化,整机厂几乎没有缓冲。理解了这三点,就能明白为什么 AI 服务器组装既是 AI 浪潮里放量最快的环节之一,也是最考验企业经营功底、最容易在周期转折时分化的环节。
常见误区
- 误区:英伟达自己造好 AI 服务器。 英伟达主要提供芯片、网络与参考设计,大规模整机与整柜的制造主要由超微和台湾 ODM 完成。
- 误区:组装服务器技术含量低。 千瓦级供电、液冷和机柜级集成是复杂的机电系统工程,门槛在 AI 时代显著提高。
- 误区:营收暴涨等于高枕无忧。 该环节毛利薄、强周期,且高速扩张会暴露内控、质量与供应链风险。
- 误区:这是可持续的高增长。 增长高度绑定英伟达出货节奏和客户资本开支,本质是跟随式、周期性的放量。
总结
英伟达画出算力蓝图,超微和以台湾厂商为主的 ODM 才是把蓝图变成千万台服务器、一柜柜算力的总装线:液冷与整柜化让它们从低附加值的‘装机商’升级为算力系统集成商,价值与风险一起上升——但低毛利、强周期、深度绑定英伟达和大客户,决定了这仍是一场比速度、比交付、也比内功的苦生意。
相关与延伸
- 上游芯片:英伟达 GPU 产品矩阵
- 散热变量:液冷产业地图
- 建设与机房:AI 数据中心建设
- 下游买家:Neocloud 与 GPU 租赁